预定义过滤器
宏过滤器模型在最底层依赖于真正执行计算以生成新统计量数据的预定义过滤器。顶层宏过滤器和中间各层宏过滤器只是用来组织用户设计某个执行特定计算的过滤器模型的方式。
预定义过滤器可以执行多种计算,包括算术、基础微积分和统计运算。目前,除了宏过滤器之外,没有定义新过滤器模型的开放接口;因此,无法通过过滤器功能执行全新类型的计算。在以下各节中,使用术语 unary(一元)和 binary(二元)分别指需要一个输入和两个输入的过滤器。此外,除非明确提到参数,否则可以认为过滤器没有参数。
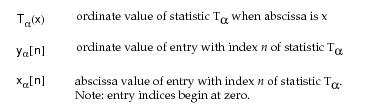
某些过滤器的说明中包含公式和表格,用以解释所执行的计算。这些表格和公式使用下列符号表示法:
算术过滤器
Adder 过滤器
“adder” 过滤器是一个二元过滤器,用于将两个输入统计量 T₀ 和 T₁ 组合,生成第三个统计量 Tout,表示二者之和。
表 138:Adder 过滤器概要
| 输入统计量 | 参数 | 输出 |
|---|---|---|
| 两个可互换的输入 | 无 | 两个输入统计量之和 |
如果两个输入统计量 T₀ 和 T₁ 的条目数完全相同,并且这些条目在横坐标值上彼此对齐,那么只需将横坐标相同的条目的纵坐标值相加即可得到 T_out,如下所示:
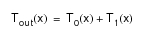
但是,如果两个输入统计量最初并未完全相互对齐,则该过滤器会在相加之前自动应用一种横坐标对齐机制。对齐由两个步骤组成:
- T₀ 和 T₁ 被截断为相同的横坐标最小值和最大值,必要时删除条目。这实质上相当于求两个统计量在水平轴上的交集。
- 对步骤 1 得到的截断统计量进行扩充,以确保每个统计量都包含与另一个统计量相同横坐标处的条目;这需要向每个统计量中插入点。例如,如果两个统计量没有任何共同的横坐标值,那么扩充后它们所包含的条目数将等于二者原始长度之和。当插入一个条目时,其纵坐标值取同一统计量中前一个条目的纵坐标值(即假定该统计量的纵坐标值保持不变,直到下一个原始条目为止)。
对齐完成后,所得的两个统计量可以直接逐条目相加。相加条目时,应用下表所列的规则(由于 T₀ 和 T₁ 的处理方式完全相同,表中相应列标题可以互换,以处理对称情形)。
表 139:Adder 过滤器的条目计算规则
| T₀ | T₁ | T_out |
|---|---|---|
| a¹ | b | a + b |
| a | +infinity | +infinity |
| a | -infinity | -infinity |
| * | undefined | undefined |
| +infinity | +infinity | +infinity |
| -infinity | -infinity | -infinity |
| +infinity | -infinity | undefined |
注 1:(a, b = 实常数,* = 任意值)
Constant Shift 过滤器
“constant_shift” 过滤器是一个一元过滤器,用于对单个输入统计量 T₀ 进行运算,生成第二个统计量 T_out,它是 T₀ 沿垂直轴方向平移  后的结果。平移量
 是一个实数,作为过滤器的参数指定。
表 140:Constant Shift 过滤器概要
| 输入统计量 | 参数 | 输出 |
|---|---|---|
| 单个输入 | shift:沿垂直轴的平移距离 | 输入统计量的平移版本 |
T_out 统计量与 T₀ 具有相同的条目数,并且两个统计量在条目横坐标值上相互对齐。只有纵坐标值相差常数  ,如下所示:
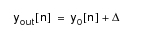
在计算 T_out 的条目时,应用下表所归纳的规则(T₀ 与  两列的内容可以互换,以处理对称情形)。
表 141:Constant Shift 过滤器的条目计算规则
| T₀ |  |
T_out |
|---|---|---|
| a¹ | b | a + b |
| +infinity | a | +infinity |
| -infinity | a | -infinity |
| undefined | * | undefined |
| +infinity | +infinity | +infinity |
| -infinity | -infinity | -infinity |
| -infinity | +infinity | undefined |
注 1:(a, b = 实常数,* = 任意值)
Gain 过滤器
“gain” 过滤器是一个一元过滤器,用于对单个输入统计量 T₀ 进行运算,生成第二个统计量 T_out,它是 T₀ 沿垂直轴方向按因子 K 缩放后的结果。该缩放因子,即 gain K,是一个作为过滤器参数指定的实数。
表 142:Gain 过滤器概要
| 输入统计量 | 参数 | 输出 |
|---|---|---|
| 单个输入 | gain:沿垂直轴的缩放因子 | 输入统计量的缩放版本 |
T_out 统计量与 T₀ 具有相同的条目数,并且两个统计量在条目横坐标值上相互对齐。只有纵坐标值相差因子 K,如下所示:
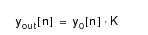
在计算 T_out 的条目时,应用下表所归纳的规则(注意:T₀ 与 K 两列的内容可以互换,以处理对称情形)。
表 143:Gain 过滤器的条目计算规则
| T₀ | K | T_out |
|---|---|---|
| a¹ | b | a · b |
| +infinity | a > 0 | +infinity |
| +infinity | a < 0 | -infinity |
| ±infinity | a = 0 | undefined |
| -infinity | a > 0 | -infinity |
| -infinity | a < 0 | +infinity |
| undefined | * | undefined |
| +infinity | +infinity | +infinity |
| -infinity | -infinity | +infinity |
| -infinity | +infinity | -infinity |
注 1:(a, b = 实常数,* = 任意值)
Multiplier 过滤器
“multiplier” 过滤器是一个二元过滤器,用于将两个输入统计量 T₀ 和 T₁ 组合,生成第三个统计量 T_out,表示二者通过实数乘法所得的积。
表 144:Multiplier 过滤器概要
| 输入统计量 | 参数 | 输出 |
|---|---|---|
| 两个可互换的输入 | 无 | 两个输入统计量相乘所得的积 |
如果两个输入统计量 T₀ 和 T 的条目数相同,并且这些条目在横坐标值上彼此对齐,那么只需将横坐标相同的条目的纵坐标值相乘即可得到 T_out,如下所示:
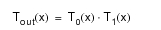
但是,如果两个输入统计量最初并未完全相互对齐,则该过滤器会在相乘之前自动应用一种横坐标对齐机制。这一对齐过程与 “adder” 过滤器所执行的完全相同;对该机制的完整说明见相应小节。
对齐完成后,所得的两个统计量可以直接逐条目相乘。相乘条目时,应用下表所列的规则(由于 T₀ 和 T₁ 的处理方式完全相同,表中相应列标题可以互换,以处理对称情形)。
表 145:Multiplier 过滤器的条目计算规则
| T₀ | T₁ | T_out |
|---|---|---|
| a¹ | b | a · b |
| +infinity | a > 0 | +infinity |
| +infinity | a < 0 | -infinity |
| ±infinity | a = 0 | undefined |
| -infinity | a > 0 | -infinity |
| -infinity | a < 0 | +infinity |
| undefined | * | undefined |
| +infinity | +infinity | +infinity |
| -infinity | -infinity | +infinity |
| -infinity | +infinity | -infinity |
注 1:(a, b = 实常数,* = 任意值)
Reciprocal 过滤器
“reciprocal” 过滤器是一个一元过滤器,用于对单个输入统计量 T₀ 进行运算,生成第二个统计量 T_out,它是将 T₀ 中的纵坐标值取倒数得到的。
表 146:Reciprocal 过滤器概要
| 输入统计量 | 参数 | 输出 |
|---|---|---|
| 单个输入 | 无 | 由倒数值构成的统计量 |
由于可能需要特殊处理来应对 T_out 中的未定义点和不定形式,所得统计量的长度可能与输入统计量不完全相同。特别地,当在输入统计量中遇到纵坐标值为零的条目,并且该条目两侧发生符号变化(即其两侧的条目符号相反)时,该过滤器会生成三个额外的条目:生成两个分别具有正、负符号的无穷大条目,以表示正、负垂直渐近线;第三个条目表示统计量在输入统计量为零的横坐标处无定义。
但一般而言,T_out 统计量的一组条目的横坐标值与 T₀ 的相同。对于倒数有定义的条目,输入与输出统计量之间的关系如下:
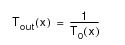
在计算 T_out 的条目时,应用下表所归纳的规则。记号 T₀(x-) 和 T₀(x+) 表示紧邻被取倒数条目之前和之后的条目的纵坐标值。
表 147:Reciprocal 过滤器的条目计算规则
| T₀(x) | T₀(x-) | T₀(x+) | T_out(x) |
|---|---|---|---|
 ¹ |
* | * | 1 / a |
| a = 0 | > 0 | > 0 | +infinity |
| a = 0 | > 0 | < 0 | +infinity undefined -infinity |
| a = 0 | < 0 | < 0 | -infinity |
| a = 0 | < 0 | > 0 | -infinity undefined +infinity |
| +infinity | * | * | 0.0 |
| -infinity | * | * | 0.0 |
| undefined | * | * | undefined |
注 1:(a = 实常数,* = 任意值)
统计过滤器
Average 过滤器
“average” 过滤器是一个一元过滤器,用于对单个输入统计量 T₀ 进行运算,生成第二个统计量 T_out,它表示从第一个条目开始对 T₀ 的纵坐标值所做的滚动均值。
表 148:Average 过滤器概要
| 输入统计量 | 参数 | 输出 |
|---|---|---|
| 单个输入 | 无 | 输入统计量纵坐标值的滚动均值 |
T_out 统计量与 T₀ 具有相同的条目数,并且两个统计量在条目横坐标值上相互对齐。第 i 个 T_out 条目的纵坐标值作为 T₀ 中直至并包括第 i 个条目的所有条目的函数来计算。由于条目索引与横坐标值之间不一定存在一一对应关系,在下列用于第 n 个 T_out 条目值的表达式中采用离散记号。
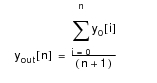
注意上述表达式中分母为条目索引加一,这是因为条目从零开始编号(换言之,n + 1 就是条目数)。
使用此过滤器时,重要的是要了解 +infinity、-infinity 和 undefined 等特殊值是如何处理的。如果在输入统计量中遇到 undefined 值,则在 T_out 中的相同横坐标处创建一个新条目。如果 T₀ 中该条目之前没有任何有定义的条目,则新条目在 T_out 中同样标记为 undefined;反之,新条目只是标记为 T_out 中前一个条目的值。在这两种情况下,undefined 条目都不被视为所计算均值的一部分,因此它们的出现既不影响上述表达式的分子,也不影响其分母。因此,随着 undefined 条目的出现,T_out 的表达式与过滤器实际算法之间可能出现偏差;可以通过从分母中减去索引小于或等于 n 的 undefined 条目数来修正这一偏差。
在 T₀ 中遇到的第一个无穷大值会使 T_out 的值也变为无穷大(符号相同)。过滤器的输出将在所有剩余条目上保持无穷大,除非遇到符号相反的无穷大值,此时 T_out 将变为 undefined,并直至(并包括)最后一个条目都保持 undefined。
下表列出了计算 T_out 值时所应用的规则。由于此过滤器将输入统计量的历史纳入每个条目的计算,表中依赖一个变量 Sₙ,它是 T₀ 中直至并包括第 n 个条目的所有有定义条目纵坐标之和。此外,变量 Uₙ 定义为 T₀ 中索引小于或等于 n 的 undefined 条目数。
表 149:Average 过滤器的条目计算规则
| Sₙ₋₁ | T₀ | Uₙ₋₁ | Sₙ | Uₙ | T_out |
|---|---|---|---|---|---|
| a¹ | b | c | a + b | c | (a + b) / (n+1-c) |
| a | +infinity | c | +infinity | c | +infinity |
| a | -infinity | c | -infinity | c | -infinity |
| 0.0 | undefined | c = n | a | c+1 | undefined |
| a | undefined | c < n | a | c+1 | a / (n - c) |
| +infinity | b | c | +infinity | c | +infinity |
| +infinity | -infinity | c | undefined | c | undefined |
| -infinity | b | c | -infinity | c | -infinity |
| -infinity | +infinity | c | undefined | c | undefined |
| +infinity | undefined | c | +infinity | c+1 | +infinity |
| -infinity | undefined | c | -infinity | c+1 | -infinity |
| undefined | * | c | undefined | c or c+1 | undefined |
注 1:(a, b, c = 实常数,* = 任意值)
Time Average 过滤器
“time_average” 过滤器是一个一元过滤器,用于对单个输入统计量 T₀ 进行运算,生成第二个统计量 T_out,它表示从第一个条目开始对 T₀ 的纵坐标值所做的连续滚动平均。此过滤器与前面描述的 “mean” 过滤器之间的区别在于,条目值不是等权重的,而是按其自身横坐标与后一个条目横坐标之差加权。该过滤器名为 “time average”,是因为它常被用于横坐标表示时间的统计量;不过,它同样适用于其他类型的统计量。
表 150:Time Average 过滤器概要
| 输入统计量 | 参数 | 输出 |
|---|---|---|
| 单个输入 | 无 | 输入统计量纵坐标值的连续滚动平均 |
T_out 统计量与 T₀ 具有相同的条目数,并且两个统计量在条目横坐标值上相互对齐。第 i 个 T_out 条目的纵坐标值作为 T₀ 中直至并包括第 i 个条目的所有条目的函数来计算。由于条目索引与横坐标值之间不一定存在一一对应关系,在下列用于第 n 个 T_out 条目值的表达式中采用离散记号。
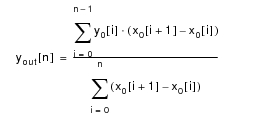
关于对特殊纵坐标值 +infinity、-infinity 和 undefined 的处理,此过滤器的行为与前面描述的 “mean” 过滤器类似。具体而言,undefined 值基本上被忽略:上述表达式的分子不会因它们的出现而改变;并且 undefined 区间的宽度不计入分母项。此外,输入统计量中的无穷大纵坐标值会使输出统计量所有后续条目产生相同符号的无穷大值。但是,如果遇到符号不同的无穷大值,T_out 将变为 undefined。关于时间平均过滤器实现方式的一般理解,请参见 Average 过滤器。
Moving Average 过滤器
“moving_average” 过滤器是一个一元过滤器,用于对单个输入统计量 T₀ 进行运算,生成第二个统计量 T_out,它表示在指定宽度的区间上对 T₀ 的纵坐标值所做的连续平均。这些区间沿 T₀ 横坐标的范围滑动,使得 T_out 表示最近一个区间上的平均。区间宽度由过滤器唯一的参数设定,该参数称为 window。
表 151:Moving Average 过滤器概要
| 输入统计量 | 参数 | 输出 |
|---|---|---|
| 单个输入 | window:用于设定平均区间宽度的正实数 | 在最近一个宽度等于 “window” 的区间上对输入统计量纵坐标值所做的连续平均 |
当 window 参数相对于输入统计量条目之间典型的横坐标间距设为较大值时,“moving_average” 过滤器提供一种平滑的结果,在局部基础上对值进行平均。然而,window 参数可以选择为任意正数大小,包括极小的值,这使得相邻点可能相距超过一个 window。在这种情况下,移动平均仍应表现出在一个 window 周期内的变化,因为它试图模拟连续的平均计算。为了改善结果的平滑性,“moving_average” 过滤器可能在输出统计量中插入额外的采样点。因此,T₀ 与 T_out 的长度之间不一定存在直接对应关系。
横坐标最小距离的正常取值为 min_dt/2,其中 min_dt 等于原始统计量中横坐标点之间的最小距离。这会使新统计量具有确定的条目数。不过,移动平均过滤器将新统计量的条目数限制为不超过原始条目数的 10 倍。发生这种情况时,x 轴增量会被放大,从而降低 x 轴上的点密度并减少总点数。
T_out 值的一般计算相当复杂,针对特殊的 undefined 值和无穷大值涉及许多特殊情形。由于该算法的复杂性,本手册不像对其他预定义过滤器那样给出完整说明。
不过,以下陈述对描述该过滤器在大多数情况下的行为是有用的:
- “moving_average” 过滤器的计算本质上由条目纵坐标和横坐标的加法与乘法构成。关于无穷大和 undefined 条目的特殊值,采用与其他平均过滤器相同的基本规则,即:
- 两个相同符号的无穷大值相加仍得到相同符号的无穷大值。
- 两个符号相反的无穷大值相加得到 undefined 值。
- 输入统计量中的 undefined 纵坐标值基本上被忽略。
- 无穷大值与有限值相乘得到符号适当的无穷大值。
- 鉴于 “moving_average” 过滤器会选择一组新的横坐标点来计算 T_out 的值,下列一般表达式表示该过滤器所执行的计算。该表达式表明,移动平均是通过对从 x_out[n] - W 到 x_out[n] 的 window 所包含的所有区间上的输入统计量进行积分来计算的。由于 T_out 与 T₀ 不对齐,window 的边界可能不会与 T₀ 中的条目横坐标完全重合。因此,分子中需要两个额外的项来计算这些“部分”区间的贡献。注意,由于平均是在固定 window 上进行的,分子就是与过滤器 window 参数对应的常数。与其他平均过滤器一样,这里给出的一般表达式在输入统计量出现 undefined 点的情况下并不完全准确。
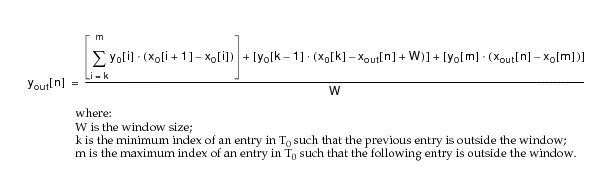
- “moving_average” 过滤器使用后向积分。因此,对于输出统计量中与 window 宽度横坐标跨度相等的初始部分,T_out 所反映的平均值不是相对于一个完整的 window,而是相对于一个被截断的 window。这个 window 逐渐增长,直到达到 window 参数指定的完整大小。
Sample Sum 过滤器
“sample_sum” 过滤器是一个一元过滤器,用于对单个输入统计量 T₀ 进行运算,生成第二个统计量 T_out,它表示从第一个条目开始对 T₀ 的纵坐标值所做的累计总和。
表 152:Sample Sum 过滤器概要
| 输入统计量 | 参数 | 输出 |
|---|---|---|
| 单个输入 | 无 | 输入统计量纵坐标值的累计总和 |
T_out 统计量与 T₀ 具有相同的条目数,并且两个统计量在条目横坐标值上相互对齐。第 i 个 T_out 条目的纵坐标值作为 T₀ 中直至并包括第 i 个条目的所有条目的函数来计算。由于条目索引与横坐标值之间不一定存在一一对应关系,在下列用于第 n 个 T_out 条目值的表达式中采用离散记号。
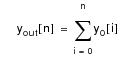
使用此过滤器时,重要的是要了解 +infinity、-infinity 和 undefined 等特殊值是如何处理的。如果在输入统计量中遇到 undefined 值,则在 T_out 中的相同横坐标处创建一个新条目。如果 T₀ 中该条目之前没有任何有定义的条目,则新条目在 T_out 中同样标记为 undefined;反之,新条目只是标记为 T_out 中前一个条目的值。在这两种情况下,undefined 条目都不被视为所计算总和的一部分,因此它们的出现基本上被忽略。
在 T₀ 中遇到的第一个无穷大值会使 T_out 的值也变为无穷大(符号相同)。过滤器的输出将在所有剩余条目上保持无穷大,除非遇到符号相反的无穷大值,此时 T_out 将变为 undefined,并直至(并包括)最后一个条目都保持 undefined。
下表列出了计算 T_out 值时所应用的规则。由于此过滤器将输入统计量的历史纳入每个条目的计算,表中使用 T_out 的前一个值作为出现在表左侧的输入。注意,表左侧两列的内容可以互换,以处理对称情形。
表 153:Sample Sum 过滤器的条目计算规则
| T_out[n-1] | T₀[n] | T_out[n] |
|---|---|---|
| a¹ | b | a + b |
| a | +infinity | +infinity |
| a | -infinity | -infinity |
| +infinity | -infinity | undefined |
| * | undefined | *(即保持不变) |
注 1:(a, b = 实常数,* = 任意值)
微积分运算符及相关分析过滤器
Differentiator 过滤器
“differentiator” 过滤器是一个一元过滤器,用于对单个输入统计量 T₀ 进行运算,生成第二个统计量 T_out,它表示 T₀ 对其横坐标变量的导数。
表 154:Differentiator 过滤器概要
| 输入统计量 | 参数 | 输出 |
|---|---|---|
| 单个输入 | 无 | 表示输入统计量对其横坐标变量的导数的统计量 |
导数使用纵坐标和横坐标的前向差分来计算。这两个量的比值在每个区间上给出导数的正确值,其前提是统计量表示一个连续的、分段线性的函数(即当以线性绘制样式绘制该统计量时,其实际表现如图所示)。如果该统计量实际上表示另一种类型的连续函数,那么只要横坐标点之间的间距足够小,此过滤器仍能提供导数的准确估计。过滤器一般执行的计算如下(包含特殊值的条目除外):
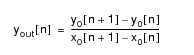
输入与输出统计量在条目横坐标值上对齐。但是注意,使用上述表达式,“differentiator” 过滤器无法为输入统计量的最后一个条目计算值,因为没有后一个条目来计算所需的差分。因此,T_out 比 T₀ 少一个条目。
在计算 T_out 的条目时,应用下表所归纳的规则。
表 155:Differentiator 过滤器的条目计算规则
| y₀[n+1] - y₀[n] | x₀[n+1] - x₀[n] | y_out[n] |
|---|---|---|
| a¹ |  |
a / b |
| a | ±infinity | 0.0 |
| * | 0 | undefined |
| undefined | * | undefined |
| * | undefined | undefined |
| +infinity | a > 0 | +infinity |
| +infinity | a < 0 | -infinity |
| -infinity | a > 0 | -infinity |
| -infinity | a < 0 | +infinity |
注 1:(a, b = 实常数,* = 任意值)
Integrator 过滤器
“integrator” 过滤器是一个一元过滤器,用于对单个输入统计量 T₀ 进行运算,生成第二个统计量 T_out,它表示 T₀ 对其横坐标变量的积分。
表 156:Integrator 过滤器概要
| 输入统计量 | 参数 | 输出 |
|---|---|---|
| 单个输入 | 无 | 表示输入统计量对其横坐标变量的积分的统计量 |
积分统计量按输入统计量下方的面积来计算,采用统计量的 “sample-and-hold”(采样保持)解释。换言之,对于某个条目,统计量与水平轴之间的面积由到下一个条目为止的横坐标区间宽度乘以该条目的纵坐标值得到。过滤器一般执行的计算如下(对包含特殊值的条目有特殊处理除外):
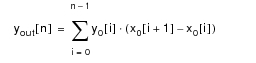
输入与输出统计量在条目横坐标值上对齐。输出统计量可能比输入统计量多一个条目,以计入后者最后一个条目所贡献的面积。这取决于输入统计量的统计量结束标记的横坐标是否超过最后一个具有普通值的条目的横坐标。
“integrator” 过滤器对特殊值的处理方式与 “mean”、“time_average” 和 “sample_sum” 等其他累积过滤器基本相同。这主要是指:相加符号相反的无穷大值得到 undefined 值;输入统计量中相加的 undefined 条目基本上被忽略(即在这种情况下,这些条目被视为其纵坐标值为零 sine 它们对积分没有任何贡献)。下表列出了计算 T_out 值时所应用的规则。由于此过滤器将输入统计量的历史纳入每个条目的计算,表中使用 T_out 的前一个值作为出现在表左侧的输入。注意,表左侧两列的内容可以互换,以处理对称情形。
表 157:Integrator 过滤器的条目计算规则
| y_out[n-1] | y₀[n-1] | x₀[n] - x₀[n-1] | y_out[n] |
|---|---|---|---|
| a¹ | b | c | a + bc |
| a | ±infinity | c | ±infinity |
| a | undefined | c | a |
| +infinity | b | c | +infinity |
| -infinity | b | c | -infinity |
| +infinity | -infinity | c | undefined |
| -infinity | +infinity | c | undefined |
| undefined | * | c | undefined |
注 1:(a, b, c = 实常数,* = 任意值)
Exponentiator 过滤器
“exponentiator” 过滤器是一个一元过滤器,用于对单个输入统计量 T₀ 进行运算,生成第二个统计量 T_out,它是将 T₀ 中的纵坐标值取固定幂得到的。该幂值通过过滤器唯一的参数 exponent 指定。
表 158:Exponentiator 过滤器概要
| 输入统计量 | 参数 | 输出 |
|---|---|---|
| 单个输入 | exponent:用作幂运算“幂”的实数 | 由输入统计量的值以 exponent 为幂乘方所得的统计量 |
由于可能需要特殊处理来应对 T_out 中的未定义点和不定形式,所得统计量的长度可能与输入统计量不完全相同。特别地,当指定的 exponent 为负时,可能需要插入额外的点。更多信息请参见 Reciprocal 过滤器。
但一般而言,T_out 统计量的一组条目的横坐标值与 T₀ 的相同。对于乘方结果有定义的条目,输入与输出统计量之间的关系如下:
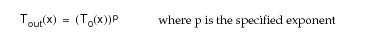
下表列出了 exponent 为正或零时计算 T_out 条目所应用的规则。对于 exponent 为负的情形,可以用本表确定一个中间结果,随后应用 reciprocal 过滤器的计算规则。
表 159:Exponent 过滤器的条目计算规则(指数为非负或无穷)
| T₀(x) | exponent | T_out(x) |
|---|---|---|
 ¹ |
 |
a^b |
| a < 0 | b | a^b |
| a < 0 | b 非整数 | undefined |
| a > 1.0 | -infinity | 0.0 |
| a > 1.0 | +infinity | +infinity |
| a = 1.0 | ±infinity | 1.0 |
| a < 1.0 | +infinity | 0.0 |
| a < 1.0 | -infinity | +infinity |
| a < 0 | ±infinity | undefined |
| ±infinity | 0.0 | 1.0 |
| +infinity | b > 0.0 | +infinity |
| -infinity |  |
+infinity |
| -infinity | b 奇整数 | -infinity |
| +infinity | +infinity | +infinity |
| +infinity | -infinity | undefined |
| -infinity | b 非整数 | undefined |
| -infinity | +infinity | undefined |
注 1:(a, b = 实常数,* = 任意值)
Logarithm 过滤器
“logarithm” 过滤器是一个一元过滤器,用于对单个输入统计量 T₀ 进行运算,生成第二个统计量 T_out,它是计算 T₀ 纵坐标条目的以 10 为底的对数(即常用对数)得到的。
表 160:Logarithm 过滤器概要
| 输入统计量 | 参数 | 输出 |
|---|---|---|
| 单个输入 | 无 | 由输入统计量的值的以 10 为底的对数构成的统计量 |
T_out 统计量的条目数与 T₀ 完全相同,并且两个统计量的条目在水平轴上相互对齐。对数函数并非对所有值都有定义,这意味着 T_out 中可能出现带有特殊值的条目。不过,对于对数结果有定义的条目,输入与输出统计量之间的关系如下:
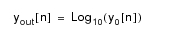
下表列出了计算 T_out 条目时所应用的规则。
表 161:Logarithm 过滤器的条目计算规则
| T₀(x) | T_out(x) |
|---|---|
| a > 0.0¹ | log₁₀(a) |
| a = 0.0 | -infinity |
| a < 0.0 | undefined |
| +infinity | +infinity |
| -infinity | undefined |
| undefined | undefined |
注 1:(a = 实常数,* = 任意值)
其它过滤器
Abscissa 过滤器
“abscissa” 过滤器是一个一元过滤器,用于对单个输入统计量 T₀ 进行运算,生成第二个统计量 T_out,其纵坐标值就是 T₀ 各条目的横坐标值。
表 162:Abscissa 过滤器概要
| 输入统计量 | 参数 | 输出 |
|---|---|---|
| 单个输入 | 无 | 由输入统计量的横坐标值构成的统计量 |
T_out 统计量的条目数与 T₀ 完全相同,并且两个统计量的条目在水平轴上相互对齐。注意,只有输入统计量的横坐标值与该过滤器所执行的计算有关,如连接输入与输出统计量的下列公式所示。
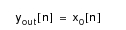
Delay Element 过滤器
“delay_element” 过滤器是一个一元过滤器,用于对单个输入统计量 T₀ 进行运算,生成第二个统计量 T_out,它是将 T₀ 沿水平轴平移固定量得到的。平移距离由过滤器唯一的参数 delay 控制。delay 取正值会使统计量沿正横坐标方向平移。
表 163:Delay Element 过滤器概要
| 输入统计量 | 参数 | 输出 |
|---|---|---|
| 单个输入 | Delay:统计量平移的量 | 与输入统计量条目相同、但沿横坐标方向平移的统计量 |
T₀ 与 T_out 的长度相同,T_out 的条目计算如下(注意:所有特殊值只是被平移到新的横坐标处)。
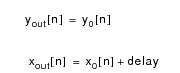
Glitch Notch 过滤器
“glitch_notch” 过滤器是一个一元过滤器,用于对单个输入统计量 T₀ 进行运算,生成第二个统计量 T_out,其方式是消除具有相同横坐标值的多个条目的出现(这种出现称为 glitch)。T_out 通过从 T₀ 复制条目来构造。但是,如果在 T₀ 中遇到一段横坐标相同的连续条目(至少两个),则忽略该序列中除最后一个条目之外的所有条目,并将最后一个条目复制到 T_out。因此,T_out 是无 glitch 的。
表 164:Glitch Notch 过滤器概要
| 输入统计量 | 参数 | 输出 |
|---|---|---|
| 单个输入 | 无 | 与输入统计量条目相同、但每个不同横坐标处至多只有一个条目的统计量 |
由于此过滤器的目的是消除条目以确保每个横坐标值处条目的唯一性,T_out 的长度可能小于 T₀。如果 T₀ 中不存在 glitch,则 T_out 只是 T₀ 的一个完全相同的副本。
Limiter 过滤器
“limiter” 过滤器是一个一元过滤器,用于对单个输入统计量 T₀ 进行运算,生成第二个统计量 T_out,它是将 T₀ 的纵坐标值约束在指定范围内得到的。该范围的下限和上限分别由称为 min_val 和 max_val 的过滤器参数控制。二者都是该范围的包含性边界。
“limiter” 过滤器通过对 T₀ 执行变换来生成 T_out:将条目复制到 T_out 的同时对其进行 clipping(限幅),以确保它们位于指定区间之内。纵坐标值超过 max_val 的条目被修改为具有值 max_val。类似地,纵坐标值小于 min_val 的条目被修改为具有值 min_val。
表 165:Limiter 过滤器概要
| 输入统计量 | 参数 | 输出 |
|---|---|---|
| 单个输入 | Min_val:垂直范围的下界 Max_val:垂直范围的上界 |
与输入统计量条目相同、但被约束在指定范围 [min_val, max_val] 内的统计量 |
T₀ 与 T_out 的长度相同,并沿水平轴相互对齐。T_out 的条目按下图所示计算。undefined 条目不受此过滤器的变换。正无穷大纵坐标被限幅到上界,负无穷大纵坐标被限幅到下界。
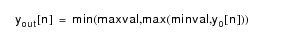
Time Window 过滤器
“time_window” 过滤器是一个一元过滤器,用于对单个输入统计量 T₀ 进行运算,生成第二个统计量 T_out,它是消除所有横坐标值位于指定范围之外的条目得到的。该范围的下限和上限分别由称为 min_time 和 max_time 的过滤器参数控制。这两个边界本身也包含在范围内。之所以使用名称 min_time 和 max_time,是因为此过滤器常被用于以时间为横坐标变量的统计量和/或输出向量。不过,“time window” 过滤器同样适用于其他类型的统计量。
“time_window” 过滤器通过对 T₀ 执行变换来生成 T_out:只将横坐标位于指定范围内的条目复制到 T_out。横坐标值超过 max_time 的条目被丢弃,横坐标值小于 min_time 的条目同样被丢弃。其余条目未经修改地复制到 T_out。
表 166:Time Window 过滤器概要
| 输入统计量 | 参数 | 输出 |
|---|---|---|
| 单个输入 | Min_time:水平范围的下界 Max_time:水平范围的上界 |
仅由 T₀ 中横坐标值位于闭区间 [min_val, max_val] 内的条目构成的统计量 |
Value Notch 过滤器
“value_notch” 过滤器是一个一元过滤器,用于对单个输入统计量 T₀ 进行运算,生成第二个统计量 T_out。T_out 通过消除所有近似等于参数值的条目得到。“近似等于”定义为落在由指定纵坐标值(x)和 “value_notch_filter_tolerance” 偏好值(tol)共同确定的范围之内。如果 T₀ 大于 x - tol 且小于 x + tol,则该条目被消除;否则 T₀ 直接复制到输出统计量 T_out。(“value_notch_filter_tolerance” 的默认值为 10⁻⁹。)
表 167:Value Notch 过滤器概要
| 输入统计量 | 参数 | 输出 |
|---|---|---|
| 单个输入 | value:纵坐标为该值的条目将被剔除 | 仅由 T₀ 中纵坐标值比指定值高或低出某个数值(该数值由 “value_notch_filter_tolerance” 偏好定义)的条目构成的统计量 |