过滤器操作
除了直方图和概率分布函数之外,Results Browser 还提供了使用多种数学运算符转换和组合统计量数据的能力,包括算术、微积分和统计函数。统计量和/或向量可以通过称为过滤器的计算框图来生成并绘制新的统计量。过滤器使用 Filter Editor 开发。在 Results Browser 中,通过从过滤器下拉菜单中选择某个过滤器,即可将该过滤器应用于某个统计量。
过滤器模型
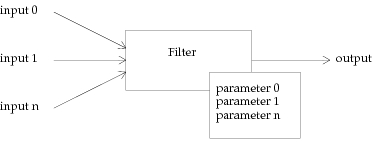
过滤器模型是对某一计算的规格说明,该计算作用于一个或多个统计量,并恰好创建一个新统计量。抽象地看,过滤器可以被视为一个具有已定义输入集合和计算其输出的算法的系统。除了输入和输出之外,过滤器还带有与其算法执行有关的参数。在 Filter Editor 中创建过滤器模型时,会为输入和参数命名。
图 290:过滤器的抽象模型
过滤器模型结构
在内部,过滤器具有层次结构,即它可以由其他从属过滤器组成。这些过滤器又可以由其他从属过滤器组成,依此类推。由其他过滤器组成的过滤器称为宏过滤器。最终,在最低层次上,所有宏过滤器模型都必须由 Modeler 提供的预定义过滤器构成。可用的预定义过滤器在预定义过滤器中描述。
为了构成宏过滤器,现有的过滤器模型被用来创建从属过滤器,并通过过滤器连接进行连接。过滤器连接定义在一个过滤器的输出与另一个过滤器的输入之间,用以指定统计量数据的流动。每个过滤器只有一个输出,但该输出可以支持到任意数量目标过滤器的出站连接。不过,每个过滤器输入最多只能接收一个连接。
图 291:过滤器的层次结构
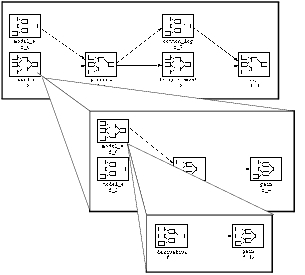
编译过滤器模型时,必须恰好留下一个从属过滤器的输出不连接。该输出成为外层宏过滤器的输出。因此,输出未连接任何连接的从属过滤器就是最后执行的最终从属过滤器;其输出数据随后提供给外层过滤器或 Results Browser,以创建新面板。
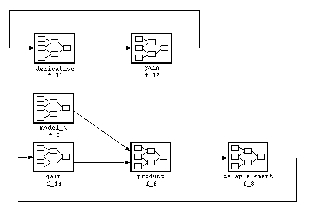
过滤器连接不能用于在过滤器模型内创建反馈路径。反馈路径是单个连接或连接序列,它们会造成这样的数据流:在一次过滤器执行中,某个过滤器输入会多次收到数据。反馈条件在 Filter Editor 的编译过程中被检测(参见过滤器执行)。下面给出了一些反馈路径的示例。
图 292:过滤器模型中反馈的示例
除了阻止反馈路径之外,Filter Editor 还禁止在宏过滤器内循环包含过滤器模型。换句话说,过滤器模型不得出现在其自身定义的任何深度层次上。因此,如果过滤器模型 A 包含模型 B 作为从属过滤器,而模型 B 又包含模型 C,那么模型 B 或 C 再包含模型 A 就是非法的。
过滤器输入与参数的提升
过滤器的参数和输入可以通过一种称为提升的机制,从从属过滤器“向上传递”给外层宏过滤器。过滤器模型的提升与 Process、Node 和 Network 域中建模属性的提升类似。关于提升概念在这些域中的描述,请参见第 4 章“建模框架”(第 80 页)。提升机制使较低层次对象或模型的属性成为外层更高层次对象的属性。
就过滤器而言,数值参数可以被设置为提升状态,从而自动成为宏过滤器的参数。也就是说,当宏过滤器作为更高层次宏过滤器的一部分被部署时,或者当它在 Results Browser 中执行时,被提升的过滤器参数将出现在该宏过滤器的参数菜单中。
从属过滤器的输入只需保持不连接即可被提升。与被提升的参数一样,被提升的输入自动成为更高层次宏过滤器的输入。输入的提升体现在:当该宏过滤器作为组件用于更高层次的宏过滤器模型时,它会出现在该宏过滤器的连接输入菜单中。此外,当宏过滤器在 Results Browser 中执行时,会引用被提升的输入,以提示用户选择输入统计量。
过滤器执行
只有当过滤器模型此前已在 Filter Editor 中被编译过时,才能在 Results Browser 中执行该过滤器以作用于统计量。宏过滤器要作为组件用于更高层次的宏过滤器,也必须成功编译。编译过滤器模型时,所有被提升的输入和参数都必须命名。这些名称用于在过滤器模型被使用时标识其输入和参数,既用于在 Results Browser 中执行,也用于在其他过滤器模型中部署。
执行宏过滤器时,所有未连接的过滤器输入都必须提供统计量或来自输出向量文件的向量。这些数据连同被提升参数的赋值,共同构成过滤器计算的输入,并直接或间接触发所有从属过滤器的计算。过滤器执行方法遵循数据流范式,即每个从属过滤器只有在它的所有连接都收到数据之后才能执行,数据或者直接来自外层过滤器的输入,或者来自另一个从属过滤器。从属过滤器执行后,其计算产生的新统计量从其输出传送到每个已连接的过滤器输入。这反过来可能触发目标从属过滤器执行,前提是它们的其他输入也已收到数据。
当所有从属过滤器都执行完毕时,执行结束。最后执行的过滤器其输出不得连接任何连接。它产生的输出转而提供给 Results Browser,以纳入新的面板。