计算仿真结果的置信度
如第 10 章"Simulation Design"第 375 页所解释的,包含随机行为的系统模型,其结果取决于随机数生成器的初始种子。由于某个特定的随机种子选择有可能导致异常的、不具代表性的行为,因此让每个模型配置都使用多个随机数种子运行是很重要的,这样才能确定标准的、典型的行为。这里应用的基本原理是:如果典型行为存在,并且执行了许多次相互独立的试验,那么这些试验中的绝大多数很可能落在标准值的邻近范围内。
在进行包含随机过程的仿真时,仿真设计者必须面对的重要问题之一,是决定运行多少个使用不同种子的试验,才能获得足够的数据来对系统的典型行为作出判断。当然,仿真设计者永远无法绝对确定所得结果是具代表性的,因为可能存在"运气不好"的情形:所选的全部或大多数随机种子都导致异常行为。然而,随着所选种子数量的增多,这种情形发生的可能性会越来越小,尤其是考虑到标准行为本应比异常行为更频繁地被观察到。这就引出了这样一种观念:通过确保执行足够数量的仿真,力求在仿真研究所得的结果上达到某种置信水平。
置信区间
统计学领域提供了基于一次或一系列随机试验来计算估计值置信度的方法。这些方法也常被应用于实测值存在误差的应用科学领域,通过进行多次测量来试图限定误差的大小。Results Browser 在这一方面提供了一项基本能力:自动计算并显示面板中已有统计量的置信区间。这一能力由 Edit Graph Properties 对话框中的 Show Confidence Interval 复选框支持。
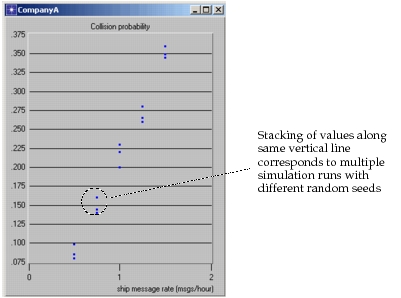
Results Browser 计算的置信区间针对的是一组条目的平均纵坐标值。就这一操作而言,条目集合由位于相同横坐标处的条目构成。这种计算置信区间的方法主要为多种子参数化实验中收集的标量数据的置信度估计提供支持;在这类实验中,一个或多个输入参数被变化,而对每个输入参数值,使用多个随机数种子来获得多个输出参数。这种仿真研究所得的统计量类型(在进行置信区间计算之前)由下面的示例说明。条目在垂直方向上的"列"对应于通过变化随机种子并保持某个输入参数固定值而运行的多次实验。
图 279:由多次仿真运行的标量数据构成的统计量
假设已经使用不同的随机数种子对某个系统运行了多次仿真,以获得统计量 X 的 N 个样本。尽管 X 可能取许多值,而且 X 的确切分布未知,我们仍可以定义一个值 μ,即随机变量 X 的真实均值。可以把 μ 理解为:如果可能运行如此大量的仿真以获得一个极其庞大的 X 样本集合,该样本集合的均值。μ 作为 X 的真实均值之所以有意义,是因为它代表了被建模系统相对于统计量 X 的典型行为。
由于通常不可能运行极其大量的仿真来确定 μ(理论上需要无限多次),因此值得确定 N 样本集合的均值  逼近 μ 的精确程度。这决定了能否有把握地使用该值
 来对系统的典型行为作出判断。
用于确立对某个  测量结果的置信度的基本原理称为中心极限定理。为理解这一定理,考虑这样的实验:收集 X 的 N 个样本,并计算这 N 个样本的平均值
 ;换句话说,
 被视为该实验一次试验的结果。然后考虑该实验可以重复执行许多次,而所得的统计量
 拥有它自己的分布。中心极限定理指出:无论 X 的实际分布是什么(这是一个很重要的推广,因为关于 X 可能知之甚少),随着样本数 N 变得很大,随机变量
 的分布趋近于一个均值为 μ 的正态随机变量的分布——μ 与随机变量 X 本身的均值相同。该定理还指出:如果 X 的真实方差为
 ,则统计量
 的方差为
 。
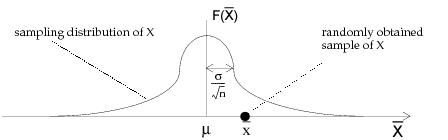
这一定理在确立测量置信度方面的用处在于:只要采集足够的样本,就可以对一个正态分布(其性质是已知的)进行处理,而不必处理 X 的未知分布。假设已经选定了足够大的样本量 N,那么从一系列仿真中得到的样本  (变量
 的样本)就可以放到
 的假想抽样分布上,如下图所示。
图 280: 的抽样分布
由于  的分布是正态的,随机样本
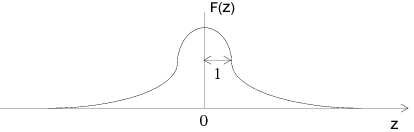
 落在距 μ 某一距离内的概率是可以计算的。通常这一距离以随机样本与均值之间相隔的标准差数来度量。这样便定义了一个"标准化正态变量"
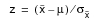 ,其标准差为 1、均值为 0,如下图所示。
图 281: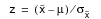 的抽样分布
如果定义正值 z_α 使得 Prob (-z_α < z < z_α) = α,那么通过代入 z 可以得出下面的陈述(注:大多数标准统计学教科书都提供把 α 映射到 z_α 或等价变量的数表)。这一陈述可以简单地理解为定义了  落在距 μ 某一距离内的概率,其依据是
 的分布为正态这一事实。
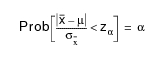
反过来,这一陈述也可以理解为给"真实均值 μ 落在距随机样本  某一距离内"这一条件赋予一个概率,如下图所示(注意,
 的标准差是依据中心极限定理用 X 的标准差来表示的)。
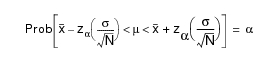
这一陈述引入了 μ 的置信区间的概念。μ 的置信区间定义为实数区间 [Θ_L, Θ_R],使得 μ 落在该区间内的概率具有某个特定值 α。该区间称为 μ 的 100α 百分比置信区间。换句话说,如果 α = 0.95,该区间就称为 μ 的 95% 置信区间,因为有 95% 的确定性认为 X 的真实均值落在该区间的边界之内。从上面的不等式可以清楚地看出,置信区间的界限可以如下表示:
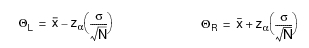
从这些定义可以清楚看出:置信水平越高,置信区间越宽;这是合理的,因为要对"真实均值落在某个特定区间内"达到很高的置信水平,就必须对该区间作出限制更少的假设;类似地,如果愿意接受较低的置信水平,就可以对区间作出约束更强的假设。一个极端的例子是:可以有 100% 的信心认为 μ 位于负无穷与正无穷之间。在实践中,通常选择几个特定的置信水平,如下表所示。
表 136:若干选定的置信水平
| 置信水平 α | z_α |
|---|---|
| 99% | 2.575 |
| 98% | 2.327 |
| 95% | 1.96 |
| 90% | 1.645 |
| 80% | 1.282 |
对 μ 的置信区间表达式也可以看作提供了关于所需试验次数 n 的信息:为了以某种置信水平确信对 μ 的估计误差小于指定值,必须执行的试验次数。通过重新整理上面的方程即可清楚地看到这一点。
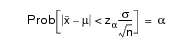
由于  是 μ 的估计量,误差就是这两个值之差的绝对值。于是,如果 e 是在置信度 α 下误差的上界,则所需样本数 n 由下式给出:
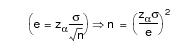
小样本置信度估计
注意,上面关于均值 μ 的置信限表达式依赖于对标准差  的了解。然而,这一量未必是已知的,因为 X 的实际分布并不已知。如果样本量 N 足够大(一般 >= 30),可以用样本方差代替真实方差来计算置信区间。
对于方差未知且样本量较小的情形,采用的方法与上面描述的类似,但基于 T 分布而不是正态分布。T 分布在外形上类似正态分布的"钟形曲线"。不过,这一分布基于样本方差的使用,而不是假定已知或已知的方差。因此它适用于用少于 30 个样本来估计 μ 的仿真研究——这实际上是常见的情形。
随着样本数变大,T 分布开始逼近正态分布。在计算置信区间时,Results Browser 把样本量 30 作为开始使用正态分布的阈值。对于所有取值少于 30 的样本集合,改用 T 分布。此时置信限的表达式与此前类似,只是真实方差  被样本方差 s² 取代,如下图所示,并且用常数 t_α 而不是 z_α 来表示分布曲线下的面积。
下表提供了 t_α 的一些常用值。更完整的数表可在标准统计学教科书中找到。
表 137:t_α 的常用值
| 置信水平 α | t_α,N = 3 | t_α,N = 5 | t_α,N = 10 | t_α,N = 20 |
|---|---|---|---|---|
| 99% | 9.925 | 4.604 | 3.250 | 2.861 |
| 98% | 6.965 | 3.747 | 2.821 | 2.539 |
| 95% | 4.303 | 2.776 | 2.262 | 2.093 |
| 90% | 2.920 | 2.132 | 1.833 | 1.729 |
| 80% | 1.886 | 1.533 | 1.383 | 1.328 |
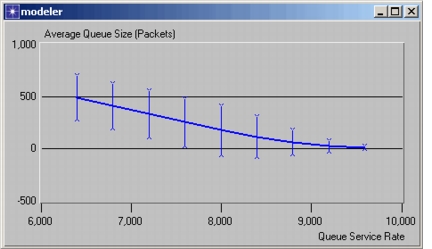
当对面板应用 Show Confidence Interval 操作时,统计量以这样的方式显示:在相同横坐标上对齐的条目被视为分组。每个分组被折叠为一个条目,其纵坐标为该组的均值。每组均值的置信区间按上面描述的方法计算,然后显示为一根以均值为中心、终止于上下置信限的垂直条。对于在某个特定横坐标处唯一的条目,无法计算置信区间;缺少置信条的情况用一个围绕相应点的小圆圈表示。该操作提供五种置信区间的选择:80%、90%、95%、98%、99%。带有置信限的图形示例见下图。
图 282:带有置信区间的统计量
通常可以控制映射到横轴的横坐标变量,使它在多次仿真中具有完全相同的值。这样,标量统计量值的各列就完全垂直。但在某些情形下,由于自变量参数是按随机方式指定的,它可能带有某些变化。例如,考虑这样的仿真研究:要测量一个被建模计算机系统的性能特征随施加到系统的作业负载变化的函数关系。再假设作业负载被指定为仿真的一个参数,但所指定的值实际上是平均作业负载,它控制着模型内的随机作业生成器。在这种情况下,即使把作业负载参数保持为常量,实际作业负载本身也会随随机数种子的改变而在各次仿真之间变化。因此,如果把实际作业负载取作"标量对比标量"图的横坐标变量,那么对应于一组参数完全相同的仿真的点分组通常不会完全垂直。
由于 Show Confidence Interval 操作只适用于垂直对齐的条目分组,有时需要在使用该操作之前消除一小部分条目在横坐标上的变化。在上述计算机系统的示例中,一种可能采用的做法是:为了保证基于标量的条目对齐,通过内核过程 op_stat_scalar_write() 记录规定的平均作业负载,而不是记录实际测得的平均值。这样,无论随机数种子如何,该参数都会得到完全相同的值。
Results Browser 也会计算置信区间。尽管无论面板的实际内容如何都会计算置信区间,但所提供的结果只对某种性质的数据集有意义。特别地,面板中统计量的条目必须被视为某个随机变量的独立样本;这一判断留给用户作出,因为 Results Browser 不了解统计量数据的来源。在适当的条件下,针对 80%、90%、95%、98% 和 99% 这五个置信水平报告的置信限,可以用来为统计量中所包含的一系列样本的均值提供区间估计。要显示置信区间,从 Graph 弹出菜单中选择 Edit Graph Properties,并选中 Show Confidence Intervals 复选框。