统计量收集机制:探针
对于大多数仿真,有大量系统变量和指标可供收集。节点级的每个模块以及网络级的每条链路都是大量内置本地统计量的来源,此外仿真还可以生成大量全局和本地用户自定义统计量。然而一般而言,仿真开发者感兴趣的只是可用数据中的一小部分。而且,收集所有可能的信息在存储空间上是难以承受的,并且会对仿真速度产生负面影响。为解决这一问题,Modeler 提供了选择性指定仿真运行期间应收集哪些信息的机制。本节将介绍这些机制。
数据流入输出文件由一种称为探针的特殊对象控制。探针对象不是模型本身的一部分,也完全不会影响模型在仿真中的行为。相反,它们扮演被动数据收集设备的角色,"附着"在模型中能够以上述某种形式生成信息的对象上。就其被动性而言,探针非常类似于分析电子电路时使用的理想示波器探头。通过将探针与模型解耦,Modeler 提供了一种强大的机制,可以快速更改数据收集的定义,而无需对模型本身做任何修改。
探针的作用是充当可能存入仿真输出文件的输出数据的使能器。每个未被显式探测的数据源实际上都处于"关闭"状态。Modeler 采取输出源默认关闭的做法,因为数据源的数量几乎总是远远多于感兴趣的数据源数量。
可以使用 Probe Editor 指定探针,它通过图形化选择建立探针对象与模型对象之间的对应关系。可以指定任意数量的探针,探针的集合以探针列表的形式保存。执行仿真时,探针列表中的探针作为一组应用于仿真模型。可以为同一模型分别指定多个探针列表,它们可以在不同的仿真中应用于该模型,但一次仿真运行只能使用一个探针列表。
探针有多种不同类型,分别对应 Modeler 支持的不同输出类型和对象。大体上,探针分为三类:统计量探针、动画探针和属性探针。每一类中还可能包含若干种不同的探针变体。这些探针都在本节中介绍,并列入下表。
表 117:支持的探针类型
| 探针类型 | 用途 | 变体 |
|---|---|---|
| 统计量 | 收集由内置对象统计量或用户自定义本地和全局统计量生成的数值形式数据。可以同时生成输出向量和输出标量。 | 节点 链路 路径 全局 |
| 属性 | 将对象属性和仿真属性的值作为输出标量捕获。这些值被视为仿真模型的"输入"。 | |
| 动画 | 使仿真能够发出图形动画命令。动画描述系统行为的各个方面,可以应用于特定对象、模型和统计量,也可以完全定制。 | 自动 定制 统计量 |
每个探针都是带有若干属性的对象,这些属性指定探针应用于哪个输出源,以及关于如何收集数据的各种选项。不同类型的探针具有不同的属性。有关各属性的使用细节,参见第 4 章"Probe Reference"第 107 页。
统计量探针
Modeler 支持本地统计量和全局统计量。本地统计量与特定对象相关联,统计量探针必须引用这些对象来收集数据。支持本地统计量的具体对象是节点、链路和模块。节点统计量实际上产生于节点内部的模块或子模块,但通过节点模型定义被提升到节点级(有关统计量提升的更多信息,参见第 6 章"Node Domain"第 263 页)。这一机制使节点模型的使用者无需了解节点模型内部组件即可访问这些统计量。节点和模块统计量由节点统计量探针对象支持,该探针提供用于指定被探测物理对象的属性,必要时可精确到子模块级。节点统计量探针既支持对象的内置统计量,也支持进程模型声明的用户自定义统计量。链路统计量探针提供对点对点链路和总线链路对象预定义统计量的访问。关于每个对象预定义的各项统计量的完整信息,参见第 2 章"Node Reference"第 8 页和第 3 章"Network Reference"第 60 页。
表 118:产生统计量的对象
| 对象类型 | 统计量 |
|---|---|
| Processor | 应用专用(由开发者定义) |
| Queue Subqueue |
应用专用(由开发者定义),以及与队列大小、可用队列空间、溢出发生次数、排队延迟等相关的统计量。 |
| Generator | 输出水平、到达间隔时间、数据包大小等。 |
| Transmitter channel | 吞吐量、利用率、队列大小 |
| Receiver channel | 吞吐量、利用率、冲突、误码率 |
| Link | 吞吐量、利用率、误码率;冲突 |
全局统计量提供与整个系统相关的信息。在一次仿真中,许多不同的对象可以共同贡献同一个全局统计量。例如,网络模型中的每个节点都可以使用同一个全局统计量来记录其接收的数据包所经历的端到端延迟。其结果是得到一个反映网络端到端延迟性能的统计量。全局统计量由进程模型声明,并由全局统计量探针对象支持。当然,全局统计量探针不引用任何对象,只指定统计量的名称。
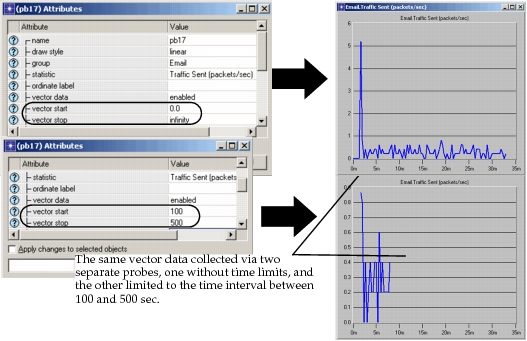
所有统计量探针都提供一组通过属性指定的通用选项。每个探针都可以同时作为输出向量和输出标量统计量的来源,分别由"vector data"和"scalar data"开关属性指定。两者可以同时启用。如果启用"vector data",统计量的全部值都会被收集到仿真输出文件的输出向量中。向量的统计量收集可以被限制在某段仿真时间范围内,由"vector start"和"vector stop"属性的值指定。这对于降低非常密集的统计量的存储需求很有用,因为通常只有统计量活动的一部分是感兴趣的。这一时段常常位于仿真末尾,或位于某个感兴趣事件(例如组件故障)之后,以便分析瞬态行为。
图 240:用探针的起始与停止时间限制向量的时间跨度
如果启用统计量探针的 scalar data 属性,探针将在仿真结束时在仿真的输出向量文件中生成一个标量值。该标量值按照指定的度量,由统计量在仿真过程中的全部个体值计算得出。与输出向量收集一样,标量统计量的计算也可以限制为统计量在特定期间内经历的值。该期间使用探针的"scalar start"和"scalar stop"属性指定。支持的度量通过"scalar type"属性指定,列于下表。
表 119:探针支持的标量类型
| 标量类型 | 说明 |
|---|---|
| last value | 收集窗口内最后一次更新的值 |
| sample mean | 收集窗口内所有更新值的均值(即全部更新值之和除以更新次数) |
| time average | 收集窗口期间生成的值随时间的平均值;该平均按数据集的"采样保持"行为计算(即每个值以其与下一次更新之间的时间长度为权重加权,全部加权值之和除以收集窗口的宽度)。 例如,假设在一个一秒的 bucket 中生成了三个值:第一个在 0.1 秒生成,第二个在 0.2 秒生成,第三个在 0.9 秒生成。由于第二个值持续了 0.7 秒(0.9 - 0.2),它的持续时间比另外两个更长,在计算时间平均时被赋予更大的权重。 |
| variance | 收集窗口内出现的全部更新值的样本方差(即更新值与其样本均值之差的平方的均值) |
| min value | 收集窗口期间遇到的最小值 |
| max value | 收集窗口期间遇到的最大值 |
在某些情况下,统计量在仿真过程中变化过于频繁,以致以输出向量形式收集其全部值变得不可行。具体而言,一个或多个向量若完整收集可能需要难以承受的磁盘存储空间。此外,频繁保存统计量可能降低仿真性能,尽管 Modeler 采用了机制来尽量减小这种影响。在这些情况下,即使牺牲一定的准确性或完整性,也可能需要减小所收集数据的规模。一种可用的机制是限制收集的时间窗口,如本节前面所述。另一种方法可以单独使用,也可以与时间窗口结合使用,即按指定速率对统计量取值进行缩减,以生成密度较低的输出向量。统计量探针通过"capture mode"属性支持对统计量的"即时"处理,尤其是统计量的缩减。探针的捕获模式指定了在统计量值更新时对其进行修改的方法。输出文件中存储的是修改后的值,而不是最初提交给探针的"原始"值。支持的捕获模式有四种,如下表所列。
表 120:统计量捕获模式
| 模式 | 详情 |
|---|---|
| all values | 统计量的全部更新都未经修改地记录。 |
| sample | 只记录某些统计量更新,忽略其他更新。支持两种模式:1) 保留每第 n 次更新;或 2) 每 T 秒保留一次更新。 |
| bucket | 考虑一组称为"bucket"的点,并记录一个能代表该 bucket 的值。bucket 可以用时间区间或其包含的更新次数来指定。保留的值按 bucket 中各值的下列函数之一计算:sum/time、min value、max value、sample mean、time average 和 count。这是默认捕获模式。 |
| glitch removal | 当统计量的多次更新发生在同一时刻时,只保留最后一次更新。 |
图 241:普通模式与 bucket 模式的比较
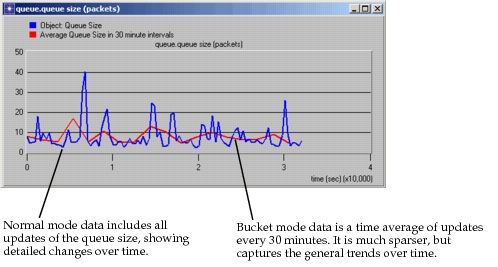
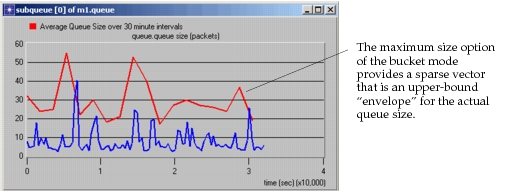
根据统计量的性质和建模者的目标,不同的捕获模式或捕获模式的选项可能更为合适。图 241展示了在收集快速变化的统计量(例如到达率与离开率大致相等的随机队列的队列大小)时使用 bucket 捕获模式的效果。bucket 模式的结果很有用,因为它显示了统计量变化的总体趋势,即使它没有捕捉到任何快速变化。然而,由于变化很快,时间平均的 bucket 模式输出无法显示队列大小可以达到多高。对于某些可以快速上升和下降的统计量,这一缺陷可能更加明显。例如,在确定缓冲区大小时,峰值可能是感兴趣的。使用带最大值计算的 bucket 模式的结果如下图所示。
图 242:普通模式与带最大值选项的 bucket 模式的比较
注: 如果为探针启用了"scalar data"属性,则"capture mode"属性适用于用于导出标量统计量的向量统计量。因此,捕获模式会影响最终的标量数据结果。
属性探针
属性指定对象的特征。由于属性是模型定义的一部分,它们可以被视为仿真的"输入"。当某个属性被提升到模型的网络级之上、需要在仿真执行时提供赋值时,这一点尤其明显。将某些仿真输入引入输出文件是有用的,它便于研究仿真输出与输入之间存在的依赖关系。例如,我们可能想分析网络吞吐量如何随提交的流量负载变化。或者,我们可能关心流量的端到端延迟如何随网络传输线速率变化。在这些情况下,流量负载和传输线速率是我们会在一系列仿真实验中改变的模型输入。在每个实验中,我们都会记录这些输入以及吞吐量和端到端延迟。通过将输入量和输出量一起记录下来,我们可以建立它们之间的关系。
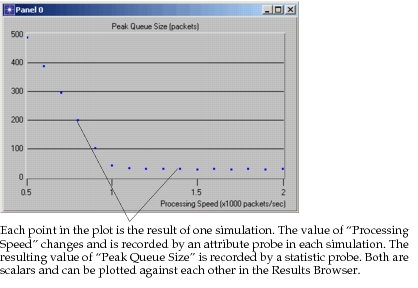
由于用户自定义代码可以访问属性的值,并且也能够向仿真输出文件写入值,因此进程模型当然可以将属性值保存到仿真输出文件中。进程模型还可以进行组合或以其他方式处理多个属性值的计算。然而,在只关心数值属性的值而无需进一步处理的情况下,可以使用称为属性探针的特殊探针。数值属性包括 integer、double、toggle 和 toggle 数据类型。每个属性探针应用于一个对象属性或仿真属性,并在输出 VECTOR 文件中生成相应的标量值。属性探针有一个名为"object"的属性,允许它引用模型中网络级或节点级的任何对象。如果系统中的任何进程模型声明了仿真属性,属性探针可以通过将"object"属性留空来引用它。下面的图展示了使用属性探针作为自变量(即输入)、统计量探针作为因变量(即输出)所能得到的一幅图的例子。
图 243:利用统计量探针与属性探针的输出生成的标量图
动画探针
Modeler 提供了一种称为动画探针的机制,用于在仿真运行时启用并配置动画信息的生成。使用动画探针的基本考虑与统计量探针类似:典型仿真中可能收集到数量庞大的动画数据,而其中真正感兴趣的也许只是一小部分。通过明确指定模型的哪些方面或哪些物理部分应当被动画化,可以使由此产生的信息流保持在可管理的范围内。
三种类型的动画探针对象——自动动画探针、定制动画探针和统计量动画探针——可以放入仿真的探针文件中,以启用动画数据的生成。同一探针文件中可以并存多种类型的多个探针。自动动画探针和统计量动画探针都启用 Riverbed 模型的内置动画能力。它们提供了在离散事件仿真中获得动画的最简单方式,因为模型内无需任何附加定义。定制动画探针充当局由用户自定义进程生成的动画请求的使能设备。定制动画在表示一般信息方面提供了灵活性,但需要模型开发者进行编程定义。
自动动画探针
动画探针可以放置在网络域和节点域的对象上。根据探针所影响对象的类型不同,将产生不同类型的动画,如下表所总结。关于每种自动动画所提供的功能的完整描述,参见第 1 章"Using the 2-D Animation Viewer"第 1 页。
表 121:支持的自动动画形式
| 对象类型 | 自动动画类型 |
|---|---|
| 子网 | 对子网内点对点链路和总线链路上的数据包流的动画。 |
| 节点(固定、移动或卫星) | 对节点内数据包流上的数据包流动的动画 |
| Processor 或 queue | 对所选模块内根级进程的状态转移动画 |
每个自动动画探针都包含名为"subnet"、"node"和"module"的属性,用于指定受影响的对象。然后使用"representation"属性选择所需的自动动画形式。此外,每个探针都包含用于限制其生效的仿真时间窗口、以及控制所生成动画窗口的位置和尺寸的属性。有关自动动画属性的说明,参见第 4 章"Probe Reference"第 107 页。
定制动画探针
如果自动动画不能提供模型开发者所需的全部功能,Modeler 允许开发者创建更适合特定应用或更完整的定制动画。定制动画使用从进程模型或管道阶段调用的 Anim package 内核过程(KP)实现。这些过程提供通用的绘制和动画能力,以及专门与显示模型相关的函数。完整规范参见第 2 章"Animation Package"第 1 页。
由于动画会显著降低仿真性能,能够选择性地启用动画的生成非常重要。特别是在长时间仿真运行或一系列仿真运行期间,动画通常被完全禁用。由于定制动画由用户开发的逻辑生成,开发者可以纳入自己的动画控制机制。一般而言,这种机制可以基于对象属性或环境属性,使用 Ima 包的 KP 进行查询。根据这些属性的值,可以有条件地执行动画代码。
Modeler 提供了一种内置的选择性启用动画的机制,称为定制动画探针。与自动动画探针一样,定制动画探针与网络域或节点域中的一个对象相关联。然而,定制动画探针并不产生某种标准形式的动画,而是作为在被探测对象上下文内执行的动画指令的使能代理。换句话说,默认情况下,对动画相关内核过程的调用会被忽略,除非定义了适当的定制动画探针来启用它们的动作。
定制动画探针的上下文,即它能够启用的动画指令的范围,取决于它所应用的对象的类型。归根结底,定制动画指令的来源必须是进程模型逻辑或收发器管道阶段逻辑,因为它们是支持集成用户开发代码的接口。将某个 processor 或 queue 作为定制动画探针的对象,意味着其中包含的任何进程执行的动画指令都可以使用该探针。这延伸到进程函数块中的过程,以及在所探测模块上下文中执行的外部文件中定义的过程。类似地,如果收发器是定制动画探针的对象,则从相关管道阶段内部发出的动画指令(包括间接调用的过程)都会受到该探针的影响。下表列出了每种受支持对象类型上定制动画探针的作用范围。
表 122:定制动画探针的作用范围
| 被探测对象类型 | 被启用的动画指令来源 |
|---|---|
| 子网 | 在任意深度层级的模块内执行的全部进程;此外,与任意深度层级的收发器模块或链路相关联的全部管道阶段。 |
| 节点 | 在节点内包含的任何 processor 或 queue 内执行的全部进程;此外,与节点内发送器或接收器模块相关联的全部管道阶段。 |
| Processor 或 Queue | 在该 processor 或 queue 内执行的全部进程。 |
对于收发器管道阶段,存在明确的关联:在管道执行期间,要么与作为源的发送器关联,要么与作为目的的接收器关联。下表总结了这种关联,用于确定动画探针的放置位置。
表 123:管道阶段的收发器关联
| 管道类型 | 与发送器关联的阶段 | 与接收器关联的阶段 |
|---|---|---|
| 点对点 | transmission delay, propagation delay |
error allocation, error correction |
| 总线 | transmission delay, closure, propagation delay |
collision, error allocation, error correction |
定制动画探针拥有一组与自动动画探针基本相同的属性:指定被探测对象的属性、生效的时间窗口,以及显示窗口的几何属性。此外,一个名为"label"的属性可用于特化探针的适用范围。用户自定义代码可以判断是否存在具有特定 label 的探针,如果存在,还可以确定与该探针关联的是哪个动画查看器(即动画窗口)。代码随后可以启用适当的动画请求,并将其定向到所需的窗口。label 还充当一种会合机制,使不同的进程和管道阶段能够获得相同的动画查看器 ID,并在同一窗口内协调它们的活动。探针 label 的含义由用户定义,但仿真内核通过 KP op_anim_lprobe_anvid() 支持这一特性,该 KP 将 label 转换为动画查看器 ID。有关定制动画 label 使用的更多信息,参见第 2 章"Animation Package"第 1 页。有关"label"属性的更多信息,参见第 4 章"Probe Reference"第 107 页。
统计量动画探针
统计量动画提供了在仿真过程中动态查看输出向量统计量随时间演化的能力。统计量动画中呈现的图显示在一个"analysis panel"中,它类似于 Results Browser 中显示的面板。不过,它会动态调整——通过重新缩放和滚动来适应输出向量不断变化的边界,因为更新值不断从仿真中接收。每个统计量动画探针使用"scrolling"属性指定:是显示统计量的固定宽度时间窗口,还是通过随时间不断扩展时间轴来显示向量的全部历史。
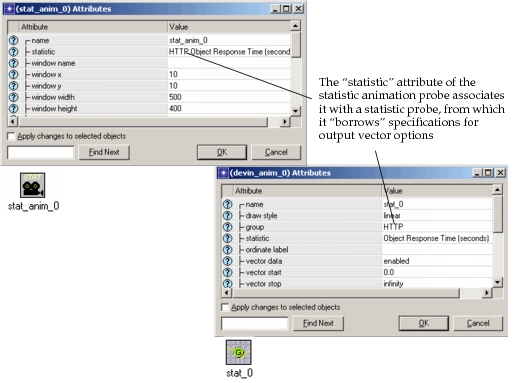
统计量动画探针只能与其他统计量探针配合工作。换句话说,只有已经通过节点、链路或全局统计量探针探测过的统计量,才能提供统计量动画。统计量动画探针使用其"statistic"属性与某个统计量探针建立关联。该属性的值必须与统计量探针中指定的统计量的完整层次名称相匹配(参见图 244中的示例),或者与统计量探针的"ordinate label"(如果已指定)相匹配。相应统计量探针的选项,例如起始和停止时间以及捕获模式,会自动应用于统计量动画探针。因此,统计量动画结束时得到的最终图与统计量探针产生的输出向量完全相同。
图 244:统计量探针与统计量动画探针的关联
注: "window name"属性必须为每个动画探针提供唯一的值。不能在一个窗口中查看多个动画。