仿真输入控制
仿真模型构建完成后,通常需要在多种不同条件下运行它,以刻画其所代表的系统。模型本身保持不变,而其所处环境的某些方面、或它所提供的参数会被改变,用以建立行为模式,或建立系统某些输入与所选输出之间的关系。输入与输出因所建模系统的不同而不同,并取决于仿真研究的目标。本节描述在运行仿真时如何控制模型的输入。
随机建模
许多仿真依赖对某些元素进行随机建模,用以表示那些无法精确预知、但可以通过为一组结果关联概率来加以刻画的行为。需要这一技术的常见应用如下:
- 通信网络的流量负载通常由大量独立信源汇聚而成。这些独立信源通常对应于流量提交无法精确预测的用户。此外,这些信源彼此之间通常互不协调,从而呈现出看似随机的流量流。网络流量中其他由用户决定的特性,例如目的地的选择和服务质量参数,也常常以随机方式建模,以反映用户选择的多样性。
- 某些计算机操作需要可变的执行时间才能完成。有些对应于使用延迟可能变化的物理设备,例如磁盘或磁带驱动器。在其他情况下,对计算机资源(如总线、CPU 或内存)的争用可能使特定任务在访问这些资源时出现可变延迟。这些延迟既可以通过显式表示所有争用资源的任务来建模,也可以用更抽象的方式建模:在访问相关资源的操作中引入可变延迟。
- 某些通信协议的定义要求它们以随机或伪随机方式执行操作。常见示例包括为重传消息选择随机定时器值,以及随机选择服务多个争用流量源的顺序。
- 影响所传输数据包的误码的数量与位置通常被建模为随机过程。事实上,链路质量通常由制造商或服务提供商以统计术语加以表征,从而可以直接映射为以随机参数化的模型。
创建可变行为
许多仿真依赖对某些元素进行随机建模,用以表示那些无法精确预知、但可以通过为一组结果关联概率来加以刻画的行为。随机建模的元素依赖于一个随机数源,并以其作为自身行为的基础。通过从该源"抽取"数值,这些元素可以在采取行动或做出决策时引入相应的变异性。
如前所述,计算机程序就其本质而言不可能表现出真正不可预测的行为。如果仿真程序在多次仿真运行中保持不变,那么其行为的任何变化必然来自运行环境(即输入)的变化。特别地,即使用于实现随机行为的随机数流,也必须被强制进入不同的模式,才能在一次仿真与下一次仿真之间产生不同的结果。
用于选择新的随机数序列的机制,依赖于每次让伪随机数生成器从一个不同的状态开始(之所以称为"伪随机",是因为在计算机上不可能生成真正随机的数)。由于这一初始状态决定了伪随机数生成器的所有后续输出,它被称为随机数种子。对于离散事件仿真,随机数种子可以通过整数偏好设置 "seed" 来设置。此外,也可以在 GUI 中为每次仿真分别指定。
对于包含随机元素的仿真,每一个不同的随机数种子取值都会产生不同的行为并得到新的结果。于是,每一次具体的仿真都可以被视为所建模系统的一种可能的事件场景。然而,单次仿真未必能够作为"典型"系统行为的准确度量,因为可以设想,对于某个随机数种子,甚至可能得到非典型的行为(只要它是可能发生的)。
为了解这类统计异常,必须在改变随机数序列的同时对仿真模型进行多次运行,然后将各次仿真得到的结果组合起来(例如取平均)以估计典型行为。在一族仿真中改变随机数种子有助于确保统计有效性。这可以保护仿真结果不被统计离群值带偏,并使结果具有更高的置信度。Riverbed Modeler 天生支持这种以不同随机数种子运行一族仿真的工作流(参见仿真序列)。它还允许把一系列仿真分发到多台机器上同时执行,从而加快这一过程(参见"Distributed Simulation"第 422 页)。
随机数生成
Modeler 在下列情况下使用随机数生成器:
- 管道阶段使用随机数将误码分配到数据包上。
- 许多进程模型使用的 KP
op_dist_uniform()和op_dist_outcome(),其返回结果依赖于随机数序列。
在这两种情况下,随机数(通常)都从同一个随机数序列中抽取。用于创建该序列的随机数生成器是 BSD UNIX 源码发行版中 random() 函数的移植。该生成器的周期为 2^31-1。(基于 Mersenne Twister 算法的较新随机数生成器可以通过 "rand_gen_type" 偏好设置来选择。)
虽然典型运行使用单个、全仿真范围的随机数序列,Modeler 也可以按模块生成随机数序列。这对并行仿真尤其有用。细节参见生成随机数。
对于要求不同随机元素所使用的随机数序列完全独立的模型,进程和管道阶段可以独立调用宿主计算机的随机数设施或其他专有随机数生成器。它们还可以使用"Random Sub-Package"第 103 页中描述的 KP,这些 KP 支持创建相互独立的随机数流。仿真内核的 Dist 包提供了一个特殊 KP——op_dist_outcome_ext()(描述见"Distribution Package"第 1 页)——支持在专有随机数生成器下使用概率分布。
仿真参数化
除了改变随机数种子以获得一系列随机行为之外,许多仿真研究还会改变模型的某些属性,即运行条件。这样,就可以在一系列可能的配置下刻画所建模的系统,以支持权衡分析,并确定系统的限制和峰值性能条件。
用于改变模型配置的主要机制基于提升对象属性的使用。提升属性的值可以在每次仿真时改变,而无需修改仿真模型或仿真程序。提升属性是指那些值被有意留空的对象属性,正是为了把这些赋值留到仿真执行时再完成。换句话说,提升属性可以被视为模型设计者提供的仿真程序参数。有关属性提升的更多信息,参见"Modeling Framework"第 80 页。
支持改变模型配置的第二种机制基于使用不与任何特定对象关联的变量。这些变量称为仿真属性,其值可以由用户自定义逻辑通过 KP op_ima_sim_attr_get() 获取。由于仿真属性与对象没有任何关联,它们非常适合表示系统级的全局参数。仿真属性及其值的解释与应用完全留给用户自定义代码;内核只是提供一个便于这种参数化的接口。
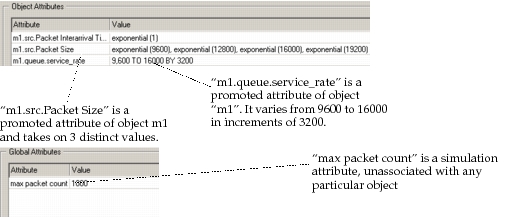
在指定仿真的参数时,提升属性和仿真属性以相同的方式处理。Modeler 允许每次仿真通过提供具体值、值范围或一组离散值来完成数值属性的指定。非数值属性只能指定具体值。当至少一个属性被指定了范围或一组值时,用户实际上已经隐式指定了要执行的多次仿真运行,每次运行对应该属性的一个不同取值。当多个属性被指定了范围或一组值时,Modeler 会为属性值的每一种唯一组合执行一次独立的仿真。注意不要以这种方式启动过多的仿真。图 246展示了仿真参数的指定方式。有关设置参数的更多信息,参见"Configuring a Simulation"第 395 页。
图 246:属性值指定
注: 在 GUI 之外执行仿真时,可以通过为所有 Modeler 程序提供的环境属性机制来为属性赋值,其完整范围描述见第 1 章"System Environment"第 1 页。这些机制包括通过命令行赋值,以及使用一个或多个环境文件和偏好设置文件。