使模型具备并行安全性
以下各节介绍使模型具备并行安全性的技术细节。
互斥锁
对于不应并发执行的代码,你可以使用各种串行化机制来确保同一时刻最多只有一个线程访问该代码。互斥锁(mutex)是强制串行化的一种常用手段:当多个线程试图访问某段关键代码时,只会有一个线程获得继续执行的许可。其余线程必须等待正在执行的线程完成,届时其中一个等待的线程将开始处理这段代码。
Modeler 提供了一组用于创建和使用互斥锁的内核过程(KP),这些过程在“Mutex Sub-Package”(第 5 页)中有说明。另有一个额外的包(prg_mt)适用于需要更精细地控制串行化的场合;详见“Mutex Package”(第 90 页)。
互斥锁的串行化
下面的示意图详细展示了互斥锁如何强制代码串行化。线程通过尝试锁定互斥锁来请求访问某段关键代码。锁定完成后,该线程即可继续执行。其他试图锁定该互斥锁的线程将被阻塞。成功锁定互斥锁的线程在完成关键代码段之后,必须解锁该互斥锁,以便其他等待的线程得以继续执行。
图 258:互斥锁(Mutex)的工作过程
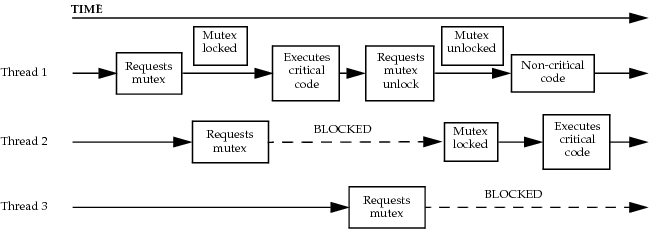
同一个互斥锁可以用于保护多段代码,例如某个链表管理包中的各个函数。这样可以确保一旦某个线程正在执行其中某个函数,其他线程就无法修改该链表包的内部结构。
默认互斥锁不允许同一线程递归加锁。如果一个已经锁定了某互斥锁的线程试图再次锁定它,它将被阻塞并等待自己完成。加锁内核过程能够检测到这种情况并且不会阻塞;相反,它会通过一条相应的错误消息报告代码中潜在的问题。
有时,如果互斥锁允许任意次数的递归加锁,事情会简单得多。这样的互斥锁恰当地称为递归互斥锁。每次加锁使一个内部计数器加 1,每次解锁使该计数器减 1。只有当加锁计数器的值回到 0 时,该互斥锁才可被其他线程使用。
要在你的管道阶段中使用互斥锁,你必须确保在任何管道阶段被调用之前该互斥锁已经创建(例如,必须在进入 link closure 管道阶段之前创建该互斥锁)。该互斥锁随后作为全局变量保存,供各个管道阶段访问。
互斥锁死锁
使用多个互斥锁可能导致死锁,即一组线程被无限期阻塞。该组中的每个线程都已锁定一个或多个互斥锁,并在等待该组中其他线程所持有的一个或多个互斥锁变得可用。没有任何线程能够完成代码去解锁自己已锁定的互斥锁,因此也就无法让其他线程继续执行。
下面给出一个简单的例子,两个线程试图锁定同样的两个互斥锁,但加锁顺序不同:
Thread A – Lock (mutex1); Lock (mutex2); <Critical Section A>; Unlock (mutex1); Unlock (mutex2);Thread B – Lock (mutex2); Lock (mutex1); <Critical Section B>; Unlock (mutex1); Unlock (mutex2);
如果两个线程都成功完成了第一次加锁,那么线程 A 将持有 mutex1 并等待 mutex2,而线程 B 将持有 mutex2 并等待 mutex1,从而形成死锁。
并行仿真内核过程在设计上的特性有助于你检测和防止可能的死锁。更多信息参见 op_prg_mt_mutex_create() 的说明(第 72 页)。
全局变量
非常量全局变量是模型代码被认为不适合并行执行的主要原因之一;在全局变量更新期间,由非确定的并行执行引起的竞态条件可能导致错误的值。
例如,考虑以下代码:
int   next_unique_id = 0;

int
my_unique_id_get (void)
	{
	int id = next_unique_id; /* A */
	next_unique_id++; /* B */
	return id;
	}
如果 my_unique_id_get() 在两个不同线程中并行执行,并且两个线程同时执行语句 A,那么两个线程将返回同一个数字。这会破坏所生成值的唯一性。
此外,C 语言的后置自增和前置自增运算符(++) 不是原子操作;这意味着实现它们需要多条 CPU 指令。因此在并发执行的语境下,语句 B 的结果是非确定的。为确保确定的行为,修改全局变量的访问应当由某种串行化构造(例如互斥锁)加以保护,如下面的代码所示:
int
my_unique_id_get (void)
	{
	int id;
	prg_mt_global_mutex_lock ();

	id = next_unique_id;
	next_unique_id++;
	prg_mt_global_mutex_unlock ();

	return id;
	}
只在仿真初始化期间(例如在 BEGINSIM 中断期间,或在仿真的时间 0)被修改的全局变量不会造成问题,因为这些事件由仿真内核串行化执行,保证按顺序执行。这意味着在仿真其余部分读取全局变量的模型代码无需为串行化访问而作修改。
只在仿真需要时才设置的全局变量,也可以用下面的构造来高效保护:
static void * set_once_variable;
static int  set_once_variable_set = 0;

if (!set_once_variable_set)
	{
	/* Serialize execution */
	op_prg_mt_global_mutex_lock ();
	/* Check condition again: some other thread may have */
	/* initialized the value                              */
	/* while we were trying to lock the mutex             */
	if (!set_once_variable_set)
		{
		/* initialize */
		set_once_variable = init_that_variable ();

		/* Set global flag AFTER initialization is complete */
		set_once_variable_set = 1;
		}

	/* Release the mutex */
	op_prg_mt_global_mutex_unlock ();
	}
由于其中涉及一定的运行时开销,只要可能,最好把所有这类变量放在串行化的初始化阶段设置。
对仿真期间可能被改变的全局变量的访问,需要用某个互斥锁加以串行化。当争用很多时,互斥锁串行化的代价会显著升高(在某些平台上可达数百倍)。当两个或更多线程同时试图获取同一个互斥锁时就会发生争用。因此,你应当避免使用全局互斥锁。事件执行在模块层面是串行化的这一事实,在某些情况下有助于避免使用互斥锁。在另一些情况下,把对象划分为若干对象子集、每个子集共用自己的全局互斥锁,也可能有所帮助。例如,让属于同一子网或同一无线传输组的一组对象共用一个私有互斥锁,可能比让这些组争用一个全局互斥锁更高效。
在进程模型的临时变量块中声明的非 static 变量,其访问无需串行化;这些变量对每次为处理某个事件而调用的进程实例都是局部的。
状态变量
出于效率考虑,对状态变量的访问不做串行化。因此,访问状态变量值的内核过程不应用于访问与当前进程所属模块无关的其他进程的状态变量。换句话说,用这些内核过程访问与当前进程同属一个模块的子进程、父进程或兄弟进程的状态变量是安全的。但如果模型代码要访问任何其他进程的状态变量,这些内核过程调用必须通过共享互斥锁加以串行化。
Prg 数据结构
在并行仿真中,使用哈希表和链表数据结构需要特别注意,如下各节所述。
Prg_String_Hash
对字符串哈希表的添加、修改和遍历都不具备并行安全性,必须加以串行化。不过,对静态哈希表数据的“读取”访问无需串行化。在非常常见的场合——数据先计算出来、若此前未插入则插入哈希表——下面的构造是安全的:
void *data_ptr = prg_string_hash_table_item_get (hash_ptr, key_string);
if (!data_ptr)
{
	op_prg_mt_global_mutex_lock ();
	/* check again (other thread may have inserted the data already */
	data_ptr = prg_string_hash_table_item_get (hash_ptr, key_string);
	if (!data_ptr)
	{
		data_ptr = calculate_data (key_string,…);
		prg_string_hash_table_item_insert (hash_ptr,
		key_string, data_ptr, NULL);
	}
	op_prg_mt_global_mutex_unlock ();
}
只有当对哈希表及其内容的修改仅限于添加新元素时,上述构造才是安全的。也就是说,不允许删除元素或修改哈希表中已存储的元素。
Prg_List
链表访问一般不具备并行安全性。所有可从不同进程访问的共享链表,其访问都必须串行化。此外,对共享链表的遍历和元素访问操作也不具备并行安全性。因此,动态的链表操作必须通过互斥锁加以串行化。你可以考虑用数组取代链表,因为数组的读取访问具备并行安全性;链表则不然。
仿真上下文指针
为了高效执行代码,并行仿真的内核过程需要一个额外的、不透明的仿真上下文参数。调用内核过程的模型代码必须把该上下文指针参数传给这些内核过程。这意味着用户定义的代码必须能够取得该仿真上下文指针,以便把它传给所调用的内核过程。
获取上下文指针有三种方式:
- 使用 FIN 宏(预期在所有函数中,它都出现在除变量声明之外的任何代码之前)。该宏隐式取得正确的仿真上下文并把它放入一个局部变量。
- 进程模型的有限状态机把上下文指针作为其参数之一。因此,enter 或 exit 执行段以及转移中的任何代码都自动可以访问该上下文指针。
- 并行安全的管道阶段会把仿真上下文作为一个额外参数显式传递给它。
FIN 与 FIN_MT 宏
FIN 宏对上下文指针的隐式查找和赋值开销并不大(就执行时间而言)。但对于被频繁调用的函数,它可能成为瓶颈,例如搜索操作中的比较函数,或在大型数据集上被频繁调用的计算。在这些情况下,你可以修改函数声明,把仿真上下文指针作为其参数之一,并让该函数的调用者显式把该上下文传递进来。由于对用户定义函数的大部分调用都来自有限状态机或管道阶段,你可以把所有函数改为接受一个仿真上下文指针参数,并将其传播到全部模型代码。
在现有模型代码中,你可能会发现两个问题:
- 你的函数没有使用 FIN/FOUT/FRET 宏。除非显式把仿真上下文传给这类函数,否则其中的仿真上下文将是未定义的。
- 由于访问进程模型的状态变量需要仿真上下文指针,在 FIN 语句之前状态变量可能不可访问。
例如,假设 SV 是一个整型状态变量,下面的代码在并行执行时无法编译:
void my_proc(void)
	{
	/* Use FIN_MT since the context is explicit */
	int j = SV;
	FIN (my_proc);
	…
你需要把代码改为如下形式:
void my_proc(void)
	{
	int j;

	FIN (my_proc);

	j = SV;
	…
为避免声明重复的仿真上下文,并消除确定当前上下文所带来的开销,对于那些已改为接受显式仿真上下文参数的函数,以及不需要仿真上下文的函数,你可以用 FIN_MT 取代 FIN 语句。这样就避免了标准 FIN 语句为获取隐式仿真上下文而做的额外工作。
上下文宏
为帮助模型开发者维护一套既适合串行又适合并行执行的模型代码,仿真内核头文件中定义了少数几个可用于所有模型代码的宏。这些宏在串行执行期间(此时并不需要上下文)通过展开为空来消除传递不必要的仿真上下文所带来的开销。然而,当同一份模型代码为并行执行而编译时,这些宏会提供所需仿真上下文的必要功能:
OP_SIM_CONTEXT_ARG_OPT
OP_SIM_CONTEXT_ARG_OPT_COMMA
这些宏应用在函数声明中,用于那些在并行执行时期望调用者传入显式仿真上下文指针参数的函数。带 _COMMA 的变体在展开后的并行宏中包含一个逗号。两个宏在串行仿真中都展开为空。
OP_SIM_CONTEXT_PTR_OPT
OP_SIM_CONTEXT_PTR_OPT_COMMA
这些宏应用在调用处,把仿真上下文指针传给在并行执行时期望把它作为参数的函数。带 _COMMA 的变体在展开后的并行宏中包含一个逗号。两个宏在串行内核中都展开为空。
下面的例子展示了如何使用这些宏:
/* Function prototypes */
void
void_function (OP_SIM_CONTEXT_ARG_OPT);

void
function_that_takes_int_arg (OP_SIM_CONTEXT_ARG_OPT_COMMA int x);

/* Functions */
void
void_function (OP_SIM_CONTEXT_ARG_OPT)
	{
	FIN_MT (void_function);

	/* call function with an argument */
	/* The first argument is the simulation context itself	*/
	/* and the second is the integer ‘23’.  During sequential	*/
	/* execution, there is only one argument passed in since the	*/
	/* OP_SIM_CONTEXT_PTR_OPT_COMMA macro expands to nothing.	*/
	function_that_takes_int_arg (OP_SIM_CONTEXT_PTR_OPT_COMMA 23);

	/* here is how to call a void function that takes a sim	*/
	/* sim context pointer as an argument.				*/
	void_function (OP_SIM_CONTEXT_PTR_OPT);

	FOUT;
	}
不安全与不支持的内核过程
并行仿真内核所支持的全部内核过程都被认为是并行安全的。然而,某些内核过程暴露出的函数和数据在并行环境中本质上是不安全或危险的。使用这类内核过程必须仔细审查。Modeler 并未从并行内核中移除这些内核过程,因为它们仍可用于未标记为并行安全、按串行执行的模型。而且,如果使用得当,这些内核过程能为模型开发者提供便利。
此外,有些内核过程在模型代码中很少使用,被认为代价过高、且在并行内核中过于危险而不宜支持。简而言之,支持中断优先级以及遍历待执行事件的那些函数已从并行仿真内核中移除。
有关不安全与不支持内核过程的汇总,参见“Multi-Threading Safety”(第 11 页)。
优先级属性
在并行仿真内核中,所有类型节点上内置的 “priority” 属性已被移除,所有模块上内置的 “priority” 和 “super priority” 属性也已被移除。