总线收发器管道
由于总线链路是一种广播介质,每一次传输都可能影响连接到总线上的多个接收机。此外,在处理一次传输时,总线链路相对于每个接收机可能表现出不同的行为与时序。因此,必须为连接到总线上的每个接收机分别执行一条独立的管道。
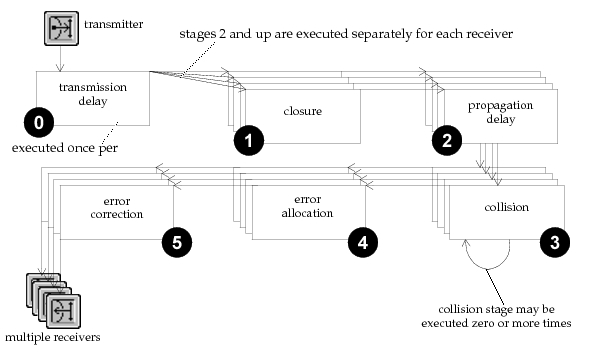
总线收发器管道由六个阶段组成,其中大多数阶段在每次传输发生时都必须按接收机逐个执行。不过,第一个阶段(传输时延)计算的结果对所有目的地都是共同的,因此只需执行一次。此外,每一条单独的管道序列能否完整执行完毕,取决于第二个阶段(链路闭合)的结果,因为该阶段负责判断发射机与接收机之间的通信是否可能。最后,第四个阶段(冲突)对每一个传输的数据包可能被执行多次,因为一个数据包可能卷入多次冲突。总线收发器管道的结构如下图所示。
图 232:一次传输的总线链路收发器管道执行顺序
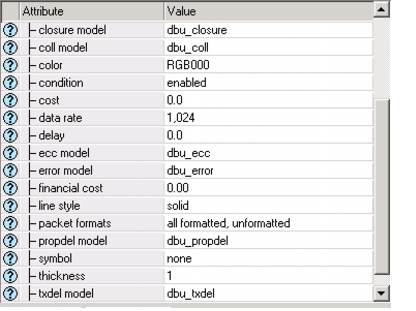
特定总线链路的管道阶段可以通过总线链路对象的相应属性来指定,如下图所示。
图 233:用于指定管道阶段的总线链路属性
保留的传输数据属性
仿真内核预留了若干个传输数据属性(TDA),使管道阶段能够访问一组最低限度的标准取值,并支持内核与管道阶段之间、以及各阶段相互之间的通信。在通过总线链路传输的数据包中,为这些目的保留的 TDA 定义如下。为了紧凑,表示 TDA 索引的符号常量以不含公共前缀的短形式给出。实际使用时,每个符号常量都会在下面给出的名称前加上字符序列 “OPC_TDA_BU_”。每个 TDA 的数据类型在表格中标注于符号常量名称旁边:“D” 表示双精度浮点属性,“I” 表示整数属性。
表 111:总线管道保留的 TDA
| 符号常量 | 定义 | 赋值者 | 阶段可修改 |
|---|---|---|---|
TX_OBJID (I) |
总线发射机的对象 ID | 内核 | 否 |
LINK_OBJID (I) |
总线链路的对象 ID | 内核 | 否 |
TX_TAP_OBJID (I) |
发射机抽头的对象 ID | 内核 | 否 |
TX_CH_OBJID (I) |
发射工信道的对象 ID | 内核 | 否 |
CH_INDEX (I) |
发送与接收信道的索引 | 内核 | 否 |
RX_OBJID (I) |
总线接收机的对象 ID | 内核 | 否 |
RX_TAP_OBJID (I) |
接收机抽头的对象 ID | 内核 | 否 |
DISTANCE (D) |
接收机与发射机之间的距离(米) | 内核 | 否 |
NUM_COLLS (I) |
数据包迄今经历的冲突次数 | 内核、阶段 3 | 是 |
END_RX (D) |
接收将要完成的时刻 | 内核 | 否 |
CLOSURE (I) |
发射机到达接收机的能力 | 阶段 1 | 是 |
TX_DELAY (D) |
在发送侧完成传输所需的时间 | 阶段 0 | 是 |
PROP_DELAY (D) |
数据包信号从发射机传播到接收机所需的时间 | 阶段 2 | 是 |
NUM_ERRORS (I) |
影响数据包的误码数量 | 阶段 4 | 是 |
PK_ACCEPT (I) |
接受/拒绝数据包的决定 | 阶段 5 | 是 |
ND_FAIL (D) |
数据包接收期间发生节点故障的最早仿真时刻 | 内核(若发生故障) | 否 |
ND_RECOV (D) |
数据包接收期间发生节点恢复的最晚仿真时刻 | 内核(若发生恢复) | 否 |
阶段 0:传输时延
传输时延阶段是管道的第一个阶段,由总线链路的 “txdel model” 属性指定。它在数据包开始传输时立即被调用。这是唯一一个只需执行一次即可支持由一次新传输产生的所有管道的阶段(即该计算由所有由此产生的管道共享)。
调用该阶段是为了计算整个数据包完成传输所需的时间。这一结果是数据包第一个比特开始传输与最后一个比特完成传输之间的仿真时间差。仿真内核使用该阶段提供的结果,为发送该数据包所用的发射机信道安排一个传输结束事件。当该事件发生时,如果信道的内部队列中还有数据包,发射机可以开始传输下一个数据包;否则发射机信道变为空闲。此外,传输时延结果与传播时延阶段的结果结合使用,用于计算数据包在链路目的地完成接收的时刻(即最后一个比特到达完毕的时刻,等于其传输完毕的时刻加上链路上的传播时延)。
仿真内核要求传输时延阶段过程只接受一个数据包地址作为其唯一参数。计算得到的传输时延随后应由内核在符号常量 OPC_TDA_BU_TX_DELAY 所表示的 TDA 中获得。所赋的值应为一个非负的双精度浮点数。不需要其他结果。该阶段的语法要求见图 234。
图 234:总线管道模板:传输时延阶段
串行仿真:
void
tx_delay_template (Packet* pk)
	{
	double			result;

	FIN (tx_delay_template (Packet* pk))

	/* extract required information from packet. */

	/* perform calculation of transmission delay. */

	/* place result in TDA to return to Simulation Kernel. */
	op_td_set_dbl (pk, OPC_TDA_BU_TX_DELAY, result);

	FOUT
	}
并行仿真:
void
tx_delay_template_mt (OP_SIM_CONTEXT_ARG_OPT_COMMA Packet* pk)
	{
	double			result;

	FIN_MT (tx_delay_template (Packet* pk))

	/* extract required information from packet. */

	/* perform calculation of transmission delay. */

	/* place result in TDA to return to Simulation Kernel. */
	op_td_set_dbl (pk, OPC_TDA_BU_TX_DELAY, result);

	FOUT
	}
阶段 1:链路闭合
链路闭合阶段是管道的第二个阶段,由总线链路的 “closure model” 属性指定。它对连接到总线上的每个接收机各调用一次。这些调用发生在传输时延阶段返回之后,两者之间没有仿真时间流逝。该阶段的目的是判断某个特定接收机是否能够接收一次传输。接收传输的能力被称为发射机与接收机之间的链路闭合,阶段名称即由此而来。
仿真内核期望该阶段提供一个整数值。内核使用该结果来决定是否为所讨论的特定接收机继续执行总线管道的其余部分。如果该整数值等于符号常量 OPC_TRUE,则链路闭合建立,发射机与接收机之间的通信成为可能;否则应使用值 OPC_FALSE 表示通信不可能。
仿真内核要求链路闭合阶段过程只接受一个数据包地址作为其唯一参数。链路闭合的指示随后应由内核在符号常量 OPC_TDA_BU_PROP_CLOSURE 所表示的 TDA 中获得。不需要其他结果。该阶段的接口要求见图 235。
图 235:总线管道模板:链路闭合阶段
串行仿真:
void
closure_template (Packet* pk)
	{
	int			result;

	FIN (closure_template (Packet* pk))

	/* extract required information from packet. */

	/* perform calculation of closure indication. */

	/* place result in TDA to return to Simulation Kernel. */
	op_td_set_int (pk, OPC_TDA_BU_CLOSURE, result);

	FOUT
	}
并行仿真:
void
closure_template_mt (OP_SIM_CONTEXT_ARG_OPT_COMMA Packet* pk)
	{
	int			result;

	FIN_MT (closure_template (Packet* pk))

	/* extract required information from packet. */

	/* perform calculation of closure indication. */

	/* place result in TDA to return to Simulation Kernel. */
	op_td_set_int (pk, OPC_TDA_BU_CLOSURE, result);

	FOUT
	}
阶段 2:传播时延
传播时延阶段是管道的第三个阶段,由总线链路的 “propdel model” 属性指定。它对连接到总线上的每个接收机各调用一次;该调用发生在链路闭合阶段返回之后,两者之间没有仿真时间流逝。该阶段的目的是计算数据包信号从总线发射机传播到总线接收机所需的时间。这一结果通常取决于物理介质的类型、源点与目的地之间的距离以及信号的频率等因素。无论涉及哪些因素,仿真内核都期望该阶段提供一个双精度浮点值。内核使用该结果,为数据包所去往的接收机信道安排一个接收开始事件。此外,传播时延结果与传输时延阶段的结果结合使用,用于计算数据包完成接收的时刻(即最后一个比特到达完毕的时刻,等于数据包开始传输的时刻加上传输时延与传播时延之和)。
仿真内核要求传播时延阶段过程只接受一个数据包地址作为其唯一参数。计算得到的传播时延随后应由内核在符号常量 OPC_TDA_BU_PROP_DELAY 所表示的 TDA 中获得。所赋的值应为一个非负的双精度浮点数。不需要其他结果。该阶段的接口要求见图 236。
图 236:总线收发器管道模板:传播时延阶段
串行仿真:
void
prop_delay_template (Packet* pk)
	{
	double			result;

	FIN (prop_delay_template (Packet* pk))

	/* extract required information from packet. */

	/* perform calculation of propagation delay. */

	/* place result in TDA to return to Simulation Kernel. */
	op_td_set_dbl (pk, OPC_TDA_BU_PROP_DELAY, result);

	FOUT
	}
并行仿真:
void
prop_delay_template_mt (OP_SIM_CONTEXT_ARG_OPT_COMMA Packet* pk)
	{
	double			result;

	FIN_MT (prop_delay_template (Packet* pk))

	/* extract required information from packet. */

	/* perform calculation of propagation delay. */

	/* place result in TDA to return to Simulation Kernel. */
	op_td_set_dbl (pk, OPC_TDA_BU_PROP_DELAY, result);

	FOUT
	}
阶段 3:冲突
冲突阶段占据总线收发器管道中的第四个位置,由总线链路的 “coll model” 属性指定。与其他管道阶段不同,它可能在某个管道序列内被执行多次,也可能完全不执行。每当所关注的数据包经历一次新的冲突时,该阶段就会被调用;当所关注的数据包最初到达接收机、而同一信道上已有另一个数据包开始到达时,或者当所关注的数据包已经开始到达、而另一个数据包开始到达时,就认为发生了一次冲突。换言之,冲突是所涉两个数据包共同经历的对称事件。当一次冲突发生时,会生成对冲突阶段的一次调用,以同时支持这两个数据包的管道。由于在一个数据包的接收时间内总线上可能发生任意数量的传输,一个数据包可能经历多次冲突。
冲突阶段的目的是让应用专用模型了解冲突情况。仿真内核不期望被调用的管道过程产生任何特定结果。不过,内核确实保留了一个 TDA 来记录数据包经历的冲突次数,因为这是大多数管道(包括默认阶段)的典型需求。这个 TDA 由符号常量 OPC_TDA_BU_NUM_COLLS 表示,并在数据包传输时初始化为零。通常,如果判断某次冲突与数据包后续的处理有关联,那么该阶段中的逻辑会将 TDA OPC_TDA_BU_NUM_COLLS 的值加一。
仿真内核要求冲突阶段过程接受两个数据包地址作为参数。第一个数据包地址是先到达的数据包的地址,第二个地址是触发本次冲突的后到达的数据包的地址。该阶段的接口要求见图 237。
图 237:总线收发器管道模板:冲突阶段
串行仿真:
void
collision_template (Packet* earlier_pk, Packet* later_pk)
	{
	FIN (collision_template (earlier_pk, later_pk))

	/* Test for collision; update TDAs if appropriate */
	op_td_increment_int (earlier_pk, OPC_TDA_BU_NUM_COLLS, 1);
	op_td_increment_int (later_pk, OPC_TDA_BU_NUM_COLLS, 1);

	FOUT
	}
并行仿真:
void
collision_template_mt (OP_SIM_CONTEXT_ARG_OPT_COMMA Packet* earlier_pk,
	Packet* later_pk)
	{
	FIN_MT (collision_template (earlier_pk, later_pk))

	/* Test for collision; update TDAs if appropriate */
	op_td_increment_int (earlier_pk, OPC_TDA_BU_NUM_COLLS, 1);
	op_td_increment_int (later_pk, OPC_TDA_BU_NUM_COLLS, 1);

	FOUT
	}
阶段 4:误码分配
误码分配阶段是管道的第五个阶段,由总线链路的 “error model” 属性指定。它在整个数据包在目的地完成接收之后被调用,用于估计发生的误码数量。这被称为把差错分配给数据包。这一结果通常取决于反映链路质量的误码概率和数据包长度。这一计算通常不包括由冲突引起的差错。
内核使用该阶段的结果为接收机信道对象报告差错统计。此外,该结果通常由总线链路管道的最后阶段使用,以决定是否接受该数据包,并随后通过接收机信道的输出流将其转发。
仿真内核要求误码分配阶段过程只接受一个数据包地址作为其唯一参数。计算得到的影响数据包的差错数量随后应由内核在符号常量 OPC_TDA_BU_NUM_ERRORS 所表示的 TDA 中获得。所赋的值应为一个介于零和数据包长度之间(含两端)的整数。不需要其他结果。该阶段的接口要求见下图。
图 238:总线管道模板:误码分配阶段
串行仿真:
void
error_alloc_template (Packet* pk)
	{
	int			result;

	FIN (error_alloc_template (Packet* pk))

	/* extract required information from packet. */

	/* perform estimation of number of errors in packet. */

	/* place result in TDA to return to Simulation Kernel. */
	op_td_set_int (pk, OPC_TDA_BU_NUM_ERRORS, result);

	FOUT
	}
并行仿真:
void
error_alloc_template_mt (OP_SIM_CONTEXT_ARG_OPT_COMMA Packet* pk)
	{
	int			result;

	FIN_MT (error_alloc_template (Packet* pk))

	/* extract required information from packet. */

	/* perform estimation of number of errors in packet. */

	/* place result in TDA to return to Simulation Kernel. */
	op_td_set_int (pk, OPC_TDA_BU_NUM_ERRORS, result);

	FOUT
	}
阶段 5:差错纠正
差错纠正阶段是管道的第六个也是最后一个阶段,由总线链路的 “ecc model” 属性指定。它在误码分配阶段返回之后立即被调用,两者之间没有仿真时间流逝。该阶段的目的是判断到达的数据包能否被接受,并通过信道相应的输出流转发到目的节点中接收机的某个相邻模块。这通常取决于数据包是否经历了冲突、误码分配阶段计算得到的结果,以及接收机纠正影响该数据包的差错的能力(阶段名称即由此而来)。根据该阶段的判断,内核要么销毁数据包,要么允许其进入目的节点。此外,该结果会影响为接收机信道收集的差错与吞吐量统计。
仿真内核要求差错纠正阶段过程只接受一个数据包地址作为其唯一参数。接受或拒绝数据包的决定随后应由内核在符号常量 OPC_TDA_BU_PK_ACCEPT 所表示的 TDA 中获得。所赋的值应为等于常量 OPC_TRUE 的整数以表示接受;否则应赋整数值 OPC_FALSE。不需要其他结果。该阶段的接口要求见下图。
图 239:总线管道模板:差错纠正阶段
串行仿真:
void
error_correction_template (Packet* pk)
	{
	int			result;

	FIN (error_correction_template (Packet* pk))

	/* extract required information from packet. */

	/* determine if packet should be accepted or rejected. */

	/* place result in TDA to return to Simulation Kernel. */
	op_td_set_int (pk, OPC_TDA_BU_PK_ACCEPT, result);

	FOUT
	}
并行仿真:
void
error_correction_template_mt (OP_SIM_CONTEXT_ARG_OPT_COMMA Packet* pk)
	{
	int			result;

	FIN_MT (error_correction_template (Packet* pk))

	/* extract required information from packet. */

	/* determine if packet should be accepted or rejected. */

	/* place result in TDA to return to Simulation Kernel. */
	op_td_set_int (pk, OPC_TDA_BU_PK_ACCEPT, result);

	FOUT
	}