数据包传输机制
数据包很少作为静态存储项而仅仅停留在某一个物理或逻辑上下文中。相反,它们几乎总是被动态创建,以便在上下文之间传递信息。仿真内核提供了多种机制来支持基于数据包的通信。根据发起传输的上下文与接收数据包的上下文之间的关系,可以选择一种或多种合适的机制。
数据包流
数据包流是支持同一节点内模块之间数据包传输的物理连接。数据包流定义在源模块的输出端口与目标模块的输入端口之间。这些端口通常分别称为源模块的输出流和目标模块的输入流。
每个模块可以拥有任意数量的输入流和任意数量的输出流。不允许“扇入”和“扇出”;也就是说,每个输入流只能是一个数据包流对象的接收方,每个输出流只能是一个数据包流对象的源。不过,任何或全部输入流和输出流都可以保持未连接状态。
输入流处的排队
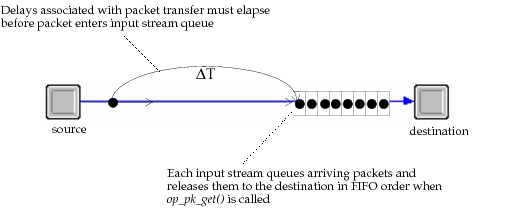
每个数据包流包含一个数据包队列;该队列与目标模块的输入流相关联,使数据包可以等待,直到目标模块准备好通过调用 op_pk_get() 获取它们。仿真内核不限制数据包流队列可容纳的数据包数量。数据包按到达顺序维护,并且由于目标模块只能获取该队列的队头(通过调用内核过程 op_pk_get()),因此该队列可以视为先进先出(FIFO)队列。
图 210:数据包流中的排队
中断方式
如果数据包流的源模块是处理器或队列,它可以通过调用内核过程 op_pk_send() 的四种变体中的任意一种,将其拥有的数据包发送到数据包流的目标模块。这些内核过程各自以略有不同的行为实现传输,说明如下。
-
op_pk_send():这种数据包传输形式称为标准数据包发送,因为它是最常用的方式。调用op_pk_send()会为目标模块调度一个流事件,以指示新数据包的到达;该事件的时间为当前时间加上数据包流“delay”属性的值。如果该属性的值为零(即默认值),则流事件被调度在当前时间。请注意,整个系统中的模块优先级,以及目标模块处的中断优先级,会影响该事件相对于调度在同一时间的其他事件的执行顺序。在为目标模块中某个进程生成流中断之前,仿真内核会将传输的数据包插入输入流队列的尾部。如果此时队列中没有其他数据包,则目标进程只需一次调用
op_pk_get()即可获得该数据包;否则需要多次调用该内核过程才能获得该数据包。目标进程也可以选择忽略新到达的数据包,将其留在输入流队列中。请注意,如果中断无法送达目标进程,数据包仍会留在队列中,从而可以在稍后获取。 -
op_pk_send_delayed():这种形式与标准数据包发送类似,同样使用事件调度,并为目标模块中合适的进程生成中断。不过,内核过程op_pk_send_delayed()支持指定一个正的延迟值,使数据包在目标输入流处的到达额外推迟一段时间。表示传输数据包到达目标的流事件发生在当前时间加上指定延迟与数据包流“delay”属性值之和的时刻。这种数据包传输形式的其他所有方面与使用op_pk_send()完全相同。**注意:**由于
op_pk_send_delayed()允许在每次调用时独立设置延迟值,因此在给定流的目标处,数据包的到达顺序可能与使用此内核过程发送的顺序不一致。 -
op_pk_send_forced():这种数据包传输形式不使用事件调度。它会使发送进程挂起,立即将数据包排入输入流,并为目标模块生成一个事件。无论该事件是否导致目标模块的某个进程收到中断,数据包都会保持在队列中。强制数据包传输不允许任何延迟,因此数据包流的“delay”属性会被忽略。请注意,只有在目标进程阻塞之后,发送进程才会恢复执行。关于强制事件的一般行为说明,请参见第 4 章“建模框架”第 80 页。
-
op_pk_send_quiet():这种数据包传输形式用于避免为目标模块的任何进程生成中断。换句话说,该内核过程的唯一实际效果是将传输的数据包放到数据包流队列的末尾。数据包以即时方式插入队列(即该动作不被调度,可以认为在内核过程调用返回时已经完成)。op_pk_send_quiet()最常与访问中断配合使用,以便立即转发数据包作为响应。在这种情况下不能使用内核过程op_pk_send_forced(),因为这会在源模块与目标模块之间形成强制事件反馈环;这是因为由内核过程op_strm_access()生成的访问中断也是强制中断。该内核过程有时也被用作减少数据包传输所导致的中断总数的手段。为此采用的一般技术是:先连续使用
op_pk_send_quiet()转发大量数据包,然后使用op_pk_send()或op_pk_send_forced()传输一个数据包。因最后一次数据包传输而被中断的进程随后通过调用op_strm_empty()和op_strm_pksize()确定其输入流中包含的数据包数量。被中断的进程可以利用这些信息决定提取部分还是全部已传输的数据包。
数据包投递
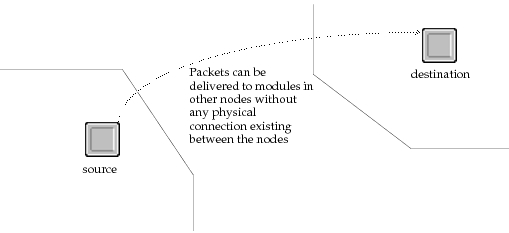
数据包流只支持同一节点内模块之间的通信。如果模块仅使用这种数据包传输方式,就必须依赖发射机和接收机在节点之间传递数据包。然而在某些情况下,将所有直接相互传输数据包的节点都连接起来并不方便。此外,某些系统中通信节点本会依赖中间节点转发数据包,但通过抽象地允许直接通信(即使不存在物理连接),有时可以更准确、更简单地建模。为支持此类系统的建模,Modeler 提供了一种称为数据包投递的机制,允许任何处理器或队列模块直接向任何其他处理器或队列模块传输数据包,而不论物理位置如何。
图 211:未连接节点的模块之间的数据包投递
数据包投递机制
就机制的目标端而言,数据包投递的运作与通过流的数据包发送类似。换句话说,数据包被插入目标模块某个输入流的队列中,并且根据所选的中断方式,可能会生成一个事件。
要发起数据包投递,进程可以调用内核过程 op_pk_deliver()、op_pk_deliver_delayed()、op_pk_deliver_forced() 和 op_pk_deliver_quiet() 中的任意一个。所需的中断方式可以通过使用正确的内核过程来指定。这四个投递内核过程与前一节中介绍的相应名称的基于流的内核过程具有相同的行为。
由于目标模块不像数据包流那样与源模块隐式关联,因此在发起数据包投递时必须显式指定目标模块。因此,支持数据包投递的每个内核过程都期望提供目标模块的对象 ID。确定目标模块对象 ID 的方法有很多种;这些方法由仿真内核的 Id 和 Topo 包的内核过程支持。
类似地,数据包将要投递到的输入流也必须在请求投递时显式指定。输入流由整数索引标识。数据包可以投递到任何输入流,包括那些已连接到数据包流对象的输入流和未连接的输入流。请注意,向索引超过最高已连接输入流索引的输入流投递,会导致为每个中间索引分配内存;虽然每个索引的内存量很小,但由于总分配量随最大索引线性增长,总量可能很大。
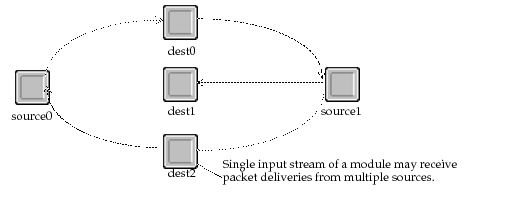
由于数据包投递操作彼此独立,因此特定输入流的源不存在“扇入”限制。换句话说,任意数量的源都可以向同一输入流投递数据包。当然,一个源也可以向多个输入流投递数据包。
图 212:数据包投递机制的扇入与扇出
通信链路
数据包由模块创建后,可以在同一节点内传输到另一个模块;该模块又可以将其传输到同一节点内的第三个模块。但在许多情况下,数据包最终必须传输到其他节点中的模块。前一节介绍了使用数据包投递在节点之间传输数据包的方式。数据包投递是物理链路的抽象表示,当链路的存在无法预先知晓,或仿真精度不需要链路的实际物理特性时,它可能很有用。Modeler 还支持对物理链路更直接的表示,即两种类型的通信链路模型,称为点对点链路和总线链路(借助无线功能还可以使用无线链路,如第 2 章“Modeling Wireless Networks”第 3 页所述)。
点对点链路
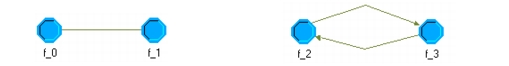
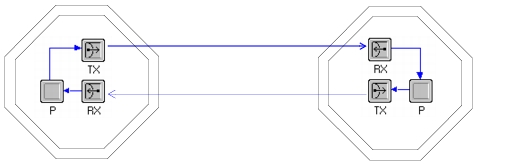
点对点链路允许在一对节点之间传输数据包。提供两种类型的点对点链路:单工点对点链路,支持将数据包从一个节点中的发射机传输到另一个节点中的接收机;以及双工点对点链路,将一个节点中的发射机-接收机对与另一个节点中的发射机-接收机对连接起来。双工链路相当于两个方向相反的单工链路。
图 213:等效的双工与单工点对点链路配置
要使点对点链路可以工作,它必须连接到其所连接节点中的点对点发射机和接收机。单工点对点链路的发射机和接收机通过其“transmitter”和“receiver”对象属性指定;对于双工链路,四个属性(“transmitter a”、“receiver a”、“transmitter b”和“receiver b”)用于标识链路所连接节点内的模块。收发模块从建模角度看非常重要,因为它们分别代表数据包在发送节点和接收节点中的出口和入口。换句话说,发射机模块可以视为数据包前往远程节点的“网关”。要向通过点对点链路连接的远程节点发送数据包,模块只需将数据包发送到其自身节点中正确的点对点发射机模块;发射机随后负责将数据包传送到所连接点对点链路的另一端的接收机。
图 214:发射机和接收机充当与其他节点之间往来的网关
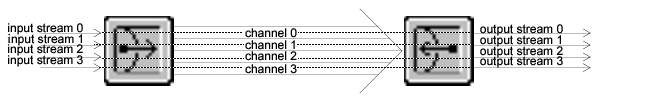
每条点对点链路都可以视为一个“束”,代表其所连接的发射机与接收机之间的一条或多条通信信道。链路中信道的数量由所连接的发射机和接收机对象的“channel count”属性决定。每条信道独立于同一链路中的其他信道运作,就好像它是在一条独立的并行单工链路中定义的一样。不过,将信道捆绑在一起的能力是为了更方便地定义多信道干线。
点对点链路的信道可以视为源节点中点对点发射机的某个端口与目标节点中点对点接收机的某个端口之间的管道。端口由数字索引引用,并分别直接对应发射机和接收机的输入流与输出流。换句话说,可以通过将数据包发送到链路源端发射机的第 n 个输入流,使用该链路的第 n 条信道传输该数据包。在链路目标端,到达的数据包由接收机通过其第 n 个输出流发出。
下图展示了数据包的流动。
图 215:输入流、信道与输出流之间的对应关系
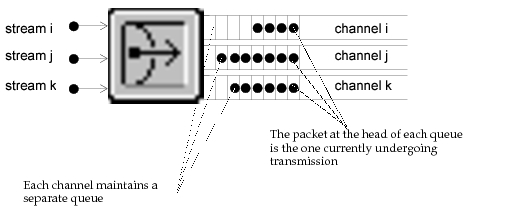
每条信道的发送侧都包含一个简单的先进先出队列。该队列的目的是调节信道中的传输,使得在任何给定时间只传输一个数据包的内容。由于数据包通常需要非零的传输时间,后到的其他数据包必须等待前一个数据包的传输完成后才能开始自己的传输。由于 FIFO 队列没有容量限制,这一机制允许以任意速率将数据包转发到发射机模块的输入流,同时仍遵守各个传输的正确时序。
图 216:发射机信道的内置排队
两种点对点链路都可以配置为以多种方式影响数据包传输。每条链路的底层是一系列称为管道阶段的用户可定义模型。一般而言,管道阶段执行与数据包传输相关的计算,以决定接收时间以及数据包是否被正确接收。管道阶段的完整运作和规格说明在管道阶段定义中描述。不过,一般而言,管道阶段可以利用链路的属性来执行所需的计算。特别地,大多数管道阶段实现使用点对点链路属性“ber”和“delay”,它们分别表示比特被错误接收的概率和链路上信号的传播延迟。此外,信道对象的“data rate”属性通常也会被一个或多个管道阶段考虑。
总线链路
总线链路允许一次数据包传输自动传播到多个目的地。这类链路通常用于表示局域网、计算机总线或其他基于广播的网络。此外,由于数据包广播可以限制在连接到总线的节点子集内,甚至可以限制为一个目的地,因此总线链路可用于表示高度互联的网络,或以点对点链路难以表示的动态互联网络。
与点对点链路一样,节点通过专用的发射机和接收机模块连接到总线链路。在这种情况下,必须使用总线发射机和总线接收机模块。连接是通过使用第三个对象(称为抽头)将节点连接到链路来形成的。抽头具有“transmitter”属性和“receiver”属性,必须用于指定节点内的收发器。
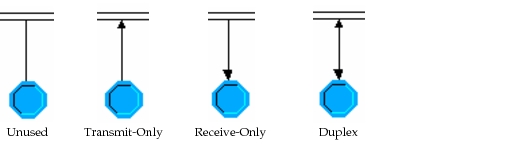
大多数抽头的“transmitter”和“receiver”属性都设置为非空值,允许数据包在总线与节点之间双向传输。不过,也可以将其中任一属性留空(实际上可以赋值 NONE)以创建单向抽头。如果只指定接收机名称,该抽头称为仅接收;如果只指定发射机名称,则称为仅发送。仅接收抽头有时用于监视总线链路的状态、了解其他节点的活动或收集结果。仅发送抽头可以用于例如某个控制节点,它周期性地发出同步信号,且无需从其他节点接收信息。
根据抽头配置为仅接收、仅发送还是双向,它们在定义抽头的 Network Editor 中的绘制方式不同。下图展示了四种可能的表示(可以创建既无发送也无接收能力的抽头,尽管这没有用处)。
图 217:总线抽头配置
发送的数据包可以在总线链路上同时向两个方向传播。节点之间的物理距离可以被纳入各个接收机到达时间的计算。该计算通常还基于总线链路的“delay”属性,该属性表示信号传播一米距离所需的时间(以秒计)。因此,一次数据包传输可能导致在各个总线接收机处时间错开的到达。
与点对点链路由独立的信道束组成一样,总线链路也可以充当多个独立的广播介质。总线链路中信道的数量由所连接的总线发射机和总线接收机模块的“channel count”属性决定。当在总线发射机的第 n 条信道上传输数据包时,连接到该总线且信道数量足够(即信道数量大于 n,因为信道索引从零开始)的所有总线接收机都会接收该数据包。信道数量不足的接收机不受该传输的影响。那些受影响且正确接收数据包的接收机通过其第 n 个输出流将数据包发给相邻模块。
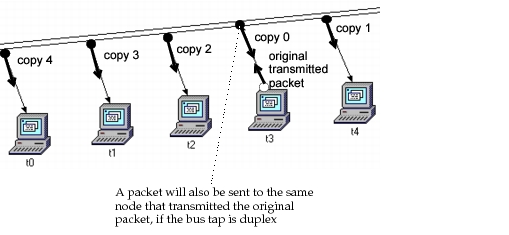
在数据包传输方面,总线链路信道的行为与点对点链路信道完全相同。换句话说,每条信道都包含一个容量无限的队列,可以以任意速率接收数据包,然后数据包一次一个地传输到总线链路上。当数据包被传输时,每个符合条件的接收机都会收到该数据包的一个独立副本。这使得每个接收机可以对数据包是否被正确接收做出独立判断。此外,如果多个接收机都正确接收了数据包,则这些独立副本可以被分别操作(例如修改、销毁、重发)而互不影响。
下图展示了与总线链路广播相关的数据包复制。
图 218:总线链路上发送数据包的复制
总线链路支持冲突的概念,它对应于两个或多个到达的数据包同时出现在同一总线接收机的同一信道上。由于一般而言数据包的传输和接收都需要非零的时间(即从第一个比特的传输到最后一个比特的传输所测得的时间),因此数据包在一个有限的时间区间内可以被视为正在“到达”某个接收机。如果另一个数据包在另一个数据包的接收区间完成之前开始到达,则这两个数据包被视为发生了冲突。总线接收机信道将保持冲突状态,直到其中一个数据包完成其接收区间,只剩下另一个数据包存在。
由于数据包冲突发生在接收机处,因此传播延迟以及节点在总线链路上的相对位置可能在决定冲突是否发生方面发挥作用。总线链路模型会自动考虑这一影响,因为每个数据包的到达都基于这些参数进行调度,并且冲突只在数据包到达时确定,而不是在发送时确定。
一般而言,冲突被视为破坏性事件,会阻止所涉任一数据包的正确接收。这是总线链路提供的默认行为。不过,与点对点链路一样,可以通过修改底层模型或管道阶段来自定义总线链路的行为。这些阶段可以被配置为以不同方式解释冲突;例如,如果冲突的总持续时间小于定义的阈值,则可以认为冲突不具有破坏性影响。总线链路管道阶段的一般理论和使用在总线收发器管道中描述。
物理链路的一致性
并非所有放置在节点之间的链路都是有效的。Modeler 只认为某些链路配置正确并可用于数据包传输。有效的点对点或总线链路称为一致;无效的点对点或总线链路称为不一致。不一致的链路在仿真期间不支持数据包流动。为确定每条链路的一致性,Modeler 使用预定义的标准,将其应用于链路对象,以及在适用情况下分配到链路两端的收发器对象。一致性与构成连接的各组件之间的兼容性有关:这些组件包括传输数据速率、支持的协议以及支持的信道数量。关于链路一致性如何评估的深入说明,请参见第 7 章“网络域”第 292 页。
链路模型定义
Modeler 提供了多种类型的链路;每种类型支持两个或多个节点之间不同形式的通信。对于以对象表示的链路(即点对点、总线和总线抽头),Modeler 使用模型的概念来更好地处理大量对象。链路模型使用链路编辑器指定。关于链路编辑器的更多信息,请参见第 8 章“Link Editor”第 508 页。
如第 4 章“建模框架”第 80 页所述,模型是一个类定义,可用于创建符合特定规格的实例。在这种情况下,链路对象是链路模型的实例。这与节点和节点模型之间的关系相同。不过,与节点不同,链路不是由底层对象组成的。关于链路行为的所有规格说明都包含在一组属性中。属性可以指定链路的传播延迟、错误率以及它所连接的收发器(如有)等特性。此外,属性用于选择一系列底层 C 语言过程(称为管道阶段),它们实现链路的多数计算和决策。虽然每种类型链路的管道架构是固定的,但可以向其插入用户定义的管道过程以实现自定义的链路行为(关于收发器管道如何工作的说明,请参阅本节后面的部分)。换句话说,链路对象的规格完全通过属性控制,因此链路模型主要由如何配置这些属性来定义。这是通过一种称为属性接口的规格机制完成的,类似于节点模型中包含的规格。属性接口在链路属性接口与派生链路模型中以链路特有的方式做了简要说明。
链路属性接口与派生链路模型
本节描述链路模型开发者如何使用一种称为模型属性接口的机制来控制内置链路属性,并指定链路模型向模型用户呈现的接口的各个方面。本节中的概念在第 4 章“建模框架”第 80 页中以更通用、更完整的方式进行了说明。
链路属性接口的作用是规定从在网络域中使用该模型的用户角度看,链路模型呈现为什么样子。属性接口包含若干组件,其中最重要的是属性接口描述。这将在下面的小节中说明;第二小节简要说明其他组件。
链路属性接口描述
如前所述,链路模型不包含对象。因此没有可以传递到项目域中链路对象的对象提升属性。因此,链路(相对于节点)的接口描述作用更为简单。对于链路,接口描述只适用于链路对象的内置属性。换句话说,可以通过这一机制控制链路的“delay”或“data rate”等属性。管道阶段属性(如“txdel model”(传输延迟模型))也可以受到影响。使用属性接口的 Attribute Interface Descriptions 组件,链路模型开发者可以对链路模型提供的属性应用以下类型的更改:
表 97:链路属性接口描述提供的控制
| 机制¹ | 说明 |
|---|---|
| 属性重命名 | 从链路模型用户的角度为属性提供新名称。这是在网络域的链路对象上看到的属性名称。 |
| 属性合并 | 用一个新属性替换一组属性。底层属性被绑定在一起,对新属性的更改会传播到其中每一个属性。 |
| 属性特性更改 | 某些属性特性可以更改,包括范围、符号映射、注释和默认值。 |
| 属性状态更改 | 属性可以具有三种状态值之一:promoted(提升)、set(设定)或 hidden(隐藏)。promoted 属性在没有值的情况下出现在链路对象上。set 属性以链路模型开发者预先选定的值出现在链路对象上;不过可以按链路逐个更改。hidden 属性具有指定的值,但在链路对象上不可见,因此无法更改。 |
| 属性指定 | Modeler 允许你更改用户更改链路属性设置时的默认行为。你可以点击 ETS Handlers 按钮指定自定义 ETS 库和事件处理程序。 |
注 1:关于本表中各机制(属性指定除外)的深入讨论,请参见第 4 章“建模框架”第 80 页。
图 219:链路模型的属性接口描述
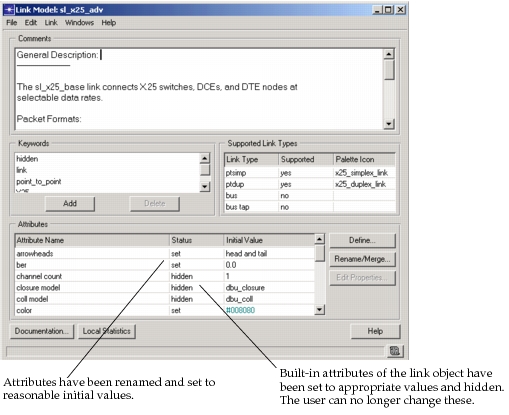
其他链路模型接口
链路模型属性接口还重新组合了链路接口的其他几个部分,尽管它们与属性无关。这些内容列于下表。
表 98:其他链路模型接口
| 接口 | 说明 |
|---|---|
| Keywords(关键字) | 每个链路模型都可以携带一组关键字,用于标识其与特定网络建模工作的相关性。Network Editor 的用户可以指定感兴趣的关键字,以便在编辑器的 Object Palette 中只显示对其有用的模型。 |
| Comments(注释) | 链路模型的文本描述,允许链路模型开发者向模型用户提供所需的信息。注释中的信息通常包括:链路模型功能(即它表示哪种现实世界的链路);影响链路一致性的因素;主要属性的意义等。 |
| Supported Link Type(支持的链路类型) | 指定该模型能否用于单工点对点、双工点对点、总线、总线抽头或这些类型的任意组合。 |
关于详细说明,请参见第 4 章“建模框架”第 80 页。
链路模型派生
在某些情况下,链路模型开发者甚至模型用户会发现,现有链路模型具备他们需要的所有能力,但同时又为模型用户提供了过多的灵活性。提供额外能力看似不是问题,但实际上可能因各种原因而不理想,下表列出了这些原因。
表 99:特化链路模型的原因
| 问题 | 详情 |
|---|---|
| 复杂性可能让最终用户不堪重负 | 模型越灵活、参数化程度越高,最终用户配置起来就越复杂。在许多情况下,通用模型的参数对最终用户来说并不熟悉,为每个实例配置所需的工作量会超出最终用户的知识范围。如果可以预先指定属性值并满足用户的要求,那么链路模型在网络层面的部署将容易得多。 |
| 灵活性可能导致无效配置 | 大量属性的存在可能使用户有机会创建配置无效的链路。 |
| 最终用户期望特定的呈现 | 链路模型的最终用户通常期望一个与其对类似现实世界链路或其他模型的经验相匹配的特定接口。如果能够实现这一接口,模型将更加“用户友好”。 |
在这些问题情形下,用户寻求的是可以称为链路模型的特化。链路模型的特化版本不那么通用和灵活,但针对特定应用(或至少比原始模型更具体的应用)的需求进行了定制。为创建链路模型的特化,Modeler 提供了一种称为模型派生的机制。模型派生允许将链路模型属性接口中可用的机制应用于现有链路模型。此操作的结果是一个新的、更受限的链路模型,称为派生模型,它依赖于原始模型,原始模型称为父模型。
关于模型派生的更多信息,请参见第 4 章“建模框架”第 80 页。