统计量提升
上一节讨论的定制与控制问题,不仅存在于节点模型的属性上,也存在于统计量上。本节介绍节点开发者用于控制节点模型使用者可见统计量的机制。
节点层面上的大多数模块都提供一组内置统计量。其中一些统计量由 Simulation Kernel 自动计算并提供。此外,进程模型可以声明并计算特定应用的统计量,这些统计量作为其所属 queue 和 processor 模块的本地输出统计量出现。这些统计量来源合并成一个列表,即该节点模型能够报告的统计量集合。
一般来说,节点模型的统计量并非都是其使用者关心的。模块的许多内置统计量对特定应用而言并不相关或有用。此外,进程模型可能计算出只在非常特定情形下才有用的专用统计量。为了避免大量统计量的复杂性让节点模型使用者难以承受,节点模型开发者需要能够剔除他认为不重要的统计量。事实上,由于一个节点的统计量中大多数通常都是不需要的,Modeler 默认假定每个统计量都不应出现在节点模型的接口中。因此必须显式指定所需的统计量,Modeler 通过一种称为统计量提升(statistic promotion)的机制提供这一能力。统计量提升只是向 Modeler 表明:某个模型应当向使用者提供某个特定的统计量。被提升的统计量随后就可以被指派给节点统计量探针,用于在仿真期间采集数据。关于节点统计量探针的更多信息,见第 10 章“Simulation Design”第 375 页。
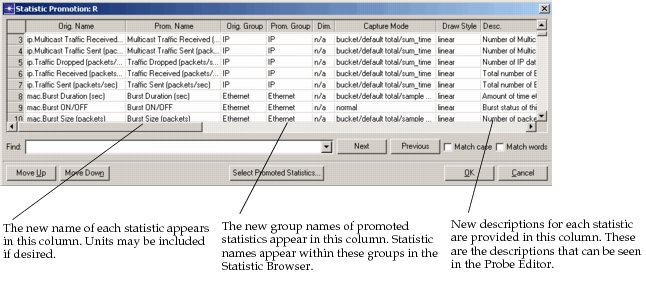
对于每一个被提升的统计量,节点模型开发者都有机会对其呈现方式做三项更改。第一,可以更改统计量的名称,使其对特定应用更有意义。具体而言,默认情况下,每个统计量的名称都以其生成模块的名称作为前缀。这是为了区分与不同模块关联的同名统计量。但是,模块名称可能让节点模型使用者困惑,尤其是不了解节点内部结构的 Riverbed 其他分析软件产品的使用者。因此,在几乎所有情况下,提升统计量时都会对其名称做一些调整。
第二项可做的更改是统计量所属的组(group)。提升统计量组使节点模型开发者能够把统计量组织成由开发者定义的逻辑分组。这让使用者在 Project Editor 中选择 Choose Results 时更容易查找和查看统计量。把统计量分组还使模型开发者能够在不同上下文中对相似的统计量重复使用相同的描述性名称(例如 “Throughput (bits/sec)”)。
第三项可做的更改是替换与该统计量关联的描述性注释。这些注释充当该统计量的文档,可以针对预期的最终用户加以定制。
节点统计量提升通过 Node Editor 的 Promote Node Statistics 操作完成。下图展示了支持统计量提升的对话框。
图 174:特化模型 R 以生成派生模型 R’