队列模块
图 159:队列模块使用的标准图标

队列模块提供的功能是处理器模块功能的超集。与处理器一样,队列可以执行任意的进程模型,用以描述某个特定进程或协议的行为,并可以通过数据包流与其他模块连接,从而收发数据包。进程模型同样会影响队列对象的属性列表。上一节关于处理器模块的内容中,有关进程模型与处理器之间关系的说明同样适用于队列。
处理器与队列模块的主要区别在于,队列包含称为*子队列(subqueue)*的额外内部资源,如下图所示。子队列便于对一组数据包进行缓存和管理。虽然用普通处理器模块也可以实现这一功能,但使用子队列,加上操作子队列的内核过程(Kernel Procedure),可以更灵活、更轻松地实现各种排队策略。此外,子队列会自动计算关于其运行情况的若干统计量,可以通过探针(probe)以直接的方式收集这些统计量。更多信息参见“Probe Reference”第 107 页。
图 160:具有 k 个子队列的队列的内部结构
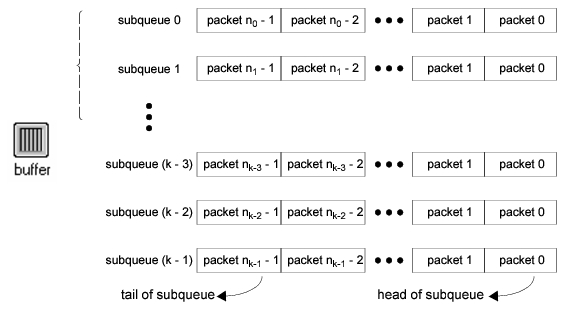
每个队列模块包含数量可定义的子队列。子队列是隶属于队列对象的对象,它拥有自己的属性用于配置。子队列通过队列的“subqueue”复合属性被包含在队列之中。该属性保存一个复合属性对象,它是一个或多个子队列的父对象。有关如何使用复合属性存储从属对象的更多信息,参见“Modeling Framework”第 80 页。
默认情况下,每个子队列容纳数据的能力没有限制,但可以限制子队列内数据包的数量或所有数据包的总大小(或两者兼有)。当子队列变满时采取什么措施,由队列中的进程决定:可以移除数据包以腾出空间给新到达的数据包,或者丢弃新到达的数据包。仿真内核(Simulation Kernel)只是在尝试插入时通知该子队列已无法再接收更多数据包。
与队列模块相关的大多数内核过程直接作用于指定的子队列(例如数据包的插入和删除、访问统计量,或清空子队列)。不过,也有一些内核过程访问的是队列模块整体的属性(例如获取汇总统计量,或清空整个队列模块的内容),或者访问队列模块内某个数据包的属性而不考虑它所在的具体子队列(例如入队时间或等待时间)。有关这些内核过程的更多信息,参见“Queue Package”第 1 页和“Subqueue Package”第 1 页。
由于队列执行的进程模型由用户控制,因此只要定义子队列的访问和管理方式,就可以建模任何排队协议。在模块内部,子队列既可以直接用物理索引选择,也可以通过抽象索引选择;抽象索引使进程模型能够根据某个子队列相对于其他子队列的状态来选择它。例如,可以选择最短的子队列,或者排队延迟最大的子队列。类似地,子队列内的数据包既可以直接按索引编号访问,也可以通过抽象方式获取,即请求子队列头部或尾部的数据包,或者优先级最高的数据包。有关如何利用这些特性实现某种特定排队策略的更多细节,参见建模队列。