进程模型运行机制
节点对象用于表示可以互连成网络的设备。设备的范围可以从简单的流量源一直到运行多个应用的复杂交换机或计算机。节点是作为节点模型的实例创建的,也就是说,节点模型是某一特定类型的所有各个节点的蓝图。节点模型被定义为一组模块的集合,这些模块代表节点中各自独立的功能区域。某些模块所能表示的行为类型是有限制的;例如,各种发射机和接收机表示的是网络域中定义的链路的接口。
有三类模块——称为处理器(processor)、队列(queue)和 esys 模块——支持完全通用的行为建模。就其通用行为以及大多数物理资源而言,这些模块提供的能力基本上是相同的。不过,其中两类还提供了额外能力:
- 队列模块通过对组织化的数据包存储提供专门支持,使用户能够在其中插入和排序数据包、并按一种通用的、用户定义的方法从中提取数据包的内部子队列。
- esys 模块提供排队能力,以及为协同仿真规定一个 ESD 模型的能力。
在大多数情况下,esys 模块、队列和处理器可以被同等对待,因为它们依赖同样的进程建模技术来表示其行为。因此,本手册使用 QP 这一术语来代表这些模块。
进程环境
当一组进程或单个进程被放置于某个 QP 内以完成特定任务时,它们即被定义出来。进程是用进程编辑器(Process Editor)定义的某个进程模型的一个实例。换句话说,每个进程模型可以被指派给一个系统中的许多 QP。所有各个进程实例都被定义为具有相似的特性,但可能在不同的环境中运行。
进程模型执行两种功能之一,具体取决于所在的 QP。如下文所述,进程模型通常表示某个进程的行为模型。然而,esys 模块也可以利用进程模型来处理与外部系统之间的交互。实际上,在协同仿真期间,该进程模型成为 Modeler 与外部系统之间接口的一部分。本节以概括性的方式描述进程执行其功能时所处的上下文。
中断驱动的执行
与 Modeler 模型中的所有其他子系统一样,进程由事件驱动。当一个事件实际投递给某个进程时,它被称为中断,如第 4 章“Modeling Framework”第 80 页中所定义;此时称该进程被中断,意味着它被调用,以便它针对该中断采取某些行动。
进程被中断的原因因进程而异,跨度极大;而大多数进程本身会预期多种类型的中断,它们表示进程必须作出响应的不同情形。因此,进程在被中断后通常采取的第一个行动之一,就是判定发生了哪种类型的中断。随后,可能还需要分析该中断更为细致的属性。取决于中断类型,这些属性可能是输入流或统计量、有了新值的 esys 接口、引起该中断的源模块,或者可能是接口控制信息(ICI)中包含的应用特定信息。第 4 章“Modeling Framework”第 80 页对中断处理有详细说明。
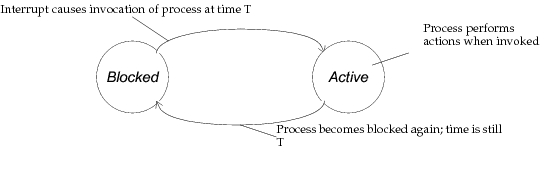
进程遵循被调用与休息交替出现的周期。调用可能基于任意的时机发生,取决于外部和内部所生成事件的时序。进程在仿真开始时总是处于休息模式,等待被调用;处于这种等待状态的进程称为被阻塞(blocked)。调用使进程得以恢复执行并执行新的动作。在这些动作完成之后,进程必须再次阻塞,把执行控制交还给仿真内核,以便系统中的其他事件得以执行。由于这些后续事件可能被调度在任意接近未来的时刻,甚至调度在与当前事件相同的时刻,因此调用必须在不允许任何时间流逝的情况下完成。换句话说,在一次事件的开始和结束时所观察到的仿真时间(例如通过调用内核过程 op_sim_time() 获得)必须始终完全相同。请注意,这一要求并不意味着进程不能建模消耗时间的动作;只是说,对此类动作的建模有时可能需要多个事件。零延迟执行事件的要求以及延迟建模的技术在第 4 章“Modeling Framework”第 80 页中有详细说明。下图描绘了阻塞、调用、活动、再回到阻塞的交替序列。
图 90:进程的阻塞/活动周期
动态进程
在仿真开始的时刻,每个 QP 只承载一个由仿真内核自动创建的进程。这个进程称为根进程(root process),它是 QP 的“process model”属性中所指定的那个进程模型的一个实例。根进程模型可以被设计成管理甚至非常复杂的一组任务,因此视具体应用而定,根进程可能就足以使该 QP 模块具备其预期功能。然而在许多建模场合中,利用 QP 承载多个进程的能力可以提高设计的模块化程度并降低其复杂度。
当 QP 中已经存在的进程通过内核过程 op_pro_create() 请求创建新进程时,这些新进程便与该 QP 模块发生关联。一个 QP 可能承载许多进程,它们协作实现该进程在周围节点模型中的功能。由其他进程创建的进程(相对于由内核创建的根进程)称为动态进程(dynamic processes)。QP 使用动态进程主要有两种典型情形:
- QP 的功能至少有一部分要求它管理以动态方式产生的任务(即其确切时序或数量事先未知)。在这种情形下,可以为每个新出现的任务生成一个新进程。当任务完成时,该进程即可被销毁。由于 QP 中允许存在的进程数量没有上限,因此可以用这种方式处理任意数量的并发任务。动态进程的一个典型应用例子是 X.25 之类面向连接的协议的实现:新的连接基于无法预测其模式的来报请求而打开和关闭。每个连接都可以由一个独立的进程来管理,并且所有连接都可以通过同一个 QP 模块,从而用一个模块表示该协议在节点中的功能。
- QP 的活动可以方便地表示为多个异步运行的进程。所要求的进程可以在 QP 于仿真开始时配置阶段全部创建,并在之后的整个仿真过程中保持不变,每个进程实现 QP 整体功能的一个子集,并可能与其他进程协作以支持它们的活动。通常,当 QP 需要并行管理若干任务、且其中每个任务都与其他任务基本相互独立时,会采用这种方法。
进程层次结构
由于动态进程总是由其他进程创建的,因此根进程必须参与它们的产生。第一代动态进程(即由根进程生成的那些)又可以继续创建新的进程,这些进程称为第二代。相对于创建它的进程而言,动态进程被称为该进程的子进程(child process);反过来,创建它的进程被称为父进程(parent process)。由于所有进程都有创建其他进程的能力,QP 内的进程构成一棵树,其分支表示父进程到子进程的关系。根进程是所有进程的终极“祖父”。
图 91:QP 内典型的进程层次结构
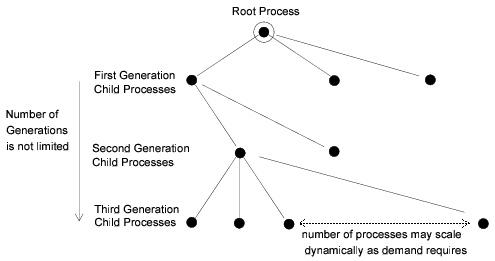
由于进程既可以被创建也可以被销毁,进程层次结构既可能增长也可能收缩。此外,并没有要求一个进程的子进程必须全部先于它自身被销毁;因此在进程层次结构的某些层次上可能出现“空洞”,对应于某些进程没有处于活动状态的父进程这一事实。但请注意,根进程在处理每个 QP 的中断方面扮演着特殊角色,而且是唯一不能被销毁的进程。根进程的作用在后面的中断引导一节中讨论。
请注意,一个进程能够创建任意类型的子进程(即基于任意进程模型的子进程),包括它自己的类型或其父进程的类型;但是,它打算实例化的全部子进程模型清单必须在仿真开始之前作为进程模型定义的一部分声明完毕。试图基于一个未声明的进程模型创建进程,可能导致仿真期间出错。进程编辑器提供了一个称为 Declare Child Process Models 的操作,支持以菜单方式编辑可能的子进程清单。有关该操作的更多信息,参见“System Menus”第 29 页。
子进程的被提升属性会随其父进程的被提升属性一起提升,因而出现在节点层的队列和处理器的属性列表中。子进程的属性以定义它们的进程模型名称作为前缀,以区别于其他同名属性。
共享内存体系结构
当一个 QP 依赖多个进程来实现其功能时,这些进程往往需要在彼此之间进行某种形式的通信,以协作管理 QP 的任务。因此仿真内核提供了三种通信机制,使多个进程能够共享信息。这些机制可以单独使用,也可以组合使用。
-
QP 级共享内存:这种形式的内存也称为模块内存(module memory),它允许 QP 进程层次结构中的所有进程把信息放入一个公共区域,从而彼此传递信息。每个 QP 维护一个内存地址,进程可以通过调用内核过程 op_pro_modmem_install() 和 op_pro_modmem_access() 来赋值或获取该地址。 使用这一机制的各个进程必须就共享内存指针所指向的数据格式达成一致。通常的做法是定义一个所有进程都可以引用的数据结构。为确保所有进程即使在该结构被更改时也使用一致的数据结构形式,该定义应当保存在一个外部定义文件中,并在每个进程的 header 块中将其包含进来;在 C 语言中,定义文件以“
.h”作为后缀。图 92:QP 级共享内存的协调
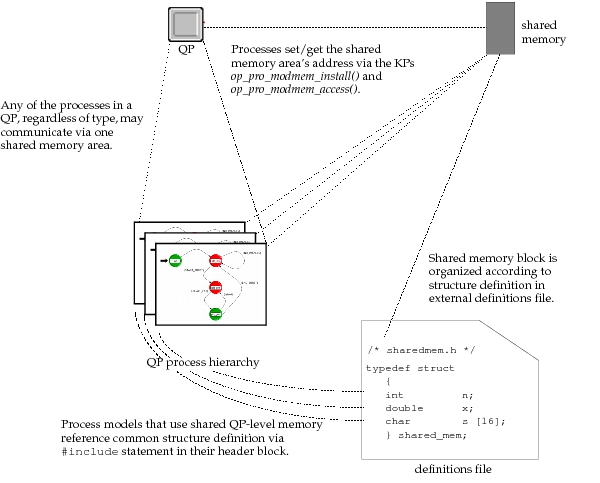
最初,仿真内核不为 QP 提供任何共享内存(内核过程 op_pro_modmem_access() 返回 NIL 值以指示这一情形);需要多少内存、以及它应当在何时可用,由 QP 内的进程自行决定。因此进程负责分配这块共享内存,之后可以通过调用 op_pro_modmem_install() 将其安装。内存分配通常通过调用 op_prg_mem_alloc() 完成。
已经安装的共享内存块可以被另一个内存块替换。支持安装的那个内核过程只是让新的内存地址取代原有的地址,而不会保护先前安装的数据免于丢失。因此,进行多次安装的进程体系结构要自行负责所需的内存释放。
在实践中,共享内存块通常只安装一次,并且这次安装由根进程在其第一次被调用时执行。这使得层次结构中的其他进程可以简单地假定该内存已经可用。QP 级共享内存安装完成之后,进程可以通过把数据写入公共内存空间来彼此传递信息。这通常通过为已安装的数据结构的各个成员赋值来实现。其他进程随后检查该数据结构的内容,并按需使用这些信息。使用模块内存的进程之间通信可以是主动方式的,也可以是被动方式的。主动通信包括修改共享内存内容,然后调用将要接收新信息的进程(进程之间的调用通过内核过程 op_pro_invoke() 执行)。被动通信只是修改共享内存内容,但依赖目标进程自主地检查共享内存,也许是在稍后的某个仿真时刻。
-
父进程到子进程的共享内存:在许多情况下,QP 进程层次结构内部必须进行的通信发生在进程与其父进程之间。这是因为子进程常常被创建用来处理父进程工作的某一部分,而结果必须回报给父进程。仿真内核为此类通信提供了专门支持,它允许在创建子进程时建立一个私有的共享内存区域。其他进程无法访问该内存,尽管它们可以保留自己的父到子内存。仿真内核为系统中的每一对父进程—子进程维护一个独立的共享内存块。
图 93:父进程到子进程的共享内存组织
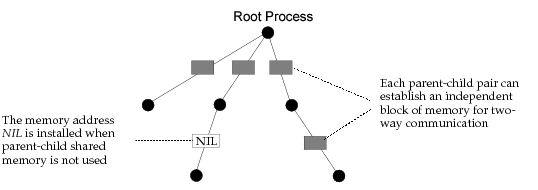
与所有进程间内存机制一样,父到子内存是可选的,可能只存在于某些父—子对之间。但与 QP 级共享内存不同,父到子内存对每一对父—子只能安装一次,且必须在使用内核过程 op_pro_create() 创建子进程时安装。该内存块不能被替换,尽管在它不再必要时可以被释放。一个进程可以通过调用内核过程 op_pro_parmem_access() 获取它与父进程共享的内存地址。然而,由于一个父进程可能有许多子进程,而且由于它必须提供父—子共享内存的地址,因此它负责保存这些地址的自有记录(例如把它们存储在状态变量中)。
通常,父到子共享内存通过调用内核过程 op_prg_mem_alloc() 来分配。共享内存的格式对仿真内核是透明的,内核只管理该内存块的地址。不过,与 QP 级共享内存的情形一样,父进程和子进程必须就内存格式达成一致,而这通常通过引用一个 C 或 C++ 数据结构的公共定义来分配和访问共享内存。在共享内存块建立之后(即在子进程创建时),父进程和子进程都可以通过修改和/或检查内存内容来彼此传递信息。如果适用,它们可以选择主动调用对方,通过调用内核过程 op_pro_invoke() 来通知共享内存区域发生了更改。
-
参数内存(Argument memory):进程之间的通信常常在一个进程通过内核过程 op_pro_invoke() 调用另一个进程、把控制转移给它的时候进行。为支持这种信息传递,op_pro_invoke() 接受一个通用内存地址作为参数,并使该地址对被关闭调用的进程可用。与另外两种内存机制一样,该内存地址指向一块内存,其格式由用户定义,两个进程必须设计成就其内容的组织方式达成一致。被调用的进程通过调用内核过程 op_pro_argmem_access() 获取该内存地址。随后它可以使用这块内存来获取影响其行为的参数,和/或修改该内存以便把状态信息返回给调用它的进程。 请注意,与另外两种内存机制不同,参数内存不是持久的。这意味着每次新调用一个进程时,都必须再次传递一个参数内存地址,即使它与先前同样这两个进程之间某次调用所提供的地址相同。
上述每种机制都是通过一个抽象数据对象来支持信息通信的,从这个意义上说,仿真内核确实了解所共享信息的结构或内容。内存地址作为通用指针被处理,进程逻辑必须对该指针进行类型转换或强制转换,使其成为指向适当数据结构的指针,正如各个通信进程所商定的那样。另请注意,每种内存机制都支持双向的信息通信,因为所有能够访问某块内存的进程都可以向其中插入和提取信息。有关进程共享内存机制的更多信息,参见“Process Package”第 1 页。
对动态进程的操作
动态进程之间的所有交互都通过 Process 包的内核过程(KP)执行。此外,Interrupt 包中的若干内核过程提供了间接影响进程运行的能力。这些过程的完整信息见“Discrete Event Simulation API”。这些内核过程所提供的一般能力以及相关的进程模型设计问题在本节中评述。
如前所述,每个 QP 最初只存在一个进程,即 QP 的“process model”属性中指定的根进程。当根进程(以及随后的其他进程)调用内核过程 op_pro_create() 时,可以派生出更多进程。当一个进程被创建时,它被隐含地纳入创建它的那个进程的进程层次结构之中。没有办法在不同于当前进程所在 QP 的另一个 QP 中创建进程。
要创建一个子进程,其进程模型应当至少声明在某个现有进程的规定之中。声明通过进程编辑器的“declare child process models”操作完成。虽然只要把所创建进程的模型声明在该 QP 任一进程所对应的模型中就已足够,但模块化设计的良好实践通常是在每个进程模型中声明它能够创建的所有进程的名称。这样,每个进程只负责声明它直接创建的进程,并且新的进程模型总可以被纳入一个进程层次结构,而不必担心它们自身是否会使用动态进程创建。
当一个进程被创建时,op_pro_create() 会返回一个称为*进程句柄(process handle)*的特殊数据项。用于声明进程句柄变量的数据类型是 Prohandle。进程句柄唯一地标识一个进程,不仅在其进程层次结构内唯一,而且在整个被建模系统内(即跨所有 QP)唯一。Process 包中大多数内核过程都需要进程句柄,因此使用动态进程的模型通常会用到它。一般地,进程使用声明为状态变量的进程句柄,来保留它在创建子进程时所获得的进程句柄的访问权。这使它能够稍后对其子进程执行基本操作,例如调用或销毁。进程句柄也可以通过若干其他内核过程获得,包括 op_pro_self()、op_pro_parent() 和 op_pro_root()。
还提供了另外两种进程标识形式,但使用影响进程的内核过程都不需要它们。进程 ID 是在进程创建时自动分配给进程的唯整数编号。进程 ID 永远不会改变,也不会在同一次仿真中重复出现。进程 ID 用于在 Modeler 自带的调试器所发出的信息性输出中、或在用户开发的报告语句中代表进程。进程的 ID 可以通过调用内核过程 op_pro_id() 获得。进程标签(process tag)是用户提供的字符串,可以在任何时候指派给一个进程。该字符串的内容对仿真内核是透明的,目前仅用于在 ODB 命令 promap 的输出中标识进程或报告关于它们的特殊信息。
某些动态进程被创建出来用于管理时限有限的活动,因此当这些活动完成时,它们的作用也就终止了。为了避免不活动进程的累积,所有动态进程(即除根进程以外的所有进程)都可以通过应用内核过程 op_pro_destroy() 从其 QP 的进程层次结构中移除。该内核过程可以应用于其他动态进程,也可以由一个动态进程在自己已经确定不再必要时应用于自身。进程自销毁通常应当作为一个进程的最后动作,因为使用 op_pro_destroy() 会剥夺进程的若干重要资源,包括其状态内存。
在许多情况下,父进程有必要知道它的某个子进程已被销毁。这使得父进程能够把它所掌握的子进程信息保持在最新状态,并释放与它同该子进程的关系相关的任何内存,包括在创建该子进程时建立的父到子共享内存。如果子进程执行自销毁,则可以通过修改父到子共享内存中的一个标志来通知父进程。父进程随后可以在该子进程从调用中返回时检查这个标志(如果父进程调用过它)。或者,子进程也可以基于共享内存区域内的一个信号量,通过类似的安排请求其父进程销毁它。
无论动态进程以何种方式被销毁,仿真内核总会为它提供执行一系列最后动作的机会。这是通过在释放该进程的状态内存之前执行进程模型中一个称为*终止块(termination block)*的特殊部分来实现的。通常,终止块包含一些语句,用于释放进程状态变量中所引用的动态分配的内存。在终止时可能执行的其他操作包括记录所收集统计量的最终值,以及通知可能受到影响的其他进程。
终止块的内容由 Proto-C 编译器放入一个专门创建的函数之中;因此,不应在终止块内定义任何函数,也不应在其中声明局部变量。不过,终止块中的语句确实可以访问状态变量和临时变量。此外,在调用某个进程的终止块之前,该进程会被置为活动状态,就如同它被调用了一样,因此可以调用 op_id_self() 或 op_stat_write() 这类依赖上下文的内核过程。
如果一个中断的发生没有直接调用负责处理它的进程,或者该中断要求某个 QP 中的若干进程采取行动,那么就需要进程之间的调用。这一机制由内核过程 op_pro_invoke() 支持,它使当前控制执行线程的一个进程能够让另一个进程暂时取得控制权。调用进程会被挂起,直到被调用进程通过阻塞释放控制权(即被调用进程必须进入一个非强制状态)。通过 op_pro_invoke() 被调用的进程反过来也可以使用这个内核过程去调用其他进程。因此,这一机制的运行方式类似于 C 或 C++ 这类面向栈的语言中的函数调用。但请注意,进程调用不支持递归;这意味着一个因调用 op_pro_invoke() 而被挂起的进程,在它重新取得执行线程的控制权并随后阻塞之前,自身不能再被调用。另一种理解方式是,op_pro_invoke() 只能应用于完全阻塞的进程。这一关于递归的限制只适用于进程实例,而不适用于进程模型。换句话说,同一进程模型的不同实例可以相互调用。
在一次调用期间,被调用进程可以访问该 QP 中的任何资源,例如为引发调用进程的中断而接收到的数据包或统计量值。但请注意,如果调用进程已经消耗或修改了这类资源(例如取走了一个在输入流中等待的数据包),它们就不再为被调用进程所可用。换句话说,应当把被调用进程看作是在代表调用进程执行一项任务。因此,它可以被视为调用进程执行线程的一个组成部分,就如同它的动作是被直接规定在调用进程的动作之中一样。
必须在父进程和调用进程之间作出区分,尽管在许多情况下二者可能是同一个进程。一个进程的父进程是创建它的那个进程,因此每个进程只能有一个父进程(根进程除外,它没有父进程)。另一方面,每个进程(包括根进程)都可以被同一进程层次结构中的任何其他进程调用,甚至不同的进程可以在同一个事件期间调用它。另请注意,进程之间的这两类关系支持不同的信息共享机制。一个进程和它的父进程通过父到子共享内存以持久方式共享内存,而调用则支持一种临时形式的共享内存,用于把参数(arguments)从调用进程传递给被调用进程。
中断引导
当某个 QP 发生中断时,仿真内核必须决定由哪个进程首先被调用来处理它。对于大多数中断类型,仿真内核并不了解该中断所需完成的任务,因此它的选择必须基于 QP 的进程自身所提供的信息。self 中断和 process 中断是这一规则的例外,因为它们隐含地指向特定的进程。对于其他中断类型,仿真内核因此提供了若干内核过程,使进程能够规定应如何进行选择。如果 QP 的进程没有使用其中任何一个内核过程,那么内核会作出默认决定,即调用根进程。
处理“中断必须由不同进程进行初始处理”这一类情况的最通用方式,是创建一个决定调用哪个进程的“分发器(dispatcher)”进程。通常,分发器进程就是根进程,因为根进程默认接收中断。根进程逻辑的一部分(甚至全部)用于分析传入中断的属性,以决定应当调用 QP 的哪个进程来实际处理该中断。这种通用方法的优点在于,可以基于中断的任意多个特性作出任意复杂的决定。例如,可能影响进程选择的属性包括数据包字段的值、中断的来源、到达的端口、到达的时刻,甚至是在响应先前中断期间累积起来的状态信息。
图 94:将根进程用作分发器
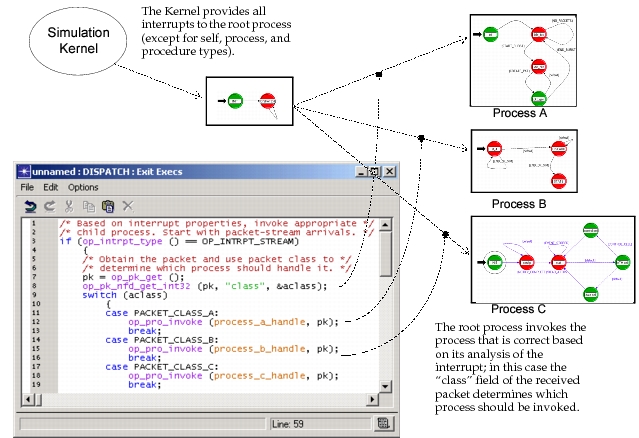
复杂的中断引导最好由上文所述的负责中断分发的进程来处理。不过,仿真内核的 Interrupt 包所提供的内核过程为某些简单情形提供了方便而高效、且足够用的支持。通过使用这些机制,任何进程都可以把自己或另一个进程登记为适当中断的直接接收者。
具体地说,提供了两个内核过程,用于请求仿真内核基于中断类型、或基于中断到达所在的输入,自动调用某个特定进程。基于中断类型的引导由内核过程 op_intrpt_type_register() 支持,除 self、process 和 procedure 之外的所有中断类型都受支持。对于 stream 中断和 statistic 中断,内核过程 op_intrpt_port_register() 在与该中断相关联的输入流或输入统计量方面提供了更强的针对性。当两种机制同时使用且都适用时,端口登记的优先级高于类型登记。自动中断引导在第 4 章“Modeling Framework”第 80 页中有详细说明。
进程本地资源
进程始终在某个 QP 的上下文中运行。QP 对象为它所包含的进程提供某些资源,这些资源隐含地构成每个进程环境的一部分。本节描述这些资源。
输入流与输出流
数据包流是存在于节点编辑器(Node Editor)中的对象,用于把各个模块连接在一起。数据包流支持模块之间无差错的包传输,也可以推迟数据包到达目的模块的时刻。数据包流在源模块和目的模块中连接到相应的构造,分别称为输出流和输入流。
QP 的输入流能够从外部源接收数据包。数据包在输入流内自动按先进先出顺序排队,并在进程请求时提供给该 QP 内的任何进程。输入流接受来自两个来源的数据包:数据包流对象,以及由 op_pk_deliver() 及相关内核过程提供的远程投递服务。一个 QP 可以有任意数量的、物理上连接到数据包流对象的输入流。此外,为支持数据包投递,输入流会按需动态分配,因为仿真内核事先并不知道将被投递或访问的输入流范围。
图 95:队列/处理器的输入流
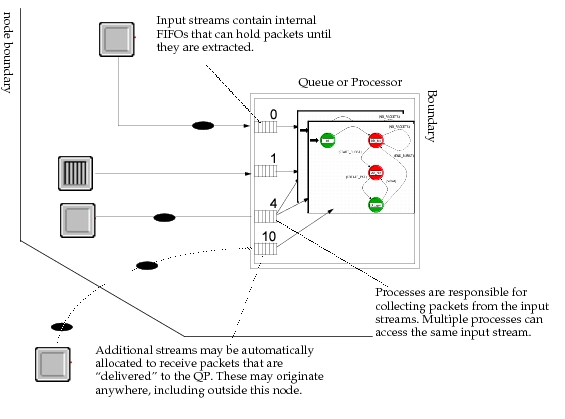
当数据包在某个输入流上被接收时,接收方 QP 中的一个进程通常会被以 stream 中断调用。该进程可以通过调用内核过程 op_intrpt_strm() 判定是哪个输入流收到了新数据包。输入流使用非负整数索引来引用。进程可以通过调用内核过程 op_pk_get() 并引用正确的输入流索引,获取仍留在其 QP 某个输入流中最早到达的数据包。内核过程 op_strm_pksize() 可用于确定输入流中尚剩余的数据包数量。
数据包流的另一侧连接到输出流构造。输出流通过内核过程 op_pk_send()、op_pk_send_delayed()、op_pk_send_forced() 和 op_pk_send_quiet() 支持数据包的通信。与输入流一样,输出流也由非负索引引用;不过,只有在节点域中实际物理连接到外出数据包流对象的输出流才是有效的。
输出流和输入流也可以在采用*流访问(stream accessing)*机制时被引用。一个 QP 可以使用流访问来向另一个 QP 发出信号,要求它在自己的某个输出流上转发一个数据包。假设模块 S 是某个数据包流的源,D 是其目的,则操作序列通常如下:
- D 调用内核过程 op_strm_access(),请求 S 通过连接二者的那个流向它发送一个数据包。在调用该内核过程时,D 指定它希望用来接收数据包的输入流索引。
- D 一调用 op_strm_access(),就为 S 产生一个强制中断。这意味着 D 的执行被暂时挂起,以便 S 作出响应(有关强制中断的更多信息,参见 Modeling Framework 一节)。该中断的类型是 access 中断。S 调用 op_intrpt_strm() 判定数据包是在哪个输出流上被请求的。随后 S 通过在该输出流上发送一个数据包(如果它愿意这样做)来响应这个 access 中断。为发送该数据包,S 必须使用 op_pk_send_quiet(),因为它必须避免为处于挂起状态的 D 产生中断。请注意,如果需要,S 也可以采取其他动作。S 在一个 unforced 状态中阻塞。
- 当 S 阻塞时,D 立即重新获得控制,并在它调用 op_strm_access() 的位置之后的那条语句处立即恢复执行。D 检查自己的输入流,以确定是否有一个或多个数据包到达,通常使用内核过程 op_strm_pksize()。如果存在任何数据包,它可以使用内核过程 op_pk_get() 从自己的输入流中取出它们。
输入统计量与本地输出统计量
输入统计量是 QP 内部的一种构造,它们接受由同一节点中其他模块(不一定是 QP)发送的数值。输入统计量通常用于监视由其他模块产生的性能指标或状态信号。这些数值由连接源模块和目的模块的统计量线(statistic wire)对象传递。目的模块的输入统计量只能保留它接收到的最后一个数值(即不提供数值的缓冲)。该最新数值始终可以通过调用内核过程 op_stat_local_read() 供该 QP 内的任何进程使用。
每个 QP 恰好有 100 个输入统计量,其中每一个都可以连接任意数量的统计量线。这些输入统计量使用 0 到 99 范围内的整数索引引用。这些索引对应于节点域中统计量线对象的“dest stat”属性。当多条统计量线连接到同一个输入统计量时,在任何给定时刻存储在输入统计量中的,是最近被更新的那条统计量的最新数值(请注意,统计量可以被更新而其取值未必发生变化)。
与统计量线相关联的统计量的变化,总是为目的模块产生 statistic 事件。随后每个事件可能导致为接收方 QP 中的某个进程产生一个 statistic 中断,具体取决于统计量线所施加的中断产生准则(有关统计量线工作的更多信息,参见“节点域”)。进程在收到 statistic 中断后,可以通过调用内核过程 op_intrpt_stat() 判定 QP 的哪个输入统计量收到了新数值。
本地输出统计量与输入统计量构成连接 QP 的统计量线的两端。使用“Local”(本地)这个限定词,是为了把这类输出统计量与可以由跨系统模型的多个 QP 共享的全局统计量区分开。本地输出统计量提供了报告每个 QP 私有的用户定义统计量的能力。
本地统计量可以被统计量探针采集,从而为仿真的输出文件作出贡献;也可以被统计量动画探针采集,以便在仿真过程中生成该统计量随时间变化的动画视图。本地统计量还可以通过统计量线连接到同一节点中其他 QP 模块的输入统计量,使数值在更新时被动态地传送给目的模块。进程可以通过调用内核过程 op_stat_write() 或 op_stat_write_t() 更新本地输出统计量。每个本地输出统计量可以馈送任意组合的多条统计量线和多个探针。当统计量的取值被更新时,各个目的端分别收到正确的通知。
每个 QP 可以维护任意数量的本地输出统计量。如果多个进程共存于该 QP 内,则这些输出统计量由所有这些进程共享。换句话说,需要时其中任何进程都可以更新任何输出统计量。进程必须声明它们打算使用的本地输出统计量;进程编辑器为此提供了“edit local statistics”操作。该操作在 Editors Reference 手册中有完整说明。每个本地输出统计量可以是*有维(dimensioned)*的或无维的。无维统计量就是一个单独的统计量,这也是最常见的情形。有维统计量实际上是一个统计量数组,包含任意预先确定数量的单个统计量。各个单个统计量通过其索引加以区分,并可以被独立地更新和使用。有维统计量提供了一种更方便的方式来处理大量相似的统计量,通常用于进程管理可伸缩数量实体(例如连接或邻居)的场合。在使用子进程的许多场合中,每个子进程负责更新本地输出统计量数组中的一个输出统计量。
为了获得访问权以更新某个统计量,进程必须先获得与之对应的统计量句柄。内核过程 op_stat_reg() 使进程能够获得该句柄,随后它可以保留该句柄(通常作为状态变量)以供后续使用。
全局统计量
本地统计量非常适合报告某个 QP 在系统模型中某个特定位置上的私有活动。然而在许多情况下,建模者关心的是获取关于整个系统的定量信息。例如,在一个网络模型中,我们可能希望测量在所有应用之间传输的所有数据包所经历的端到端时延的平均值,而不考虑其具体的源或目的。另一个常见的关注统计量是网络吞吐量,它衡量网络在所选时间区间内交付的数据总量。通常,全局统计量只是系统模型中许多组件的本地输出统计量的平均值。在同一次仿真中同时收集这两类统计量是很常见的。
全局统计量可用于向两类统计量采集探针馈送数值:全局统计量探针和统计量动画探针。全局统计量探针把统计量数值传送到仿真的输出文件,使其能够在仿真后在结果浏览器(Results Browser)中分析。统计量动画探针允许在仿真期间动态查看该统计量。
Modeler 为本地统计量和全局统计量提供类似但分开的支持。与本地输出统计量一样,每个进程模型应当声明它在仿真期间打算更新的全局统计量。这通过进程编辑器的 edit global statistics 操作完成,该操作在 Editors Reference 手册中有完整说明。全局统计量通过统计量句柄访问,该句柄经由内核过程 op_stat_reg() 获得。为获得该句柄,需要指定统计量的名称和组(group);如果系统模型中其他位置的各个进程在调用 op_stat_reg() 时指定了相同的名称和组,那么它们将获得同一个统计量句柄,从而提供一种基于统计量名称的“rendez-vous(会合)”机制。随后这些各个进程可以在调用 op_stat_write() 时使用该句柄;所有进程提供的数值会被合并到仿真输出文件中的同一个数值序列中,或合并到该统计量的动画中。有关处理全局统计量的更多信息,参见“Discrete Event Simulation API”。
子队列
队列模块可以在节点域中被配置为包含任意数量的子队列,使数据包能够以组织化的方式存储。队列模块内的所有进程对子队列具有平等的访问权,并可以按需插入和提取数据包,以实现某种特定的排队策略。Q 包和 Subq 包的内核过程支持操作子队列的进程。有关这些内核过程的详细信息,参见“Discrete Event Simulation API”。另请参见节点域定义一节,其中详细说明了队列和子队列的结构。
属性
与所有对象一样,QP 也有一组属性,规定其某些基本特性。QP 内的所有进程都可以通过分别调用内核过程 op_ima_obj_attr_set() 和 op_ima_obj_attr_get() 来修改和获取这些属性的取值。
内置属性是预定义的,对每个 QP 都类似,尽管它们的取值是按每个 QP 独立指派的。模型属性可以由建模者声明,以支持对应用特定的对象特性进行建模。进程编辑器提供了“edit model attributes”操作用于此目的。有关该操作的更多信息,参见 Editors Reference 手册。
模型属性由 QP 从其指派的进程模型继承而来。这一组属性由根进程的进程模型属性以及其子进程模型的属性共同构成。为避免各个进程之间的属性命名冲突,属性名称以定义它们的进程模型名称作为前缀(根进程的情形除外)。
模型属性的作用域对每个 QP 是局部的。也就是说,对于使用某个进程模型的每个 QP,都会为该 QP 创建该进程模型属性的私有副本,并追加到它的属性列表中。它们与 QP 的内置属性一起出现,并可以按完全相同的方式处理。在一个 QP 中更改该属性,不会影响任何其他 QP 中同一属性的取值。
Modeler 还为进程模型提供一种全局作用域的属性机制。这些属性称为仿真属性(simulation attribute),由需要它们的每个进程模型声明。与进程模型属性不同,仿真属性是只读的。它们的目的是在系统层而非系统构建块层提供一种参数化机制。换句话说,如果某个进程模型的设计者希望创建一个由系统模型中许多实体共享的参数,它可以声明一个相应的仿真属性。如果多个进程模型声明了同一个仿真属性(即使用完全相同的名称),Modeler 会检测到这一点,并只创建一个属性,该属性被所有相关进程模型隐含共享。仿真属性的取值可以在仿真运行时指定,以完成系统模型的规定。每次新仿真可以指定不同的取值,从而提供一种让系统模型自动遍历一系列实验的机制。
仿真属性的声明通过“edit simulation attributes”操作完成,该操作在 Editors Reference 中有详细说明。当进程想要获取某个仿真属性的取值时,它们必须调用内核过程 op_ima_sim_attr_get() 并使用正确的已声明名称来引用该属性。如果该仿真属性的取值尚未作为仿真环境属性的一部分指定,那么 op_ima_sim_attr_get() 会使仿真内核向用户提示输入一个赋值。由于仿真属性的取值在仿真开始后不会改变,进程通常只获取这些取值一次,如果稍后还需要使用它们,就把它们存储在状态变量中。参见“Discrete Event Simulation API”了解更多信息。
由于仿真属性(以及属性一般地)本质上是系统模型和仿真的输入,因此它们常常值得作为仿真输出文件的一部分记录下来。这使得仿真的输入和输出(即记录的统计量)可以被一起查看,并分析它们之间的依赖关系。Modeler 为此目的提供一种专门的探针,称为属性探针(attribute probe)。属性探针把属性取值记录为标量统计量。有关属性探针的更多信息,参见“仿真设计”。
外部系统接口资源
在队列和处理器中,进程模型扮演 QP 行为模型的角色。然而对于 esys 模块,进程模型还可以承担一个额外角色。每个 esys 模块都有一个 ESD 模型属性,其中可以填入一个外部系统定义的模型名称。对于 esys 模块,进程模型处理去往外部系统和来自外部系统的所有数据。进程模型为外部系统格式化数据,并负责在协同仿真期间处理它从外部系统接收到的数据。
由于 esys 模块具备队列和处理器的全部功能,如果你将来有可能希望在节点中纳入某个外部系统,你就可以在节点模型中使用 esys 模块。当 esys 模块的“esd model”属性取值为 NONE 时,它的行为与队列完全相同。之后,如果你希望添加一个外部系统,可以使用一个动态进程来处理与外部仿真器之间必要的数据交换。因此,esys 模块可以使用进程来既建模行为又与外部系统交互。
本节其余部分说明如何使用进程模型与外部系统交互。此类进程模型执行两种功能:
- 从 esys 接口读取数值,并向 esys 接口写入数值
- 在 esys 接口层所需的格式(例如一个位向量)与模型所使用的格式(例如一个数据包)之间转换数值
虽然 esys 模块的进程模型始终负责把数据放到 esys 接口上并从中取回数值,但进程模型在操纵数据方面所扮演的角色可以有所不同。进程模型可以把它接收到的数值原样地直接放到 esys 接口上,也可以在把数据发送到外部系统之前对其进行转换。进程模型参与数据转换的程度由建模者决定。
“External System Package”描述了一族内核过程,使你能够向 esys 接口写入数值并从中取回数值。除非某个 esys 接口是向量接口(此时它可以包含多个数值),否则它一次只能包含一个数值。内核过程 op_esys_interface_value_get() 和 op_esys_interface_value_set() 使你能够从 esys 接口读取数据和向它写入数据。其他内核过程使你能够处理数据组或向量接口。有关处理数据和 esys 接口的更多细节,可在“外部系统领域”中找到。
在大多数情况下,esys 接口所交换的数据对 Modeler 并不直接具有意义。例如,由于外部系统可能对数据包几乎没有用处,因此数据包必须首先被转换为另一个系统能够理解的格式,然后才能放到 esys 接口上。同样,来自外部系统的数据通常也需要被转换,才能对 Modeler 有意义。esys 模块的进程模型负责处理这些转换。内核过程 op_vvec_from_value() 和 op_vvec_to_value() 使普通数值能够转换为其位表示形式以及转换回来。各种其他值向量内核过程使你能够操纵和转换值向量,你可以把它们用于外部系统或用于其他目的。参见“Value Vector Package”。
在准备放到 esys 接口上的数值时,一个主要关注点是所涉 esys 接口的数据类型。由于每个 esys 接口只能保存一种数据类型的数值,因此准备要交换的数据时的关键问题,是如何把你想传达的信息从 Modeler 转换为正确数据类型的信息。当从外部系统接收数据时,从输出 esys 接口来的所有数据也只有一种类型。因此,进程模型必须把 Modeler 数据结构(例如 ICI、标量和数据包)以及用户数据结构转换为一种数据类型的数值,然后才能把它们发送到 esys 接口。进程模型还必须做相反的工作,即在从外部系统接收数据时,把一种数据类型的数值转换回 Modeler 和用户数据结构。有关这类转换的策略在“外部系统领域”中说明。
进程模型组件
进程模型是对进程动态行为的规定。为了完整,进程模型必须描述进程在所有可能情形下将要实施的行动。在许多情况下,在离散事件仿真中执行的进程表示某个现实世界的等价协议或算法;对此类协议或算法的正式规定是一种更高层次的规定,它申明了为了以标准化方式使用而必须被某个进程实现所满足的要求。为了把这种规定与在 Modeler 中开发的模型规定区分开,正式规定将称为标准(standard)。换句话说,标准描述适用于现实世界进程的要求,因此也适用于这些进程的模型。一些标准的例子是 IEEE 802 局域网协议标准,或 TCP/IP 协议族的 RFC 文档。对 Bellman-Ford 路由之类算法的学术描述,按此定义也属于标准。实际上,任何一组适用于某进程的行动及其交互的要求,都可以称为该进程实现的标准。
进程模型是为表示现实中已存在或计划中的系统而开发的,因此在某个层次上可以被视为与其现实世界对应物相同的标准的实现、或部分实现。严格地说,表示已存在且已知的现实世界对应物的进程,是那些实现的模型,而不是该标准的实现。因此,一个对现有现实世界进程的良好模型,应当复现该现实世界进程相对于它所实现的标准所存在的缺陷。这样它就能够预测由该缺陷导致的行为。
在某些情况下,进程模型是为表示现实中可能出现的假想进程而开发的。例如,建模者可能感兴趣的是预测某个所提议协议的性能,而该协议可能尚不存在现实世界的实现。在这些情况下,进程模型本身可以被视为其所源自之标准的实现。类似地,进程模型可以被开发出来,以提供某个标准的通用实现,用作基础库组件。这样的进程也将被视为对标准的直接实现,因为它并非仿照任何现有的现实世界实现而来。Modeler 提供的多数与标准有关的示例模型,例如 X.25、以太网、ATM、TCP/IP 等,都属于这一类。
无论一个进程模型是力求表示一个现实世界的实现还是一个标准,它被要求实施的行动以及这些行动所依据的时序都可能相当复杂,并且可能因应用不同而差异显著。因此,如果要用一种表示约定(或语言)来定义所有此类进程模型,该语言必须极其通用。Modeler 支持一种用于开发进程模型的语言。这种语言称为 Proto-C,由集成在 Modeler 应用中的进程编辑器提供支持。Proto-C 为描述离散事件系统的行为提供了一种强大而高效的方法;它提供以下主要特性:
- 基于状态转移图(STD)——也称为有限状态机(FSM)。这是描述维护状态信息(即随时间累积的信息)的离散事件系统的主流描述方法。它被广泛用于规定和开发种类繁多的软件与硬件系统,因为它简单、便于直观的图形化表示,并且能有效分解复杂度。
- 图形与文本相结合的表示——Proto-C 进程模型以图形格式描绘状态转移,以支持对顶层控制流的可视化。然而,由于图形化表示通常不能高效或直观地描述细节动作或决策,Proto-C 支持以文本方式规定进程的这些方面。文本规定发生在图的状态内和转移上,并基于一个强大的、与仿真和分布式系统相关的过程库,该库在“Discrete Event Simulation API”中有说明。此外,Proto-C 保留了 C 和 C++ 语言的完整通用计算能力,以保证对所有离散事件应用都有足够的灵活性。
- 能够表示通用的状态信息——进程的状态信息是由进程产生或提供给进程、并且进程决定予以保留的那组数据。传统状态转移图通过指明在任一给定时刻占据了有限状态集合中的哪一个状态,来表示系统的完整状态;这对状态复杂的系统是不切实际的,对状态动态扩展的系统也是不够的。因此 Proto-C 只使用状态占据表示来表达系统的高层模式,并提供一种更强大的机制来描述通用状态信息。模型可以声明任意数量的状态信息作为变量,其数据类型由 Modeler、C 和 C++ 语言或自定义定义提供。状态变量可以赋予通用名称,并在整个进程模型中符号化引用。此外,变量可以被指派给动态分配的内存,以存储随时间增长的状态信息。
- 动态进程创建——可以动态创建进程,以划分中断处理,或在新任务出现时提供额外的独立上下文。
- 高效执行——Proto-C 图及其中的逻辑被翻译成 C 和 C++ 语言代码,开销极小,从而能够极其高效地执行。特别是,状态信息的访问以及控制流语句(例如带条件子句的
if语句,以及遍历多个操作的for循环)都采用直接的方式实现,以避免任何性能损失。
状态转移图
Proto-C 模型由两种基本组件类型构成:状态和转移,因此得名状态转移图(STD)。状态通常用于表示进程可以进入的顶层模式。转移规定进程可能发生的状态变化。STD 在进程编辑器中以图形方式绘制。
Proto-C 进程模型还有其他重要方面并未以图形方式表示。这些方面包括与每个状态相关联的动作、变量和属性声明,以及表达式和函数的通用定义。本节提供有关这些特性的能力与应用详细信息。
强制状态与非强制状态
从一般意义上说,状态一词指的是进程在其存在的这段时间内可能累积起来的信息。进程的状态可能并不包括该进程所接触过的全部信息,而只包括它选择保留的那部分。状态信息可以随着新事件发生和数据可用而被持续更新。就状态转移图(STD)而言,状态一词指的是对应于进程可能处于的某种主要模式或情形的一种对象。状态彼此互斥且互补,意味着进程在任何时刻恰好处于一个状态:任何时刻不可能同时处于多个状态。进程可以因它接收到的中断而在状态之间移动。从某个状态出发的转移指出接下来可以占据哪些状态,以及每项变化所要求的条件。
每个 Proto-C 状态都可以关联动作的规定。在 Proto-C 术语中,动作称为执行体(executives)。一个状态的执行体分为两个部分,称为enter 执行体和exit 执行体。顾名思义,状态的 enter 执行体在进程进入该状态时执行,其 exit 执行体在进程离开该状态、沿某条出向转移前进时执行。
Proto-C 定义两种类型的状态,称为 forced(强制)和 unforced(非强制),二者在执行时序上不同。在 Proto-C 图中,forced 状态以绿色圆圈表示,unforced 状态以红色圆圈绘制。在单色显示和硬拷贝上,forced 状态为深色,unforced 状态为浅色。
图 96:强制状态与非强制状态的图形表示
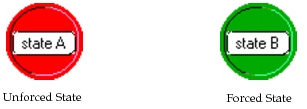
unforced 状态允许在 enter 执行体与 exit 执行体之间出现停顿,因此能够建模系统真正的状态。进程完成一个 unforced 状态的 enter 执行体之后,它会阻塞并把执行控制交还给先前调用它的上下文。该上下文可能是通过调用内核过程 op_pro_invoke() 调用本进程的另一个进程;或者,如果该进程是由仿真内核调用的,那么阻塞表示当前事件的结束,仿真内核可以选择一个新事件开始执行。此时,该进程保持挂起状态,直到一次新的调用使它推进到其当前状态的 exit 执行体。下图描绘了当中断使进程前进时,执行流经 STD 中 unforced 状态的过程。
图 97:经由非强制状态的执行流程
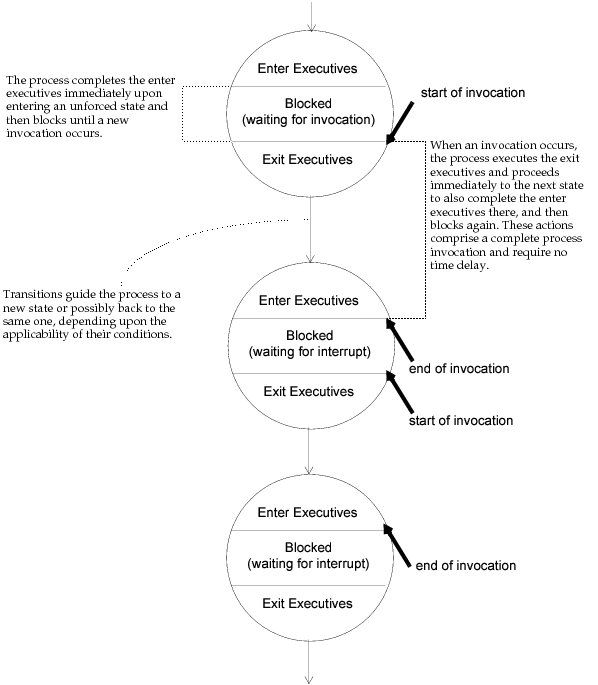
该图清楚地显示了进程一次调用的起点和终点。在所有情况下(第一次调用除外),当一个进程被调用时,它正处于准备开始执行其当前状态 exit 执行体的位置。随后它一直推进,直到完成某个 unforced 状态的 enter 执行体并再次阻塞。因此,如果只涉及 unforced 状态,则该周期如下:
- 当前状态的 exit 执行体
- 转移到下一个状态
- 下一个状态的 enter 执行体
forced 状态之所以如此命名,是因为它们不允许进程等待。因此它们不能用于表示持续任何时长的系统模式。换句话说,forced 状态的 exit 执行体在 enter 执行体完成后由进程立即执行。因此 forced 状态的 exit 执行体通常留空,因为它们等同于放在 enter 执行体末尾的相同语句。由于 forced 状态不能表示实际的系统状态,它们的使用一般不如 unforced 状态频繁。然而在某些情况下它们很有用,可以把若干 unforced 状态共有的动作或控制流决策在图形上分离出来;以这种方式在图形上分离出决策或动作的规定,有时可以提供更好的规定模块化,以及一张在视觉上信息更丰富的状态转移图。
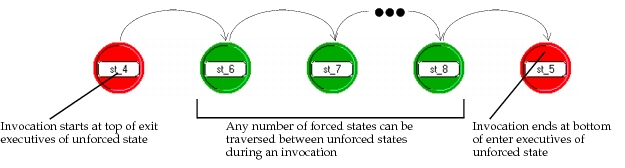
引入 forced 状态只对上图中所描绘的执行流程造成很小的调整。unforced 状态仍然代表一次调用的起点和终点;不过在它们之间可以经过任意数量的 forced 状态。这在下图中得到说明。
图 98:经由非强制状态与强制状态组合的执行流程
初始状态
每个进程模型中必须指定一个特殊状态,称为初始状态。任何已存在的状态都可以随时通过进程编辑器的“set initial state”操作被指派这一角色。在图形上,初始状态由位于其紧邻左侧的一个大箭头标识,如图 99 所示。
图 99:初始状态的图形表示
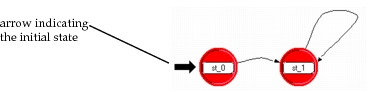
初始状态是进程第一次被调用时执行开始的位置。它对任何后续调用都没有特殊意义,并且可以正常地扮演一个普通状态的角色。然而,由于该状态通常包含执行初始化的执行体语句,而这些初始化只应当发生一次,因此多数模型不包含指回它的转移。
在收到第一个中断时,进入初始状态是从 enter 执行体的开头开始的。某些模型把这个状态专门用于初始化动作,并预期将专门提供一个“begin simulation 中断”,以便在零时刻完成这些动作。是否预期这种中断的问题,以及初始状态应当是 forced 还是 unforced 的相关问题,必须谨慎处理,以免错误处理第一个中断。本节使用几种不同的方法。在描述这些方法时,除 begin simulation 中断以外的中断被称为主流中断(mainstream interrupts)。
-
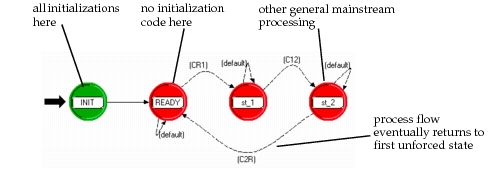
初始状态是 forced 的,并且预期有一个 begin simulation 中断——由于初始状态是 forced 的,进程在初始化完成后必然立即前进到第二个状态。这第二个状态的 enter 执行体不得执行与处理主流中断相关的动作,因为这些动作将被(错误地)在初始化时执行。通常,第二个状态是一个 unforced 状态,充当进程处理后续主流中断的“就绪”位置。当初始化之后进入的第一个 unforced 状态在后续主流处理中也会被重新进入时,这种方法是有意义的。若不是如此,那么初始状态和第二个状态就可以简单地合并为一个 unforced 初始状态。
图 100:初始化策略 1:强制初始状态 / begin simulation 中断
-
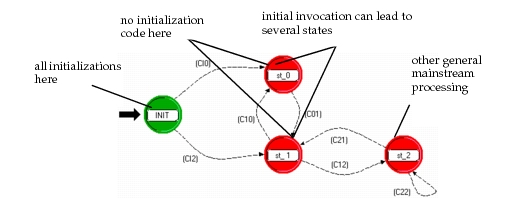
初始状态是 forced 的,并且不预期有 begin simulation 中断——与上一种情形一样,进程在初始状态完成后会立即前进到第二个状态;然而,由于第一个中断是主流中断,通过执行额外动作来处理该中断是正确的。因此,从初始状态出发的条件转移可以把进程引导到若干可能的第二个状态,中断的处理可以在其中进行。请注意这一方案的局限在于:初始化直到第一个主流中断发生时才执行,而这可能远晚于零时刻。
图 101:初始化策略 2:强制初始状态 / 无 begin simulation 中断
-
初始状态是 unforced 的,并且预期有一个 begin simulation 中断——在这种配置下,放在 enter 执行体中的初始化语句将在零时刻完成,之后进程将阻塞直到第一个主流中断到达。因此,初始状态的 exit 执行体应当针对主流中断的处理作适当规定;它们可以简单地留空,此时中断处理代码必须放在后继状态的 enter 执行体中,或放在转移的执行体中。与前一种方法一样,当第一个主流中断可能把进程引导到若干不同状态时,这种组织是有意义的;但请注意,它在零时刻完成初始化,而不是等待某个主流中断。另请注意,如果初始状态将在后续主流中断的处理期间被重新进入,那么这种方法通常是不正确的,因为 enter 执行体中的初始化语句会被反复执行。
图 102:初始化策略 3:非强制初始状态 / begin simulation 中断
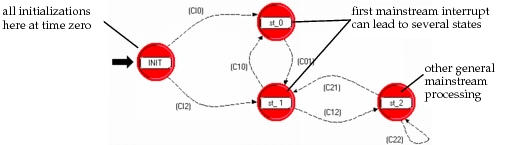
-
初始状态是 unforced 的,并且不预期有 begin simulation 中断——这是一种不寻常的方法,因为它要求一个主流中断来执行初始化,然而进程却不前进到其他状态就阻塞了。因此,与第一个主流中断相关的任何处理都必须嵌入初始状态的 enter 执行体中;如果这种处理是通用的、并且在模型的其他地方也出现(即为了对同类中断做稳态处理),那么它可能需要被重复地规定出来。
请注意,begin simulation 中断在节点域内是通过为处理器和队列模块的“begsim intrpt”属性指派正确的取值来控制的。而且,begin simulation 中断不能为动态创建的进程启用(即“begsim intrpt”属性只适用于 QP 的根进程);不过,通过在通过 op_pro_create() 创建之后立即由父进程用 op_pro_invoke() 执行一次调用,可以为这类进程模拟其效果。因此,上述组织进程初始化各阶段的方法同样适用于动态进程。
初始化各阶段配置不当会导致进程出现严重的逻辑错误。特别是,如果一个预期收到 begin simulation 中断(或等效调用)的进程没有收到它(例如因为“begsim intrpt”属性未启用),它可能把第一个主流中断误解为它所预期的那个中断。通常在这种情形下,初始化仍然会被正确执行,因为进程只是假定它已经收到了执行初始化的预期指示。然而,那个主流中断很可能被该进程忽略,从而导致关键信息丢失,和/或遗漏进程本应采取的某些关键早期动作。
这一问题有一个特别的例子:发生的第一个主流中断是一个 stream 中断,指示某个数据包到达 QP 的一个输入流。如果进程假定发生的却是 begin simulation 中断,那么到达的数据包很可能被忽略,并将留存在输入流中。随后被正确解释的 stream 中断会使进程试图从输入流获取到达的数据包;然而,由于输入流按先进先出顺序对数据包排队,被忽略的那个数据包反而会被取出。因此,表现出这一错误的模型可以通过数据包处理上出现的“错位”来识别。自相矛盾的是,这种错位的一个后果是,接收数据包不频繁的进程反而以更大的时延转发它们,因为每个数据包都必须等待后一个数据包到达才能触发它的处理;对于测量数据包通过系统的累积时延的某些仿真研究而言,这种行为是反直觉的,因为一般而言,到达频率较低对应于负载较轻的系统,而负载较轻又意味着通过系统的时延较低。
转移
转移描述进程从一个状态到另一个状态的可能移动,以及这种变化可能发生的条件。一个转移的规定由四个成分构成:源状态、目的状态、条件表达式和执行体表达式。该规定可以如下解读:当处于源状态时,如果条件为真,则实施执行体表达式并把控制转移到目的状态。
在进程编辑器中,转移以图形方式规定。每个状态可以有任意数量的出向和入向转移,绘制为有向弧线,箭头指向目的状态。条件表达式和执行体表达式出现在弧线旁边的一个合并标签中。该工具总是把条件表达式放在括号内,并在执行体表达式之前加一个斜杠(‘/’)以分隔这两个成分。具有非空条件表达式的转移绘制为虚线弧;没有条件的转移绘制为实线弧,如下图所示。
图 103:转移的表示方法
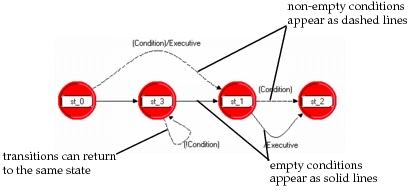
转移的条件作为一个布尔表达式求值,以决定进程是否应当进入该转移的目的状态。进程在源状态的 exit 执行体语句完成后才对其出向转移求值。对于 forced 状态,enter 和 exit 执行体紧接着依次执行,因此两个执行体块和转移求值可以被视为一个逻辑上连续的动作序列(尽管 forced 状态的 exit 执行体通常为空)。对于 unforced 状态,enter 与 exit 执行体之间会出现停顿,因此只有后者可以与转移归为一组。
转移条件表达式可以是各种判据的复杂组合,涉及进程的状态变量、当前中断的属性,以及存储在共享内存或全局内存中的其他信息。条件也可以基于任意复杂度的计算,方法是调用一个返回 boolean 值的用户定义过程(通常,此类过程会放在进程模型的 function 块中)。另外,支持条件表达式的计算可以放在转移源状态 exit 执行体的末尾,因为这些语句在条件求值之前立即执行。
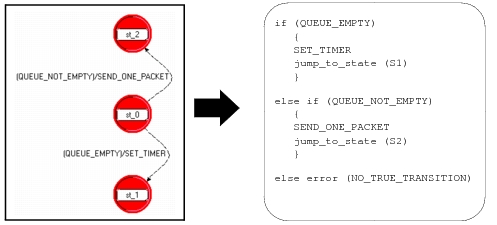
在进程可以沿任何转移进入目的状态之前,从某个状态出发的所有转移都会被求值。这使得两类错误能够被检测到,并确保行为与转移条件求值的顺序无关。如果没有任何条件具有 TRUE 取值(作为 C 或 C++ 语言表达式即为非零取值),那么进程会产生一条说明此情况的错误消息,因为它不可能继续执行。类似地,如果有多于一个转移条件具有 TRUE 取值,也会发出错误消息。这两种错误都被认为严重到足以使仿真停止。因此重要的是,从某个状态出发的各个转移在它们被求值的时刻应当集体地彼此互斥(不能有两个同时为真),并且互补(至少有一个必然为真)。下面 STD 片段与一段伪代码片段之间的等价关系,展示了用于求值多条出向转移的逻辑。
图 104:多个转移配置的伪代码等价形式
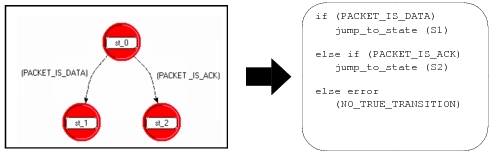
提供了一种称为 default 的特殊条件,用来表示与某个状态各已定义转移的条件相关联的补集。每个状态应当至多有一条出向 default 转移。当互补条件比较复杂时,这是一种很有用的表示机制,并且它确保进程不会因为在所关注的状态处缺少一个为真的转移而遇到错误。如下面的伪代码例子所示,default 转移只有在所有其他转移条件都为假时才成功:
图 105:带 default 的多个转移配置的伪代码等价形式
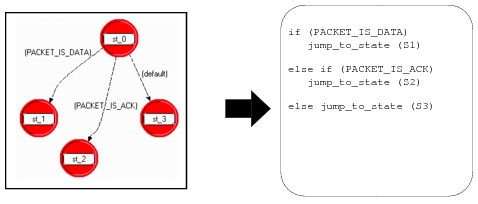
关于条件表达式的最后一点说明:配置了空条件属性的转移,等同于条件总是求值为真的转移。这些转移称为无条件转移(unconditional transitions)。由前面的内容可以推出,如果一个状态有一条无条件转移从它出发,那么它就不能再支持其他出向转移。
每个转移都包含一个属性,用于支持规定一条执行体语句。转移的执行体在进程决定沿该转移前进的时刻被执行。换句话说,在所有出向转移都被求值之后,进程从中选择一个,执行它的执行体语句(如果有的话),并前进到其目的状态的 enter 执行体。下面以下面一对简单转移的伪代码形式描述了这一序列。
转移执行体对于把某个动作与某个状态联系起来很有用,但仅限于该状态因某个特定原因被进入或离开的时候。实际上,如果把该动作纳入状态的 enter 或 exit 执行体,那么无论该状态因何种原因被进入或离开,该动作都会被执行,这在某些情况下可能是不希望的。
图 106:带执行体的转移的伪代码等价形式
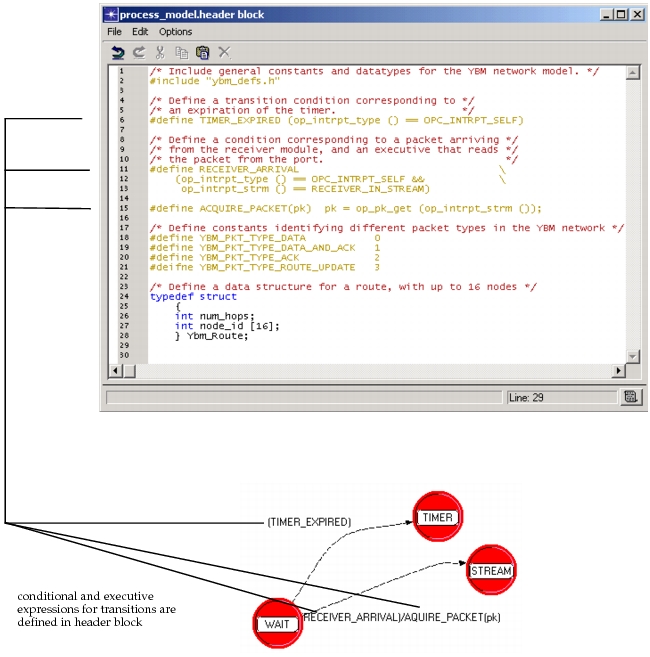
使用宏定义复杂或重复出现的表达式
在上面的例子中,条件和执行体表达式只由“类似英语”的文本构成,乍看之下并不像 C 语言的程序化表达式。这些例子中所使用的技术(也是多数进程模型通常采用的做法),是定义一些宏,其名称代表底层的表达式。Proto-C 只是把 C 语言的宏定义能力“透传”出来以支持这种做法。
Proto-C 模型使用的宏几乎全部定义在其 header 块中。header 块是一块自由格式的 C 或 C++ 语言代码区域,类似于一个 C 或 C++ 文件的顶部部分。宏通常用于表示常量、转移条件、转移执行体,或经常执行的操作。
直接在 header 块内定义的宏以 #define 这个 C 和 C++ 预处理指令开头。宏也可以定义在外部定义文件(在 C 和 C++ 中以“.h”为后缀的文件)中,并通过 header 块使用 #include 预处理指令包含进来。外部文件包含的方法在多个进程模型必须共享一组一致的定义时很有用;这样就不必在每个进程的 header 块中重复录入和维护相同的定义。下面的 header 块片段提供了一个典型 Proto-C 宏定义的例子。
图 107:进程模型 Header 块中的宏定义
变量
Proto-C 进程可以访问多种形式的内存来存储信息。每种内存形式都有不同的特性,使其适用于特定的用途。其中某些内存形式允许把信息作为普通名称直接声明和操纵;这些存储形式称为变量。Proto-C 进程可以使用三种不同的变量类别,称为状态变量、临时变量和全局变量。下表列出这些变量类型,以及可以访问它们的代码部分。
表 44:状态变量、临时变量与全局变量的可见性
| 变量类型 | 可见性 | ||
|---|---|---|---|
| 状态执行体 | function 块中的函数 | 外部文件(.ex.c 文件)中的函数 | |
| temporary(临时) | X | ||
| state(状态) | X | X | |
| global(全局,如规定在外部 header 文件或 Header 块中) | X | X | X (只要使用了 “extern”) |
变量的组成成分
所有变量,无论其类别如何,都有一个名称、一个数据类型和一个取值。变量的名称和数据类型在进程的整个生命周期内保持不变;取值是唯一可以变化的成分。
- 名称——与属性不同,变量可以在不使用任何内核过程的情况下被访问。相反,对变量名称的普通引用即隐含地表示对其值的引用。变量名称通过一种称为*声明(declaration)*的机制定义;三种变量类别各自使用略有不同的声明机制,以便向进程编译器表明适用哪种类别。所选定的名称可以是通用的字母数字字符序列,并遵守以下规则:
表 45:变量命名规则
-
名称必须仅由字母数字字符构成;下划线字符(‘ _ ’)也是允许的。大写和小写都可以,并且被视为互不相同。
-
名称必须以字母字符开头(即不能以数字或 ‘ _ ’ 开头)。
-
每个名称只能用于一个声明(即在同一个进程中,同一个变量名称不应用于多个变量类别)。
-
数据类型——变量的数据类型规定它能够存储的信息种类。Modeler 为常见建模用途预定义了许多专用数据类型。一些基本的数据类型列于下表。有关预定义数据类型及其用法的完整清单,参见“Discrete Event Simulation API”。
表 46:变量常用的预定义数据类型
| 数据类型 | 说明 |
|---|---|
| Distribution | 已加载的概率密度函数。 |
| Evhandle | 提供对已调度事件的访问权的句柄(例如支持取消该事件)。 |
| Ici | 一组属性,用于把额外的用户定义信息与某个事件关联起来。 |
| Objid | 仿真对象的唯一标识符;用于大多数对对象的操作。 |
| Packet | 表示一条消息的结构化数据字段组,该消息可以在数据包流上流动(节点域)以及在链路上流动(网络域)。 |
| Compcode | 许多内核过程返回的状态值,用于指示成功或失败。 |
| List | 由 KPs 的 Prg 包提供的链表构造。适用于管理一般用户定义数据结构的列表。 |
| Stathandle | 在登记一个本地或全局统计量时提供的句柄。用于把更新的取值写入该统计量。 |
此外,Proto-C 通过支持 C 和 C++ 语言的数据类型来提供完全通用的数据存储。这不仅包括 C 和 C++ 的内置数据类型,例如 int、double 和 char,还包括数组,以及由任何其他数据类型任意组合构成的复杂数据结构。
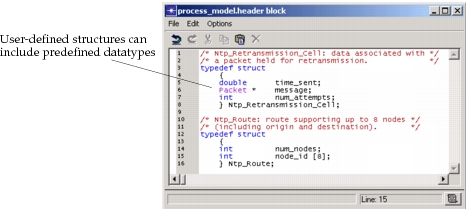
自定义数据类型通常在进程的 header 块中规定,或在规定于一个外部定义文件中、并通过 header 块中的 #include 语句包含进来。一般使用 C 的 typedef 和 struct 机制,如下面的例子所示。有关使用这些构造的完整信息,请查阅 C 或 C++ 语言参考书。
图 108:Header 块中自定义数据类型的定义
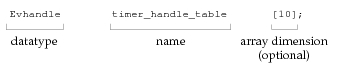
变量的声明格式因其类别而略有不同;各类别的声明机制在各主题中分别说明。但在所有情况下,声明都要求指定变量的数据类型和名称。此外,可以修改变量,使其实际上成为其特定数据类型的一个或多个维度的数组。一般地,声明格式如下:
图 109:变量的声明格式
- 取值——这一术语指的是与某个变量相关联的内存的实际内容。对于简单变量,它可能是一个单独的数值或一串字符;对于复合数据结构,可能涉及许多这样的项。变量内容的具体性质和组织方式由其数据类型规定。这些内容可以随时间变化,以存储新的或更新的信息,正如进程模型所要求的那样,因此得名变量。
对变量的操作
Proto-C 变量的取值在状态和转移的条件与执行体语句中被操纵。无论变量的类型如何,可以对它执行的基本操作是获取它的值或修改它的值。请注意,变量的数据类型和名称是不可变的。
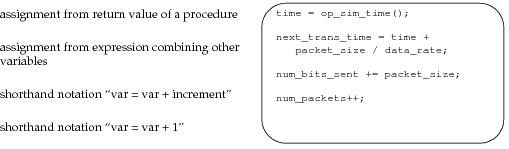
取决于变量名称在语句中的使用方式,它的值可以被获取或被修改。一般地,所有变量操纵都遵循 C 语言的约定;因此多数 C 语言教科书都应对此主题提供深入的介绍。简略地说,有两种基本形式支持修改变量的值。第一种也是最常见的一种,是使用等号(=)运算符进行赋值,下面给出了若干例子:
图 110:使用 ‘=’ 运算符为变量赋值
第二种赋值方法旨在让某个过程修改变量的值,而不是在本地上下文中修改它。这是通过告知该过程变量值所存储的内存位置来实现的。因此,该过程可以修改那些内存位置的内容,当它返回时,赋值已经完成。许多内核过程采用这种接口,以支持在一次调用中修改多个变量(C 和 C++ 函数否则无法返回多个值),或者计算若干不同数据类型的结果。在 C 和 C++ 语言中,变量值的内存位置是通过对变量名称应用 & 运算符获得的,如下面的例子所示。
图 111:通过向过程传递地址为变量赋值
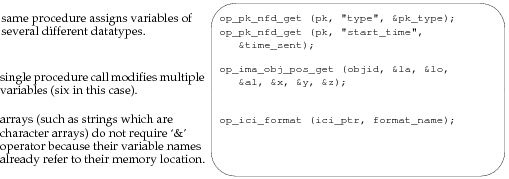
获取变量的值非常简单,因为变量的名称实际上就是代表其值的符号。换句话说,仅仅提及一个变量,C/C++ 语言就会自动把它当前的值替换到周围表达式中出现的位置。不过请注意,对变量使用 = 运算符进行赋值时也是如此,如上所示。因此,赋值与取值之间的区别更多取决于变量名称相对于表达式中运算符的位置。当使用 = 运算符时,运算符左侧的变量值被修改,而右侧的变量值只是被获取(也就是说,它们的当前值被替换到其名称出现的位置)。
对 Proto-C 变量执行的其他常见操作包括比较运算符,例如 ==(等于)、!=(不等于)、>(大于)、<(小于)、 >=(大于或等于)、<=(小于或等于)。请注意,相等性测试运算符由两个并排的 ‘ = ’ 字符构成,而赋值运算符只由一个这样的字符表示,二者之间的区别值得留意。把两者混淆是进程行为中常见错误的来源。
此外,还支持 +、-、*、/ 之类的算术运算,以及所有其他 C/C++ 语言特性。有关这些运算符及其他运算符的深入论述,请参见 C 或 C++ 语言参考书。
状态变量
用于表示进程累积并保留的信息的变量称为状态变量。这一名称的由来是,这些变量与进程在其状态转移图中的当前位置一起,表示进程在任何时刻的完整状态。请注意,进程可能随时间产生或接触到大量信息,而这些信息并未被编码进它的状态;因此状态只指进程自己决定保留的信息,即通过把它记录到状态变量中来保留。
状态变量在 Proto-C 模型中一个专门的区域中声明,该区域称为状态变量块。可以通过从进程编辑器的 Code Blocks 菜单中选择 State Variables 来声明新的状态变量或修改已有的状态变量。有关使用该操作的细节,参见“State Variables”。
状态变量是持久的,这意味着从每个进程的角度看,它们随时间保留其取值。它们只能由该进程自己执行的显式赋值语句修改。这意味着当进程阻塞时(即在完成一个 unforced 状态的 enter 执行体后停止执行),状态变量的取值被“冻结”,并且该进程在下次被调用恢复执行时会发现它们未曾改变(请注意,虽然很少使用,内核过程 op_ima_obj_svar_get() 允许改变状态变量的这一传统特性)。
状态变量的一项持久性所必需的重要特性是,它们以对每个进程私有的方式维护。这意味着同一个进程模型的各个实例,即使存在于同一个队列或处理器内,也可以在它们的变量中独立地存储信息而不发生冲突,即使它们使用相同的名称来引用这些变量。换句话说,在一个进程中修改状态变量不会影响另一个进程所持有变量的取值。
进程第一次被调用时,状态变量没有任何特定的初始取值。由于这些变量是进程状态的一部分,为它们指派一致的初始取值是进程自身的责任,这一工作在第一次调用期间完成。事实上,这通常是在初始状态的执行体语句中开展的主要活动之一。请注意,与临时变量和全局变量相反,状态变量不能在其声明中纳入自动初始化。
由于状态变量的底层实现方式,在选择状态变量名称时必须提出一项重要告诫。必须避免与进程模型其他地方使用的符号发生命名冲突。特别地,一个状态变量名称
- 不得与模型其他地方出现的临时变量、函数、函数参数、结构字段或函数的局部变量的名称相同
- 不得作为子串出现在 function 块代码中
上述任一条件都会导致编译错误。
临时变量
进程可以声明临时变量来存储不需要持久性的信息。临时变量在进程模型被调用时不保证具有任何特定的取值集合。特别是,同一进程在其上一次调用期间为这些变量指派的取值可能已经被改变。
由于临时变量不具持久性,它们只适合作为“草稿”存储,用于辅助计算复杂表达式,或在一次进程调用的时间范围内保存信息。例如,一个用作循环索引的整数变量通常是临时变量;一个在一次调用中被获取、检查、修改并再次发送的数据包,也是临时变量。要决定进程模型应当在状态类别还是临时类别下声明某个变量,开发者应当判断是否存在该变量需要把取值从一次调用保留到下一次调用的情形。如果是这样,就必须使用状态变量;否则可以使用临时变量。如果对某个变量的声明类别存有疑问,那么总是可以安全地使用状态变量;不过请注意,状态变量需要分配与之大小相应的内存,并且该内存将持续到进程存在结束为止,而临时变量不需要额外内存。
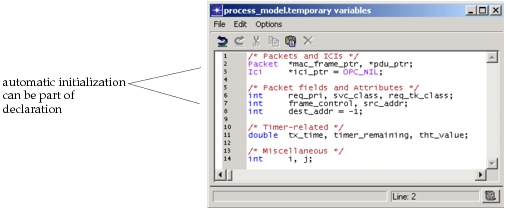
临时变量在通过使用“edit temporary variables”操作而出现的编辑面板中声明。临时变量声明的例子见下文。可以声明任何预定义的 C/C++ 和 Riverbed 数据类型,也可以声明用户定义的数据类型。请注意,与状态变量的情形不同,变量名称之前没有反斜杠字符(‘\’)。
通过在声明中纳入一个赋值,可以对临时变量进行自动初始化,如下面例子所示。每次进程被调用时都会执行这一初始化。
图 112:临时变量的声明
全局变量
全局变量为位于不同模块中的多个进程(包括不同类型的进程)提供了一种把信息存储在公共位置的手段。这是 C 和 C++ 语言直接提供的一项特性,这些语言也把这类变量称为 globals。
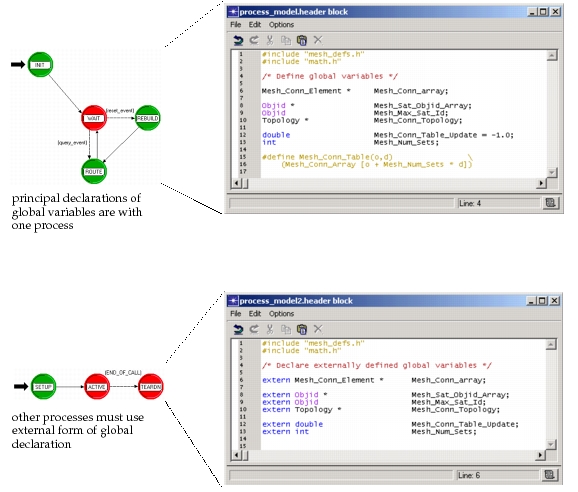
全局变量可以使用任何 C 或 Riverbed 预定义的数据类型,也可以使用自定义数据类型。声明应当通过进程编辑器的“edit header block”操作录入进程模型的 header 块。每个全局变量应当在其关系最密切的那个进程模型的 header 块中有一个主声明。如果其他进程模型也共享对该变量的访问,它们的 header 块必须包含一个外部声明。对某个全局变量可以有任意数量的进程模型带有外部声明,但只应当有一个包含主声明。外部声明由关键字 extern 标识,如图 113 所示。
与临时变量一样,可以通过在声明语句中进行赋值来完成全局变量的初始化。这只有在主声明中才可能。初始化在仿真开始之前进行。依赖于仿真输入或模型配置的额外全局变量初始化,通常由指定进程在它们最初的调用期间执行。
图 113:在两个进程 Header 块中声明全局变量
全局变量应当谨慎使用,因为它们会在进程之间造成依赖。换句话说,当一个进程修改某个全局变量时,这一更改可能影响其他进程的运行。此外,跨物理边界共享的全局变量(例如跨整个网络模型)并不总是对应于对实际系统的逼真表示。模型中可以用全局变量表示的同一数据,在实际系统中可能实现为分布式存储;或者即使使用集中式存储,访问该数据时也会产生时延。模型开发者必须对采用全局变量方式是否恰当作出判断,并可能需要对它引入的不真实效应作出修正。
全局变量还会给并行仿真带来问题。细节参见“Global Variables”。
进程模型属性
进程模型设计者常常需要规定进程的某些特性,这些特性要求能够适应各种情形的灵活性。例如,通信协议可能为其用户提供各种选项,例如超时时长、最大重传次数、窗口大小等。类似地,一个计算机操作系统模型可能提供虚拟内存大小、最大并发任务数等多种选择。与其设计仅在这些问题上有所不同的多个相似进程模型,不如设计参数化的进程模型。进程中那些需要可变性的特性可以被视为该模型的参数。
如“Modeling Framework”所述,Modeler 为开发参数化模型提供了模型属性。进程模型是通常最充分利用这一能力的模型,因为归根结底,必须由用户定义的代码以某种方式解释定制属性的取值,才能实现可变的行为(相比之下,标准对象的可变行为是通过内置属性来配置的)。通常最好的做法是在使用模型属性的同一个模型中定义它们。
可以使用进程编辑器的“edit model attributes”操作为进程模型声明模型属性。每个模型属性通过指定一个唯一名称和若干特性来定义。这些特性可以控制属性的默认取值、符号映射、适用时的数值范围,以及其他若干特性。有关模型属性和属性特性的更多信息,参见“Modeling Framework”。
图 114:进程模型属性的声明
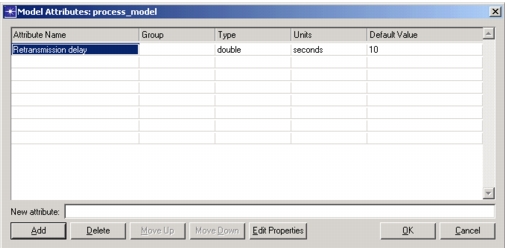
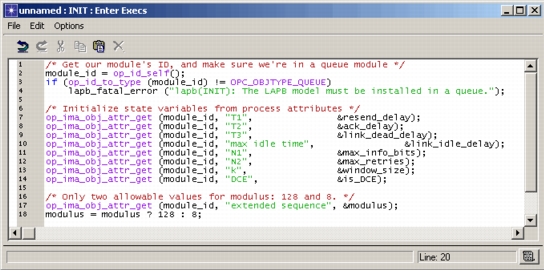
在仿真期间,进程模型属性只是作为队列和处理器模块的属性出现。它们可以分别使用内核过程 op_ima_obj_attr_set() 和 op_ima_obj_attr_get() 来修改和获取取值。不过在多数情况下,进程模型属性在仿真期间从不被更改,而是仅仅作为参数,供进程在仿真开始时配置自身时使用。通常,每个使用模型属性的进程都在其初始状态中完成这些配置,把各属性的取值载入一组对应的状态变量。此后使用状态变量,因为访问它们比访问属性更方便、更高效。模型属性载入的典型例子见下文。
图 115:初始化时把进程模型属性载入状态变量
属性接口
每个进程维护一组属性接口,它与它的模型属性是不同的。如“模型属性接口”所述,属性接口中包含从模型内部对象提升上来的属性,以及对将要使用该模型的对象之属性的规定。就进程模型而言,模型内部的对象(例如状态和转移)都不能提升属性,而将要使用该模型的对象是队列或处理器。因此,属性接口仅仅由队列和处理器属性构成。通过使用属性接口,进程模型开发者可以预先规定将要使用该模型的队列或处理器的取值和特性。
图 116:进程模型属性接口的规定
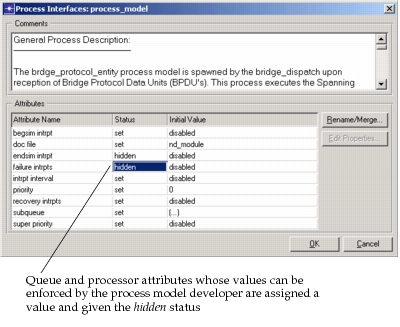
进程模型属性接口常用于确保队列和处理器被正确配置,以充当某个给定进程模型的宿主。一般地,与进程模型无关的属性被置于“hidden”(隐藏)状态,以简化 QP 的菜单。在许多情况下,这包括“intrpt interval”、“failure intrpts”、“recovery intrpts”、“super priority”等属性。进程模型设计者通常知道该进程是否需要一个 begin simulation 中断、以及它是否支持一个 end simulation 中断;“begsim intrpt”和“endsim intrpt”属性可以据此设定并隐藏。
进程模型属性接口还提供为进程模型关联注释的能力,以便向进程模型的用户提供指导信息和背景信息。有关模型属性接口的更多信息,参见“Modeling Framework”。
计算的模块化
某些进程模型反复使用同一个计算来支持某个决策或动作。相同并不一定意味着结果总是相同,只是说该计算的形式(即它可以被分解成的那些步骤)是不变的。然而,该计算所操纵的数据可能在每次执行时都不同。这些数据称为该计算的输入,构成输入的每个单独数据项称为该计算的一个参数。
实现一个反复使用同一计算的进程模型,最直接的做法就是在该计算出现的每个位置(即各个执行体块中,以及执行它的每条转移上)详细地重复规定该计算。然而,这种做法带来若干显著的缺点:
- 它要求重复录入,从而延长完成一个模型规定所需的时间。
- 它要求重复维护,也就是说,如果需要更改该计算(例如为了增强或更新模型的功能),那么必须在进程模型的多个部分作出完全相同的更改。
- 对于复杂计算,模型的规模可能明显增大,进而影响一次仿真的总内存需求。
- 进程模型逻辑不够精简,使得研究该进程模型的人(例如为了理解或升级其功能)必须检查或验证多得多的语句。
Proto-C 中有两种主要技术用于精简同一计算的重复规定。两者的目标都是把该计算的规定封装成一种形式,以便在需要该计算结果时随时复用。Proto-C 动态进程和 C/C++ 函数都支持这种模块化计算的做法,因为它们都可以包含作用于可变输入(称为参数,argument)的通用计算。参数就是计算的各个参数。
使用动态进程实现计算模块化
动态进程在本节前面的各部分以及“Modeling Framework”中都有深入说明。这里简要介绍它们用于使计算模块化的用法。
- 必须规定一个包含所关注计算全部逻辑的动态进程。该进程应当使用通过内核过程 op_pro_argmem_access() 获得的参数内存来表示该计算的各个参数。此外,该进程应当是无状态的(stateless);这意味着它不应定义任何状态变量,并且只包含一个 unforced 状态,以确保只有调用的各个参数影响每次的结果。换句话说,不应存在内部累积的信息,使各次独立调用之间产生依赖。
- 需要重复计算的进程通过调用内核过程 op_pro_create() 创建一个适当类型的动态进程,并保留返回的进程句柄。这必须在计算首次使用之前的某个时刻完成——通常是在父进程的初始状态中。
- 每当父进程需要执行该计算时,它必须设置适当的参数内存,并使用先前获得的进程句柄通过内核过程 op_pro_invoke() 调用子进程。如果需要,子进程可以通过修改参数内存来返回结果。
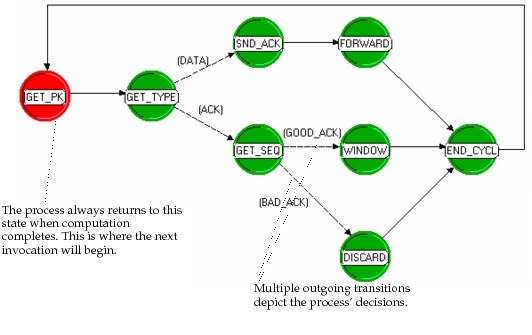
使重复计算模块化并不是动态进程的主要应用。进程主要是为建模持续执行的线程而设计的。这些线程通常具有状态内存,因此在每次调用时行为并不相同。然而,上文概述的动态进程做法在某些场合下被用作 C 或 C++ 函数(本节后面将介绍)的一种替代,因为它允许对计算的控制流进行图形化分解。forced 状态表示简单的动作,而关于应当执行哪些动作的决策则编码在各状态之间的转移中。下图展示以这种方式表示一个计算,如何类似于某些计算机程序设计方法中作为第一步使用的流程图方法。
图 117:实现模块化计算的动态进程的控制流
使用函数调用实现计算模块化
使重复计算模块化最常见、最直接的做法是利用 C 和 C++ 语言提供的函数调用机制。函数(也称为过程)是可以接受参数(称为参数,arguments)的计算规定。参数可以是 C、C++、Modeler 或用户自定义定义所提供的任何数据类型。根据它们被要求完成的服务,函数可能提供由其计算得出的返回值,或者只是执行一系列动作而不返回结果。有关定义函数的更多信息,请参见 C 或 C++ 参考书。
在 Proto-C 中,可以在一个称为进程模型function 块的区域中规定任意数量的函数。function 块的内容可以通过进程编辑器的“edit function block”操作编辑。C/C++ 编程语言的所有正常语法规则都适用于模型的这一部分。不过请注意,在 function 块中输入的文本将出现在 header 块文本之后,因此可以使用其中定义的数据类型和宏。
每个函数代表一“包”能力,供状态转移图(STD)中嵌入的逻辑调用。这简化了 STD 的外观,并使它能够在多种情形下运用相同的功能,而只需极少的额外规定。例如,某个 STD 可能需要在不同状态中、以及在沿若干条转移前进时,对同一个数据包施加完全相同的一系列动作;通过把这些动作实现在 function 块中的一个函数内,所需逻辑只需开发一次,并从模型中要求执行它的各个部分调用它。
在 function 块中规定的函数通常供与之关联的那个进程模型使用。不过,一个进程模型的 function 块中定义的函数,可以从另一个进程的 STD 甚至从其 function 块中调用。然而,这种做法会在进程模型之间造成依赖,使得实际包含该函数定义的进程模型,必须始终存在于同时包含调用该函数的那个进程的模型之中。如果不遵守这条规则,那么在试图生成仿真时,会出现与缺失函数有关的错误。
解决函数交叉调用所造成依赖的一个简单办法,是把所需的全部函数调用都纳入自己的 function 块,从而使每个进程模型自给自足。然而,这一技术有两个重要的注意事项:第一,如果同一个函数出现在多个进程模型的 function 块中,那么它在每个模型中必须使用不同的名称,否则该函数将被视为“多重定义”,并且在试图创建包含这些冲突进程的仿真可执行文件时会出现相应的错误。避免这一问题的一种可能做法,是始终把 function 块内定义的函数名称以该进程自身的名称作为前缀。例如,一个为名为 X25 的进程调度超时事件的函数,可以命名为 x25_schedule_timeout。第二,通过在多个进程模型的 function 块中复制某个函数来重复规定某种能力,恰恰违背了最初建议使用函数的一个重要目的;也就是说,多个实例之间的重复维护和同步会使开发与维护工作变得复杂,并导致各版本之间出现不一致。
外部目标文件
作为这一做法的替代,模型开发者可以考虑把函数定义在链接进仿真可执行文件的外部目标文件中。这样每个函数都可以以集中方式开发和维护,同时仍被所有需要它的进程模型共享。不过,这会在进程模型与包含这些函数的外部文件之间造成依赖。这使得进程模型不再是“独立自足”的,例如在与其他用户共享该模型时可能造成小的麻烦。
Modeler 允许用户在两个不同的建模层次上指定某个模型所需的外部目标文件。如果需要,外部目标文件清单可以作为网络模型的一部分加以规定。然而,这种做法要求用户了解当前存在的节点模型所隐含依赖的外部文件。这并不总是可能或可取的,特别是当网络层次的用户与开发其中嵌入进程模型的人不是同一个人时。这对于其他 Riverbed 分析软件产品的用户可能是一个问题,他们操作节点模型和链路模型,但通常不了解模型的构成。为了绕过这一问题,同时也为了在外部文件与依赖它的代码之间提供更牢固的关联,Modeler 允许每个进程模型正式声明它所依赖的外部目标文件。这可以使用“Process Editor”的“declare external object files”操作完成。声明外部目标文件使 Modeler 能够自动构造构建一个完整仿真所需的外部文件清单;这对网络层次的用户是透明的。有关外部目标文件的更多信息,参见“仿真设计”。
声明函数
如果函数返回的不是整数类型的值(即其数据类型除 int 之外),那么这些函数应当在使用之前声明。如果它们在 STD 的执行体和条件语句中使用,则相应的函数声明应当放在 header 块中,以确保它们以正确的顺序出现。函数声明的目的是告知编译器将返回何种类型的值。声明语法见下图。
图 118:Header 块中对函数的声明
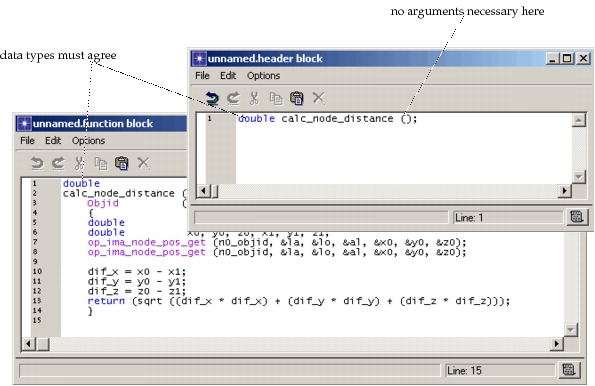
在 function 块中定义的函数,其访问变量的基础与相关联的进程模型略有不同。全局变量以完全相同的方式可用,但需要在 header 块中有声明(主声明或外部声明均可)。进程的临时变量不能在 function 块的函数中使用。不过,每个函数当然可以声明自己的局部变量。状态变量对 function 块中的函数是可用的,但直接引用这些变量会使其他进程无法调用该函数。换句话说,只有当状态变量属于相关联的那个进程模型(即包含该 function 块的模型)、并且该进程模型正是当前正在执行的模型时,才可以访问它们。在 function 块中误用状态变量可能导致复杂的仿真错误,因此必须非常谨慎地考虑。避免这一问题的一种简单做法,是把状态变量的取值作为参数传递给函数,而不是让函数直接访问它们;类似地,如果调用方函数需要修改状态变量的取值,那么可以把状态变量以地址形式作为参数传递给该函数,或者在该函数返回之后由更高层次的代码执行赋值。
诊断能力
离散事件仿真自动包含一个精密的“调试器”,称为 ODB,它使用户能够交互式地监视仿真的进展及其各个对象的状态。ODB 的能力通过命令行使用。这些能力中的绝大部分完全由仿真内核提供,不需要开发者作任何定制。然而,由于进程是用户定义的、可以把信息存储在专有数据结构中,而且由于仿真内核无法了解进程中哪些特定信息值得报告,ODB 提供了两个可以应用于进程的特殊命令。这两个命令称为 prodiag 和 proldiag,它们允许打印关于某个用户定义进程当前状态的有用报告。
prodiag 和 proldiag 命令需要一个参数,即所关注进程的进程 ID。进程 ID 可以通过 ODB 的 promap 命令方便地获得。随后 prodiag 和 proldiag 执行一系列由用户提供的语句,这些语句已经规定在进程模型的一个特殊区域中,该区域称为诊断块。进程的诊断块可以通过进程编辑器的“edit diagnostic block”操作修改。
在执行某个进程诊断块中的语句之前,ODB 会临时使该进程处于活动状态,就好像它被调用了一样,从而可以使用 op_id_self() 和 op_pro_self() 之类的内核过程。此外,可以正常访问该进程的状态变量。
诊断块中可以定义一般的 Proto-C 逻辑,尽管一般而言诊断块中的语句相当简单,因为它们的目的只是报告构成进程状态的那些信息。在某些情况下,需要 for 或 while 循环来报告列表的内容;if 语句有时也用于只报告与某个给定情形相关的信息。某个进程模型诊断块的例子见下图。
图 119:典型的进程模型诊断块
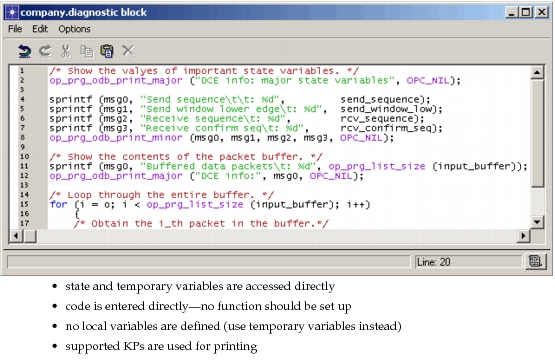
从该例子中请注意,打印信息使用的是内核过程 op_prg_odb_print_major() 和 op_prg_odb_print_minor(),而不是 C 库函数 printf()。这两个内核过程标准化所打印信息的格式,以使其与 ODB 发出的其他输出更好地整合。该例子还表明,诊断块本身不是一个函数,因此不能声明局部变量。不过,它可以利用在进程的临时变量区域中声明的变量。
ODB 还提供了 prodiag 命令的一个更精密的版本,称为 proldiag。proldiag 与 prodiag 的区别在于,它临时激活一个调试器标签(debugger label),该标签可用于在诊断块中有选择地执行操作。有关这一主题的更多信息,参见“Simulation Debugger (ODB)”第 39 页以及第 85 页上对内核过程 op_prg_odb_ltrace_active() 的说明。