事件调度与事件表
进行中的仿真既可以看作事件的产生者,也可以看作事件的消费者。新事件由仿真模型的各个组件产生,用于调度新的未来活动,其依据是组件底层的行为模型。随着仿真时间的推进、所指定的事件时刻被逐一越过,事件被逐一消费。
离散事件仿真使用事件表来管理事件。维护事件表的目的是确保所有事件都按正确的时间顺序执行。每个事件都关联一个指定其发生的时间。请求新事件(需要指定这些事件必须执行时的仿真时间)的过程称为事件调度。可以说事件被调度在特定的时刻。事件可以被调度在任何未来时刻,或者当前时刻,但绝不会被调度在过去时刻,因为仿真时间变量只能向前推进。新事件被调度在当前仿真时间上是很常见的,因为这对应于一串相互引发的事件,它们所依赖的机制被建模为零延迟。例如,通过数据包流传输数据包,或者通过统计量线传输数值,通常都是无延迟执行的。
仿真事件表按时间顺序维护所有事件,使得当前事件执行完毕后可以方便地确定下一个事件。最早的剩余事件被称为事件表的表头(head),最晚的事件称为表尾(tail)。在每个事件的执行过程中,都可能调度新事件,包括调度在当前仿真时间上的事件。因此在事件执行期间,事件表的表头或表尾可能被新事件替换。图 67 针对一组典型的已调度事件,描绘了事件表的概念结构。
关键概念——事件由仿真内核在事件表中进行管理。新事件由内核以及模型内部的实体插入表中。内核从事件表中取出事件并按时间顺序执行它们。
图 67:按执行时间组织的事件表
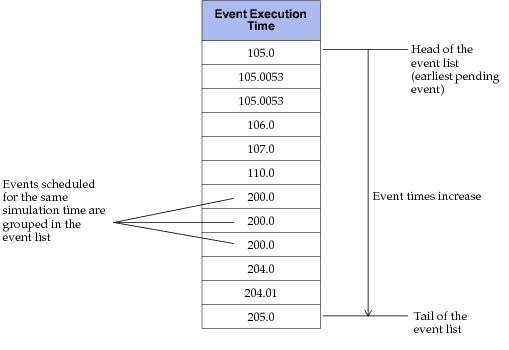
“事件表”这一术语仅指该表的概念结构。虽然事件表现得好像是以顺序列表的形式组织的,但实际上它们存储在专有数据结构中,这些数据结构在保持所需顺序的同时,支持非常高效的事件插入与取出。对所有用户可见的事件存储接口,都维持这种“类列表”的抽象。特别地,用于扫描事件表并查询事件属性的内核过程 Ev 包,向用户隐藏了底层组织方式。
在仿真过程中,随着新事件的调度以及先前已调度事件的执行或取消,事件表可能不断增长和收缩。每次仿真都会有其自身特定的事件表增长模式,这取决于所建模的活动。由于所有已知的未来事件都已被调度并放入事件表,因此只要表中还包含待执行的新事件,仿真就必须继续。所以,如果因执行最后一个剩余事件而导致表变为空,那么该事件完成时仿真即告终止,除非它又调度了至少一个新事件。空的事件表会使仿真结束,而不论此时已经过去了多少仿真时间。
在仿真开始时,事件表必须至少接收一个事件,执行才能开始。最初调度的事件通过依次引发其他事件来“启动”仿真。一种称为“begin simulation”的特殊事件类型,可以通过在节点域内的处理器和队列模块上启用“begsim intrpt”属性,为进程自动调度。此外,处理器模块会根据其指定的分布自动选择发出第一个数据包的时刻。这些就是在仿真开始时检查事件表通常会看到的事件类型。
关键概念——随着仿真的进行,事件因插入而增长、因执行而收缩。仿真开始时,某些预定义事件被插入事件表以允许执行开始。如果事件表在任何时刻变为空,仿真即告完成。
事件属性
到目前为止,事件被表述为代表仿真活动的抽象条目,并带有关联的时间。然而,仿真事件具有一系列重要属性,提供关于事件应如何执行的详细信息。表 35 列出了事件属性。
注意: 取决于事件类型,可能只有某些属性是相关的。
关键概念——每个事件都有一组存储描述信息的属性。其中某些信息由仿真内核用于执行事件。这些信息也可被用户自定义的逻辑用于根据事件的特征来处理事件。
表 35:事件属性
| 属性名称 | 属性的意义 / 用途 |
|---|---|
| time | 事件应被执行的仿真时间 |
| execution ID | 与事件执行顺序相关的唯一标识符 |
| schedule ID | 与事件调度顺序相关的唯一标识符 |
| module | 事件将发生在其中的模块(节点域对象) |
| process | 将接收该事件的唯一进程 |
| type | 13 种受支持的活动分类之一 |
| code | 整数值,其解释取决于事件的类型;对某些事件可由用户定义,对其他事件可表示到达端口索引 |
| packet | 其传输引发该事件的数据包 |
| ICI | 与该事件关联的接口控制信息(Interface Control Information)结构 |
| state_ptr | 用户自定义数据块的地址 |
| source object ID | 引发该事件的事件所在模块的对象 ID。 |
下面的列表提供关于表 35 中所列事件属性的更多信息。
- time – 每个事件都有一个指定其执行时的仿真时间。这是一个非负的 double 精度浮点数,用于在已调度事件之间确立执行顺序。每个事件必须在所有 time 属性值更大的事件之前执行。
- execution ID – 该标识符在每个事件执行时递增 1。对于事件表中的某个给定事件,其值难以预测,因为新事件可能被插入,从而改变预期的执行顺序。execution ID 的主要用途是引用已经发生的事件,主要是在使用 Modeler 调试器 ODB 交互式分析仿真时使用。
- schedule ID – 该标识符遵循新事件的产生顺序。每当需要新事件时,都通过将其插入仿真内核的事件表来调度它。由于事件可以被调度在任何未来时刻(相对于当前仿真时间),schedule ID 与 execution ID 之间不存在任何可预测的对应关系。
- module – 所有仿真事件在节点域内都有一个指定的位置,为其执行提供上下文。例如,可以调度一个事件来建模数据包到达某个特定发射机;由统计量线传递的统计量变化将在某个特定的处理器或队列处引发事件。
- process – 由于每个处理器或队列模块内可能有多个进程,某些事件在调度时必须指定所关注的具体进程。特别地,用于指示时间间隔已结束的 self 中断,必须投递给外围模块内的某个特定进程(具体而言,就是最初调度该中断的那个进程)。
- type – 该属性在决定仿真内核如何处理事件方面起着主要作用。根据事件的类型,内核将调用特定的处理机制来执行它。事件的类型在事件被调度时确定,并取决于其起因以及它预期被处理的方式。共有 13 种事件类型,旨在支持不同类型的建模活动。例如,“self”类型的事件由进程调度并隐式返回到同一个进程——它用于通知时间间隔的结束;而“stream”类型的事件是两个模块之间发送数据包的结果。每种事件类型在本节后面的部分中有更详细的描述。
- code – 某些事件可以携带一个整数码,其值在调度时指定。该码的解释因事件类型而异。对于某些服务于应用特定目的的通用事件,这个码提供了一种机制,使用户能够与事件关联额外信息,并在事件被执行的上下文中(可能是较晚的时刻)取回它。例如,一个进程可能维护许多同时存在的间隔定时器,它们被建模为“self”类型的事件;它可以使用与每个事件关联的码作为区分它们的方法。对于 stream 事件和 statistic 事件,code 属性保留给系统使用,分别表示数据包和新统计量值到达所在的输入流和输入统计量。
- packet – 若干类型的事件用于表示与数据包相关的活动,例如数据包到达目的地,或其传输的完成。对于这些类型的事件,packet 属性只是引用所涉及的数据包。
- ICI – 接口控制信息结构(ICI)是多成员数据项,可与进程调度的事件关联。ICI 包含由用户指定格式所定义的格式化信息。其目的是允许把应用特定的信息(除调度事件本身固有的信息之外)传送到事件的目的地。这种机制的一个常见用途是支持协议层传递与所传输数据包相关的参数(例如服务质量、目的地等),从而避免把这些参数值写入数据包本身。
- state_ptr – 该事件属性允许将与内存任意区域的指针关联到事件上。内存块的内容和格式由用户定义,仿真内核并不知晓。该机制的目的是支持在事件被调度的上下文与事件被执行的上下文之间传递完全通用形式的数据。目前只有“procedure call”类型的事件支持使用 state_ptr 属性。
- source object ID – 大多数事件由一个对象为另一个对象或为其自身产生。例如,数据包源向其他模块发送数据包,并调度事件来实现数据包的到达;处理器使用调度来为其自身产生未来事件。对于这些事件产生可归因于某个特定模块的情形,source object ID 就是该模块的对象 ID。在事件由仿真内核调度的情形中,例如 begin-simulation 事件或 end-simulation 事件,source object ID 将具有一个表示这一事实的特殊值。因此该属性的确切解释取决于事件类型;更多信息见事件类型。
事件类型
Modeler 定义了十三种事件类型,以支持各种建模活动。某些事件类型仅用于表示非常特定类型的活动,而另一些则面向通用的用户自定义目的。下表列出每种事件类型所提供的功能。
表 36:仿真事件类型及其用途
| 事件类型 | 用途 |
|---|---|
| self | 定时器与延迟动作。 |
| stream | 同一节点内模块之间的数据包通信。 |
| statistic | 对统计量、信号量、数值信号变化的异步通知。 |
| regular | 自动的周期性活动,例如轮询输入、发送状态消息、总线周期的开始等。 |
| failure | 异步通知网络域内某个节点或链路已失效(即 condition 属性变为 disabled)(例如允许路由表重新配置)。 |
| recovery | 异步通知某个节点或链路已从失效中恢复。 |
| begin simulation | 通知仿真开始,使进程能够初始化其状态。 |
| end simulation | 通知仿真结束,使进程能够记录最终信息,例如标量统计量、自定义报告。 |
| access | 一个进程为另一个进程产生请求。 |
| remote | 模块之间通信命令、请求、指示或其他通用信息,无需任何物理连接;这些模块可以位于不同节点中。 |
| procedure call | 需要在未来某时刻执行过程调用的用户自定义目的。 |
| multicast | 同时调用整个被建模系统中的所有处理器和队列模块。 |
| process | 直接调用模块内某个特定的进程,而不是根进程或其他已注册进程。 |
事件可以由多种机制创建,这些机制可能由仿真内核驱动,也可能由用户提供的模型中的逻辑驱动。内核通常只负责调度那些仅仅源于对象属性配置的事件,例如由于处理器或队列指定了 ”intrpt interval” 属性而产生的 regular 事件;另一个重要示例是为所有启用了“begsim intrpt”属性的处理器和队列调度“begin simulation”事件。而用户自定义进程则是与通用活动相关的事件的来源,例如信息通信、资源访问以及告警条件处理等。下表列出每种事件类型可能被生成的方式。
表 37:事件产生机制
| 事件类型 | 产生机制 |
|---|---|
| self | 调用内核过程 op_intrpt_schedule_self () |
| stream | 使用 op_pk_send...() 或 op_pk_deliver...() 中的任意内核过程转发数据包 |
| statistic | 更新统计量,或由内核自动完成,或调用内核过程 op_stat_write() |
| regular | 若处理器或队列的“intrpt interval”属性未被禁用,则由内核自动提供 |
| failure | 每当节点或链路的 condition 属性变为 disabled,内核自动提供给未禁用“failure intrpts”属性的处理器和队列 |
| recovery | 每当节点或链路的 condition 属性变为 enabled,内核自动提供给未禁用“recovery intrpts”属性的处理器和队列 |
| begin simulation | 在仿真开始时,内核自动提供给启用了“begsim intrpt”属性的处理器和队列 |
| end simulation | 在仿真结束时,内核自动提供给启用了“endsim intrpt”属性的处理器和队列 |
| access | 调用内核过程 op_strm_access() |
| remote | 调用内核过程 op_intrpt_schedule_remote() 或 op_intrpt_force_remote() |
| procedure call | 调用内核过程 op_intrpt_schedule_call() |
| multicast | 调用内核过程 op_intrpt_schedule_mcast_global() |
| process | 调用内核过程 op_intrpt_schedule_process() |
取决于事件的类型,它将使用前一节所描述的某些事件属性。事件类型本身也是一个属性,但它并不足以描述执行该事件所必须完成的实际工作。其余相关属性在事件被调度时设置,并在事件被放入事件表时与事件一同存储。这些信息随后在其仿真时间到来、事件执行时可供使用。下表汇总每种受支持的事件类型的相关属性。注意,对所有事件类型都具有相似解释的标准属性,例如 time、execution ID、schedule ID、module 和 type,不在下表中列出。
表 38:主要事件属性的意义
| 事件类型 | 属性的意义 |
|---|---|
| self | code – 具有用户自定义解释的整数值;通常用于在某个进程调度的所有 self 事件之间加以识别;通过 op_ev_code() 访问。 ICI – 可选的通用信息,在调度该事件时提供。 source object ID – 与接收该事件的模块相同。 |
| stream | code – 数据包到达所在的流的索引,可以获取;通过 op_ev_strm() 访问。 ICI – 可选的通用信息,在发送数据包时提供。 packet – 其接收引发该事件的数据包。 source object ID – 发送该数据包并引发该事件的模块。 |
| statistic | code – 源值发生变化的统计量线所连接的输入索引;通过 op_ev_stat() 访问。 ICI – 可选的通用信息,在更新统计量时提供。 source object ID – 更新该统计量并引发该事件的模块 |
| regular | source object ID – 等于常量 OPC_OBJID_KERNEL。 |
| failure | source object ID – 已失效的节点或链路的对象 ID。 |
| recovery | source object ID – 已恢复的节点或链路的对象 ID。 |
| begin simulation | source object ID – 等于常量 OPC_OBJID_KERNEL。 |
| end simulation | source object ID – 等于常量 OPC_OBJID_KERNEL。 |
| access | code – 放置访问请求的输出数据包流的索引。这就是若要到达请求方模块则应发送数据包的流;该值可通过 op_ev_strm() 获取。 ICI – 可选的通用信息,在发出访问请求时提供。 source object ID – 正在执行该访问的处理器或队列的对象 ID。 |
| remote | code – 具有用户自定义解释的整数值;用于传递简单信息,例如状态值或命令码;通过 op_ev_code() 访问。 ICI – 可选的通用信息,在请求 remote 事件时提供。 source object ID – 正在请求该事件的处理器或队列的对象 ID。 |
| procedure call | code – 具有用户自定义解释的整数值;用于传递简单信息,例如状态值或命令码;通过 op_ev_code() 访问。 ICI – 可选的通用信息,在请求过程调用时提供。 source object ID – 正在请求该过程调用的处理器或队列的对象 ID。 state_ptr – 可选指针,指向用户分配、内容由用户定义的内存区域;允许向被调用的过程传递任意状态(作为该过程的一个参数出现)。 |
| multicast | code – 具有用户自定义解释的整数值;用于传递简单信息,例如状态值或命令码;通过 op_ev_code() 访问。 ICI – 可选的通用信息,在请求 multicast 事件时提供。 |
| process | code – 具有用户自定义解释的整数值;用于传递简单信息,例如状态值或命令码;通过 op_ev_code() 访问。 ICI – 可选的通用信息,在请求 process 事件时提供。 process – 事件执行时被调用的进程的句柄;由内核用于调用该进程。 |
事件处理
在处理每种类型的事件时,通常会执行某些特定动作。这些动作通常获取随事件一同到达的信息,为应用特定的执行动作和决策做好准备。本节按事件类型逐一介绍这些常用动作,使开发者熟悉进程模型中通常会出现的逻辑类型。
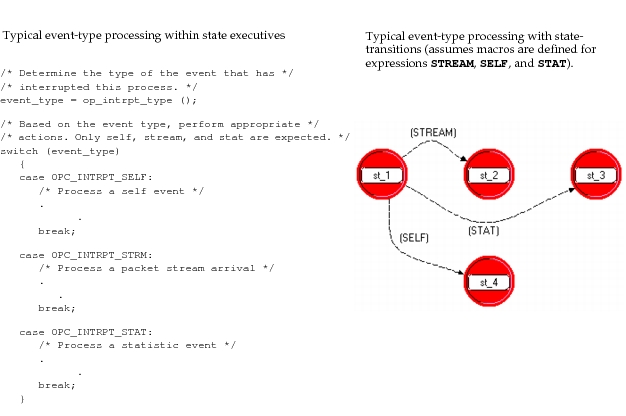
大多数进程,尤其是管理复杂交互的进程,必须在每个状态中都能处理多种不同类型事件的到达。因此,作为状态执行体(state executive)逻辑和/或转移条件的一部分所执行的基本动作之一,就是确定已发生的事件类型。用于此目的的内核过程(KP)称为 op_intrpt_type(),其用法在下面的示例中加以说明。事件类型只是进程逻辑可能分析的事件属性之一。一般而言,事件的属性可以使用来自仿真内核的 Event(或 Ev)包的 KP 来获取。Interrupt(或 Intrpt)包中的某些 KP 也可以使用。Ev KP 与 Intrpt KP 的区别在于,Ev KP 可应用于任何事件,包括仍存储在事件表中的未来事件。而 Intrpt KP,例如 op_intrpt_type(),则隐式地针对当前正在执行的事件。
关键概念——当进程模型处理事件时,通常需要分析事件的某些属性(例如事件的类型),以决定它将采取哪些动作。这些属性可以通过 Ev 和 Intrpt 包的 KP 获取。
图 68:基于事件类型进行处理的常见进程模型形式
-
Self – 对于可能同时有多个该类型事件待处理的进程(例如维护多个定时器的协议),事件码通常是关注的对象。如何使用它完全由进程的逻辑决定。通常,该码是进程所维护的某个对象的标识符,例如某个特定的定时器、要修改的计数器,或要重传的数据包。图 69 展示了获取事件码并使用它的过程。
图 69:处理“Self”类型事件的典型做法
/* The event is of type 'self': obtain the event code */ /* representing the timer that has expired. */ timer_index = op_intrpt_code (); /* Depending on which timer has expired, increment the */ /* lateness counter, or make a retransmission */ if (timer_index == TIMER_ROTATION) lateness_counter++; else retransmit_last_packet(); -
Stream – 当数据包到达处理器或队列并引发 stream 中断时,仿真内核会把该数据包放入输入流的 FIFO 队列。进程可以选择让它留在那里,或者将其取出。由于一个进程可以维护多个输入流(即它可能与多个数据包源相连),它可能需要确定新数据包到达所经由的输入流。这一判定以及获取新数据包所需的逻辑,在下一图中的 Proto‑C 片段中加以说明。
图 70:处理“Stream”类型事件的典型做法
/* The event is of type 'stream': obtain the index of */ /* the input stream on which the packet has arrived. */ input_stream_index = op_intrpt_strm (); /* If the packet has arrived on the stream coming from */ /* the network, accept it now. */ if (input_stream_index == STREAM_NETWORK) packet = op_pk_get (STREAM_NETWORK); -
Statistic – 当某个作为统计量线源的统计量发生变化时,根据变化的性质以及统计量线对象的配置,这可能为该统计量线的目标处理器/队列产生一个事件。由于处理器/队列可以维护多个统计量输入,通常采取的第一步是确定哪个输入与该事件相关联。下一图展示了响应 statistic 事件的典型 Proto‑C 处理序列。
图 71:处理“Statistic”类型事件的典型做法
/* The event is of type 'statistic': obtain the index of */ /* the input statistic connected to the active statistic. */ /* wire. */ input_stat_index = op_intrpt_stat (); /* If the changed statistic represents the size of the */ /* packet queue, obtain the new value to test for a */ /* critical condition. */ if (input_stat_index == STAT_QUEUE_SIZE) { current_q_size = op_stat_local_read (STAT_QUEUE_SIZE); if (current_q_size >= CRITICAL_LEVEL) { start_alarm (); } } -
Regular – 这种类型的事件由系统按周期间隔提供。regular 事件没有值得关注的属性。该事件的意义因应用而异,因此这里不提供典型示例。
-
Failure 与 Recovery – 当节点或链路的 condition 属性分别被改为“disabled”和“enabled”值时,系统会自动向适当配置的处理器和队列提供这些类型的事件。通常,受影响的进程需要确定引发该事件的节点或链路的身份。图 72 展示了这是如何完成的。
图 72:处理“Failure”与“Recovery”类型事件的典型做法
/* Determine if this is a failure or a recovery */ event_type = op_intrpt_type (); if (event_type == OPC_INTRPT_FAIL) status = DOWN; else status = UP; /* Determine the object ID of */ /* node or link whose status has been affected. */ object_id = op_intrpt_source (); /* Determine if the object is a node or a link. */ object_type = op_id_to_type (object_id); if (object_type == OPC_OBJTYPE_NDFIX) { /* Reconfigure routes as a result of node changes. */ routes_reconfig_node (object_id, status); } /* Otherwise, reconfigure to reflect link change. */ else routes_reconfig_link (object_id, status); -
Begin simulation – 这种类型的事件由内核自动提供给每个将“begsim intrpt”属性设置为“enabled”值的处理器或队列。begin-simulation 事件没有特殊的关联属性。事实上,许多进程只是假定它们的第一个事件就是这种类型,甚至不在其初始逻辑中判定事件类型。这种类型的事件通常用于使进程能够初始化其状态变量。由于进程状态内存可以由用户非常通用地定义,初始化可能涉及种类繁多的动作。初始化时执行的一项典型操作是“获知”已分配给进程属性的值。图 73 对此加以说明。
图 73:处理“Begin Simulation”类型事件的典型做法
/** This is the first invocation of this process. **/ /** Setup initial values of state variables. **/ /* Obtain the object ID of the processor in which this */ /* process is running. */ this_proc_id = op_id_self (); /* Obtain the values of the service rate and maximum */ /* packet size attributes of the processor and store */ /* these values in corresponding state variables. */ op_ima_obj_attr_get (this_proc_id, "service rate", &service_rate); op_ima_obj_attr_get (this_proc_id, "max packet size", &max_packet_size); /* Initialize other state variables. */ num_packets_processed = 0; busy = 0; -
End simulation – 当仿真到达终止时,不论原因如何,所有将“endsim intrpt”属性设置为“enabled”值的处理器和队列都会收到这种类型的事件。没有特殊的属性为由此产生的调用提供额外信息,并且所进行的处理因应用不同可能有极大差异。通常,仿真结束时的任务与基于整个仿真运行期间累积信息的定制化报告有关。图 74 中的 Proto‑C 片段给出了此类处理的一个示例。
图 74:处理“End Simulation”类型事件的典型做法
/* The simulation has completed, except for end-simulation */ /* events. Perform final actions for this process. */ /* Compute final average performance statistics. */ total_time = op_sim_time (); average_throughput = num_packets_processed / total_time; average_utilization = total_busy_time / total_time; average_delay = total_delay / num_packets_processed; /* Write these values out as scalar statistics. */ op_stat_scalar_write ("average throughput", average_throughput); op_stat_scalar_write ("average utilization", average_utilization); op_stat_scalar_write ("average delay", average_delay); -
Access – 访问请求由作为数据包流目的地的模块发出。源模块收到一个事件,并可以确定用于传递该请求的流(从它的角度看是一个输出流)。这种类型的事件通常(但不必然)表示一个请求,要求源模块在指定流上转发一个数据包。图 75 中的 Proto‑C 片段是一个示例,说明进程可能如何响应收到 access 类型的事件。
图 75:处理“Access”类型事件的典型做法
/* A request to forward a packet has been received. */ /* Determine which outgoing packet stream leads to the */ /* requesting module. */ out_stream = op_intrpt_strm (); /* If there are packets available in this module’s queue, */ /* remove the highest priority one and send it. */ if (op_subq_empty (MAIN_SUBQ) == OPC_FALSE) { packet = op_subq_pk_remove (MAIN_SUBQ, OPC_QPOS_PRIO); op_pk_send (packet, out_stream); } -
Remote – remote 事件由一个处理器或队列为另一个处理器或队列产生。与这些事件关联的属性与“self”类型事件相同。然而,由于 remote 事件可以传送到其他模块,特别是那些没有物理连接的模块,它们常被用于表示命令、请求或指示。图 76 展示了一个 Proto‑C 规格,实现了基于 remote 事件的接口的接收端。在该示例中未使用事件码,因为更通用的 ICI 可以涵盖事件码的功能。
图 76:处理“Remote”类型事件的典型做法
/* A remote event has been received; this represents a */ /* command from one of the remote nodes. */ /* Obtain the ICI associated with the event: it contains */ /* all the parameters of the command. */ ici = op_intrpt_ici (); /* Obtain the command type parameter. */ op_ici_attr_get (ici, "command type", &command_type); if (command_type == COMMAND_FLOW_OPEN) { /* Open a new buffer for a new flow of data. */ /* Obtain relevant parameters of the command. */ op_ici_attr_get (ici, "peak rate", &peak_rate); op_ici_attr_get (ici, "flow src", &flow_src); op_ici_attr_get (ici, "flow dst", &flow_dst); /* Create the new flow. */ create_new_flow (flow_src, flow_dst, peak_rate); } else if (command_type == COMMAND_FLOW_RESIZE) • • • -
Procedure call – 这是一种特殊类型的事件,为把外部软件集成进离散事件仿真提供了非常通用的、“开放”的接口。该事件导致以一个预先确定的参数列表调用某个过程。调用的上下文仍然是该事件最初被调度时所在的模块。可能有若干事件属性适用,正如本节前面所解释的,并在图 77 的 C 语言过程定义示例中加以说明。
图 77:处理“Procedure Call”类型事件的典型做法
void discard_enqueued_packet (char* state_ptr; int code) { int subq_index; Packet* pk; /* This procedure is invoked as a scheduled event in */ /* order to remove a particular packet from a subqueue.*/ /* the subqueue is specified by the event code and the */ /* packet address is given by the 'state_ptr' arg. */ subq_index = code; pk = (Packet*) state_ptr; /* Find the packet in the subqueue, remove, destroy it. */ subq_size = op_subq_stat (subq_index, OPC_STAT_PKSIZE); for (i = 0; i < subq_size; i++) { if (op_subq_access (subq_index, i) == pk) { op_subq_pk_remove (subq_index, i); op_pk_destroy (pkptr); break; } } } -
Multicast – 这些事件被提供给整个系统模型中的所有处理器和队列。它们通常用于支持同步操作,例如建模贯穿整个系统的状态完全重置;或者划分仿真中的“时期(epoch)”,即对象必须先重新配置,仿真才能继续。该中断的应用由用户定义,并支持使用 ICI 和事件码。图 78 展示了响应 multicast 事件的一种可能的 Proto‑C 规格。
图 78:处理“Multicast”类型事件的典型做法
/* A multicast event has occurred; examine the code to */ /* determine what behavior is expected. */ event_code = op_intrpt_code (); if (event_code == GLOBAL_RESET) { /* this event represents a globalized resetting */ /* of all state throughout the system. This process */ /* need only reset its private state memory. */ /* eliminate packets in all the subqueues. */ op_q_flush (); /* reset the state variables kept for estimating */ /* timer values. */ total_packets = 0; total_delay = 0.0; round_trip_time = INTITAL_RTT; } -
Process – 大多数事件类型是针对模块整体的,但 process 事件旨在调用处理器或队列上下文内的某个特定进程。process 事件常常由同一处理器或队列内的一个进程为另一个进程调度(例如其父进程或子进程)。这可以看作一种延迟调用,为进程之间常用的立即调用提供了另一种选择。process 中断使用与 self 中断相同的事件属性;响应“process”事件的 Proto‑C 代码示例出现在图 79 中。
图 79:处理“Process”类型事件的典型做法
/* A process event has occurred and has caused */
/* this process to be invoked. */

/* Determine the reason for invocation, which is provided */
/* as the event code. */
invoke_code = op_intrpt_code ();

/* At this point, this process can be invoked for */
/* two reasons: to begin transmissions or to reset */
/* the connection that it manages. */
if (invoke_code == XMIT_START)
	send_packets ();
else reset_connection ();
中断
除了事件之外,Modeler 还定义了与之相关的中断(interrupt)概念。事件可以看作在特定时刻发生活动的请求。相比之下,中断被定义为事件被仿真内核执行所实际产生的调用。换句话说,事件表中的事件只有在被投递到其目标模块时才成为中断。中断实际上从不驻留在事件表中。
中断属性
中断与产生它们的事件具有相同的属性。特别地,中断类型使用相同的名称(stream、statistic、self 等)。由于中断是正在执行的事件的具体表现,因此可以通过获取当前事件的句柄并应用 Ev 包的 KP(例如 op_ev_code()、op_ev_ici() 和 op_ev_src_id())来访问其属性。然而,由于这些操作在当前事件方面十分常见(也就是说,进程需要关于其当前调用的信息,通常比需要关于未来事件的信息更频繁),Intrpt 包中有若干 KP 隐式地作用于当前事件。下表汇总提供中断属性访问的 KP;有关这些 KP 的更多信息,参见第 11 章“Interrupt Package”第 1 页。
表 39:访问中断属性的内核过程
| 内核过程 | 属性 |
|---|---|
| op_intrpt_type() | Type |
| op_intrpt_code() | Code |
| op_intrpt_strm() | 数据包到达的输入流 |
| op_intrpt_stat() | 输入统计量 |
| op_intrpt_source() | 源对象 ID |
| op_intrpt_ici() | ICI(接口控制信息) |
关键概念——当事件到达事件表中最早的位置并被执行时,就产生了一个中断。该中断被投递给事件的目标对象,并具有与该事件大部分相同的属性。
中断抑制
某些事件可以被执行而仍然不产生中断。这可能由若干抑制机制导致,这些机制在事件执行时作用于某些事件。
最常见的中断抑制形式是由进程建立的,用于在某个特定区间内或无限期内限制不需要的事件中断到达。进程可以通过按需调用内核过程 op_intrpt_disable() 来实现这一点,以影响中断的各种组合。每次调用都指定一种中断类型,并可选择性地结合一个中断码。
调用 op_intrpt_disable() 的效果在多次调用之间是累积的,这意味着若干连续调用可用于禁用多种类型的中断。在概念上,可以把进程看作按进程(而不是按处理器或队列)维护一个“中断过滤器”列表。每个中断过滤器只要存在,就会阻止特定的中断类型和中断码到达该进程,如下一图所示。
图 80:按进程进行的中断抑制
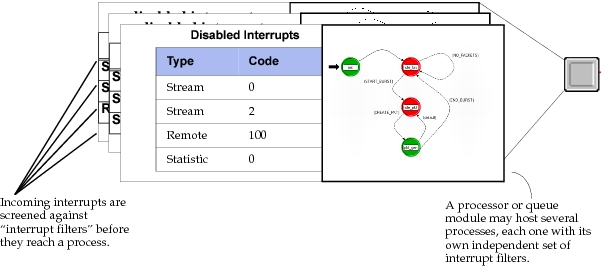
通常,中断禁用机制用于进程进入某个阶段、由于某种繁忙状态而无法处理某些中断的时候。例如,由处理器实现的传输管理子系统可能一次无法处理多个传输请求;它不必中断自己对某个数据包传输的处理去应对新的异步数据包到达,而是可以简单地禁用所有 stream 中断,直到它完成当前正在处理的那个传输为止。当当前传输完成时,在此期间到达但未能引发中断的数据包将被排入该处理器的输入流中。
大多数被禁用的中断不会自动排队以提供其曾发生的指示。引发 stream 中断的数据包在被禁用期间确实会排队,因为每个数据包都包含唯一的信息,通常希望数据包序列中不要出现“缺口”。另一方面,由于 statistic 中断、remote 中断或其他类型被抑制而丢失的信息,无法由曾禁用它们的进程恢复。
中断禁用的效果可以通过若干机制逆转。一种常见的逆转方式内建于禁用请求本身;对 op_intrpt_disable() 的调用支持指定一个名为 next 的参数,它使该中断抑制仅对中断的一次出现有效;以这种方式指定的中断控制,在其起到阻止一次中断投递的作用之后会被立即移除。当在一段时间内、或在某个逻辑条件达成之前抑制中断时,进程通常通过内核过程 op_intrpt_enable() 或 op_intrpt_enable_all() 重新启用中断。前者用于启用特定的中断类型与中断码组合,后者则移除该进程的所有中断控制(即该 KP 使进程回到不抑制任何中断的默认状态)。有关这些 KP 的适用性与用法的更多信息,参见“Interrupt Package”第 1 页。
关键概念——当进程知道某些事件可以被安全忽略时,它可以阻止这些事件作为中断投递给自己。这样做是为了简化进程模型并提高仿真速度。可以使用 Intrpt 包的 KP,基于某些属性禁用和重新启用中断。
涉及延迟的建模动作
无论建模的目标是度量性能还是分析行为,准确建模与关键动作相关的延迟往往对于获得有代表性的结果十分重要。常见的性能指标,例如资源利用率(例如链路或处理器的利用率)以及消息的端到端延迟,在很大程度上是消息、事务或作业所承受的各种延迟的函数,具体取决于应用。此外,队列长度和吞吐量等指标也间接依赖于处理延迟,因为在系统中特定位置产生的延迟可能形成“瓶颈”。系统的行为同样与延迟相关联,因为各组件之间通信的时序可能关键地影响动作执行的顺序,甚至影响执行哪些动作。例如,流控与错误恢复子系统所期望的确认(acknowledgment)的延迟,可能导致异常高的重传次数,或者根据其具体设计使系统进入死锁状态。实际观察到的行为总是取决于各个子系统如何定义,而子系统之间的交互常常受到通信或处理延迟的影响。
Modeler 支持在系统模型中纳入延迟的技术。各种方法的适用性在很大程度上取决于延迟所关联的动作类型,以及该延迟发生在系统中的哪个位置。下面列出一些通常需要延迟建模的动作示例:
- 完成任务或子任务所需的计算 – 要实现决策子系统,通常需要进行多种类型的计算;应当分析实际子系统(而不是被建模的子系统)中所要求的计算,以确定它们所需的延迟。如果这些时间间隔是显著的,开发者应考虑将其纳入模型。在网络协议建模中,一些典型的需要延迟的任务包括:评估所接收数据的完整性(即校验和计算);对发送/接收数据进行压缩/解压缩;在给定某些通用数据和“头部”信息(例如目的地地址、服务类别等)的情况下构造数据包;对正确接收的数据包进行解码和分路。对于通用系统建模,任务在很大程度上取决于应用,其范围可能非常广泛,从执行信号处理算法,到解释遥测数据,或刷新雷达显示。
- 两个组件之间的传输与传播 – 取决于组件之间的物理关系,或者它们通信所采用的机制,延迟可能是它们交互中的一个重要因素。在某些情况下,两个组件之间的通信可能不依赖物理连接,而是以抽象形式实现,例如在软件程序中执行一次过程调用。两个通过某种信道物理相连的组件之间的通信延迟,通常可以归因于传播延迟和传输延迟;前者是信息在两个组件之间传播所需的时间,后者是把信息插入通信信道所需的时间。在某些情况下,可以忽略其中之一,或两者都忽略。对于更抽象的通信形式,延迟可以表示信息传输机制本身的固有限制;就过程调用而言,主要的延迟可能来自设置参数以及把控制转移到程序中另一位置所需的 CPU 指令执行,以及可能从磁盘加载新的程序指令(即程序段的换入)。
- 从存储设备读取/写入信息 – 大多数系统都维护状态信息,或是作为其主要功能,或是为其他活动提供支持。某些事件会引起该信息的变化,或使用该信息,或两者兼有。所关注的信息可以维护在一个或多个设备中,取决于系统的存储体系结构;这些设备通常是通用半导体存储器、缓存或显示内存、微处理器寄存器、磁碟或光盘、磁带,或者在更抽象的意义上,甚至是通过网络访问的远程数据库。取决于使用哪些设备以及访问的数据量,读和写操作可能为其支持的操作引入显著延迟。
- 需要重新配置的、对重大事件的响应 – 某些事件可能要求子系统重新配置,以适应改变了的运行环境。这种情形在研究系统对一个或多个组件失效时鲁棒性的建模工作中常常出现。关键组件的失效可能触发大量活动,例如重新计算路由以绕过丢失的资源,甚至完全初始化其他组件的状态。此类组件的恢复也可能触发类似的活动,因为系统试图最大化其对可用资源的利用。由于鲁棒性研究常常把“确定适应重大系统变更所需时间”作为目标之一,每个相关动作中所遇到的延迟可能是系统模型的重要方面。
上面的示例只是说明了为开发能够可靠预测系统性能与行为的准确仿真而必须建模某些延迟;当然,还有许多其他情形,其中被建模的活动需要纳入延迟效应。不过这些示例确实支持了关于建模延迟的若干重要观点:
- 并非所有延迟都需要建模 – 某些延迟相对于其他延迟而言微不足道。然而这些延迟可能需要与那些切实影响系统性能或行为的延迟同样多的建模工作量。例如,获取诸如协议的重传尝试次数之类的信息,可能只涉及一次简单的内存寄存器访问,因此只产生极小的延迟;另一方面,执行一次地址映射可能依赖于从磁盘读取文件,这需要大得多的延迟。因此,建模地址映射操作的延迟而不是变量访问的延迟,可能是明智的;避免为极快操作的延迟建模所带来的额外复杂度,对模型整体准确性的影响可能可以忽略。当一个慢操作和一个快操作同时发生,或者较慢的操作出现频率更高时,尤其如此。不过值得注意,即使是非常快的操作,如果发生得非常频繁,也可能产生明显的累积效应。
- 延迟值可能难以获得 – 许多延迟在模型开发时并不精确已知。在某些情况下,所要求的延迟值是超出被建模系统范围的复杂交互的结果。例如,磁盘访问延迟可能是由甚至不属于系统模型的组件对计算机总线的争用造成的;或者磁盘本身可能因代表其他进程而繁忙。这种可变延迟可以被建模为随机变量,但那就必须指定概率分布。获得所需延迟值的一种可能方法,是在实际组件存在时对其进行基准测试,或从组件制造商处获取估计值。如果组件是假设性的,建模者只需提供有依据的延迟估计,或者把它们当作系统参数,用作参数化评估的基础(也就是说,当考虑不同的延迟值时,对系统性能有何影响?)。在所有情况下都应注意,Modeler 对被建模的组件没有任何先验知识,因此它不了解正确的延迟值;它也不了解哪些动作与显著延迟相关,哪些代表可忽略的延迟。提供这些基本值是模型开发者的责任;相应地,仿真的作用是模拟所指定的延迟,从而在具有正确聚合延迟以及其他现象的情况下,隐含地产生具有代表性的行为与性能。
- 实际系统的某些动作可能仅以其延迟来建模 – 在许多情况下,实际系统的操作不会被完全详细地建模,原因或是为了简化,或是因为它们不会影响仿真的运行。例如,数据链路层协议接收到数据包时,其第一步可能是通过校验和计算来验证数据完整性;随后协议可能继续获取数据包中各个字段的值以完成其数据链路功能。对该协议的典型模型不会执行校验和计算,因为该计算的机制与模型对实际协议行为的模拟并无直接关系。然而,校验和操作中可能影响模型准确性的方面,是该计算所需的时间,以及可能的结果(即判定数据是有效还是损坏)。因此,有时即使某些操作没有出于任何其他建模目的而被显式表示,纳入其延迟效应仍然很重要。如前所述,这一原则的反面同样成立——即某些在机制或行为层面被显式建模的操作,未必需要就其引入的延迟进行建模。特别地,请注意,纯粹属于仿真产物的操作,例如为报告目的计算统计量,通常应当建模为零延迟。
关键概念——建模者必须决定系统的哪些动作应当建模。一般而言,那些以可度量的方式影响所需系统统计量的延迟应当予以考虑。在某些情况下,延迟可能是系统动作中唯一实际被建模的方面;同样,某些动作可以被建模为没有延迟。
表示延迟的技术
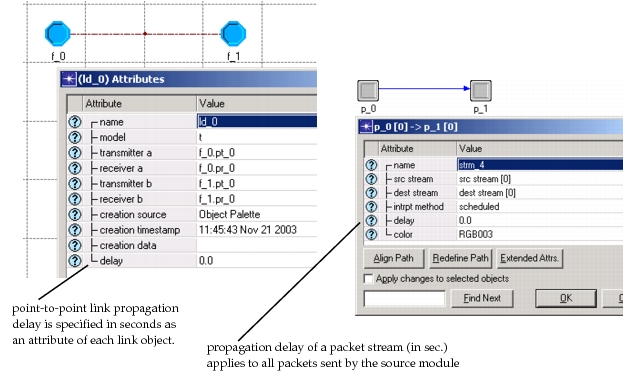
模型中最简单的延迟类型,与通过网络中节点之间的链路、或在节点内模块之间的连接传输信息相关联。这些情形中遇到的延迟类型是传播延迟和传输延迟。在几乎所有模型中,两种延迟都通过相应链路或连接对象的属性来设置。对于链路模型,实际延迟值由底层链路模型(称为收发器流水线阶段)根据链路属性计算得出。有关链路模型的更多信息,参见第 9 章“Communication Mechanisms”第 331 页。
图 81:作为链路和连接属性指定的传播延迟
本节集中讨论进程模型所执行操作中固有的延迟,因为这些通常需要更精心的实现。这些延迟可以通过多种技术实现。建模有限时间操作的关键困难在于,没有任何单个事件可以占据大于零的仿真时间跨度。因此,需要多个事件来表示这样的操作。表示有限时间操作有两种通用的事件调度形式。第一种形式称为外部延迟建模(external delay modeling),把延迟动作的负担放在内核上;第二种形式称为内部延迟建模(internal delay modeling),依赖执行该动作的组件同时管理时序和执行。两种技术都使用两个事件来实现一个有限时间操作;一个事件开始该操作,第二个事件标记其完成。
外部延迟建模为模型开发者提供最简单的接口。它适用于以下情形:在动作开始时,指定该动作所需的全部信息都已可用,并且执行该动作的组件不需要关于该动作已完成的任何通知。换句话说,完成该动作的影响完全处于执行它的组件之外。外部延迟建模的一个常见示例是使用内核过程 op_pk_send_delayed() 通过数据包流把数据包发送出某个模块。该过程允许指定一个延迟时间,仿真内核在此期间持有该数据包然后再转发它。所指定的延迟可以用于表示与发送数据包相关的处理时间或传输时间。从目标模块的角度看,所有延迟都被正确建模,因为数据包在正确的时刻到达。下面的图示展示了为固定处理延迟进行外部延迟建模的数据包发送/接收时序。
图 82:外部延迟建模:把处理时间纳入数据包转发
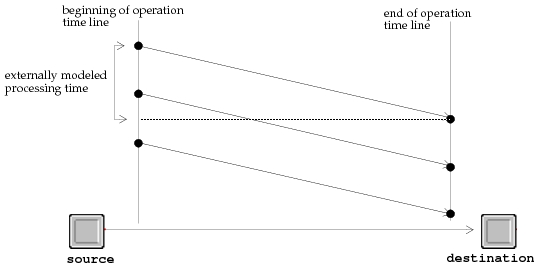
前面的示例突出了外部延迟建模的一个潜在陷阱。请注意,处理时间大于相邻两次发送之间的间隔时间。如果源处理器能够同时处理两个数据包,那么这种建模是正确的;然而,如果该处理器一次只能管理一个数据包的处理和发送,那么该模型就不准确,因为它允许第二个数据包的处理和发送在第一个数据包的处理结束之前开始。图中的水平线与斜线交叉处正突出了这一错误。
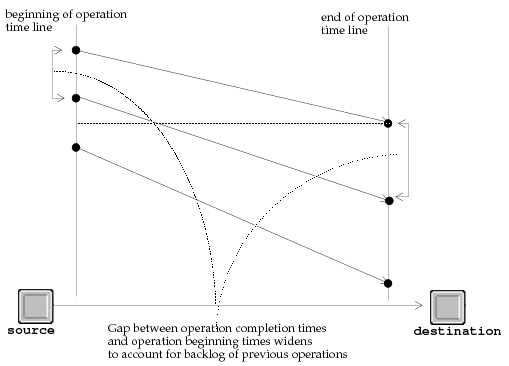
针对外部延迟建模技术所带来的同时处理问题,一种可能的解决方案是在执行该动作的组件内部考虑积压的处理时间。为了纠正上面示例中的错误,名为“source”的处理器将在转发第二个数据包时纳入额外延迟,以考虑该数据包在第一个数据包处理完成期间本应等待的时间。请注意,这甚至进一步增加了第三个数据包必须被延迟的时间时长。在仍使用外部延迟建模的前提下,正确实现该系统的最佳方式是在源进程中使用一个变量来表示下一次可用的处理和发送时刻,并在每次发送发生时调整该变量。可用于实现该技术的 Proto‑C 片段以及由此产生的数据包发送/接收时序如下所示。
图 83:使用单线程处理的外部延迟建模示例实现
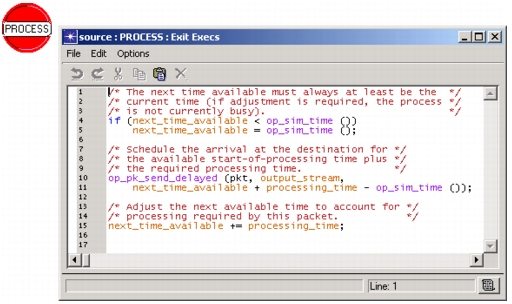
图 84:使用单线程处理的外部延迟建模的起始/结束时间线
关于外部延迟建模的最后一点说明:下表列出了支持该技术、与 op_pk_send_delayed() 类似的内核过程。
表 40:支持外部延迟建模的内核过程
- op_pk_deliver_delayed()
- op_pk_send_delayed()
- op_intrpt_schedule_remote()
- op_intrpt_schedule_call()
- op_intrpt_schedule_process()
内部延迟建模是处理延迟的一种自然实现,因为它完全在操作本身发生的位置进行。该技术包括记录反映某个操作已经开始的状态信息,并同时启动一个机制,在操作结束时中断该进程。如果在操作开始时其持续时间已知,那么该机制通常是通过内核过程 op_intrpt_schedule_self() 调度的 self 中断。所记录的状态信息通常用于防止对处理资源的重复使用,和/或在稍后收到中断时完成该操作。在许多情况下,会使用某种“busy”变量来说明进程已经忙于完成某项任务这一事实。
当所关注的延迟与不导致与其他模块之间某种通信的本地操作相关联时,内部延迟建模是唯一推荐的方法。它是一种常用的技术,因为许多处理延迟都与完全本地的操作相关联。例如,处理器可能接收到一个包含路由拓扑更新的数据包,并需要一定的处理时间来重新配置其路由表;或者队列可能收到一条清空其内容的命令,并在该操作完成之前阻止后续动作。下面的 Proto‑C 模型片段展示了为此类队列实现内部延迟建模的做法。在这种情况下,该进程在清空操作完成之前不会离开 FLUSH 状态;在此期间发生的所有中断都被忽略,因此不需要特殊的状态变量来记录进程正忙于执行此操作这一事实。条件 FLUSH_OPERATION_COMPLETE 指定中断类型和中断码都必须对应该进程早前在 FLUSH 状态中请求的 self 中断,才允许进程返回 IDLE 状态。
图 85:为简单进程实现内部延迟建模
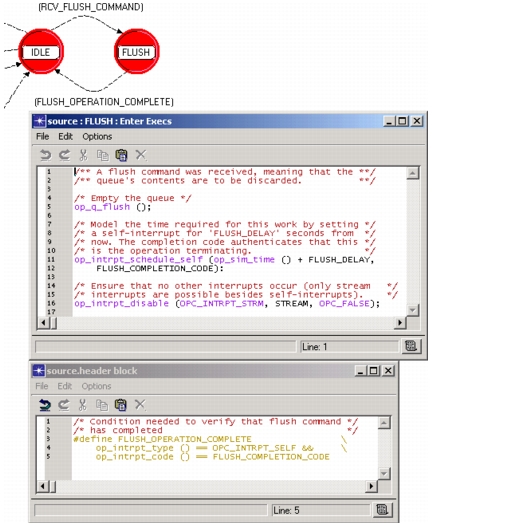
请注意,内部延迟建模还存在一种通常等价的形式,即所建模延迟的那个操作是在等待期结束时(而不是像上面的示例那样在开始时)执行。这一区别在某些情况下可能很重要,例如该操作导致系统状态改变、而该改变的时序对模型行为有关(例如该操作涉及销毁一个内容在完成之前仍可能被访问的数据包)。
除了用于本地操作之外,在满足下列任一条件时也会使用内部延迟建模:
- 执行该操作的进程在开始该操作时并不知道延迟区间 – 这种信息的缺失使进程无法向仿真内核指定该操作应在何时完成,而这是外部延迟建模所必需的。这类情形通常出现在进程依赖外部产生的条件来完成本地操作时(例如,一个表示外部资源可用的 statistic 中断)。
- 进程支持任何会在操作中途改变延迟时间的抢占类型 – 例如,考虑一个队列,其任务是按优先级顺序转发数据包,并且可以暂停对某个数据包的服务以给予更高优先级的数据包优先权;该队列的算法若使用外部延迟技术、并在其服务间隔完成之前的任何时刻转发数据包,都将是不正确的,因为预期的延迟可能由于随后收到更高优先级的数据包而改变。
- 该操作可能影响尚不可用的状态信息,或依赖于可能改变的状态信息 – 例如,一个接收命令、处理命令并基于命令内容发出消息的进程,通常可能使用外部延迟建模来表示这些命令的处理时间;然而,如果此外该进程还可能被管理进程以修改处理时间的方式异步重新配置,那么外部延迟建模技术就会失效,因为它会把操作安排在错误的时刻完成(这些时刻在进程未被重新配置时本来是有效的)。
如果在某个建模问题中,内部延迟建模和外部延迟建模都适用,那么模型开发者应考虑以下事实来决定实现方式:(1) 外部延迟建模为开发者提供更简单的接口,允许在一处完全指定延迟,而内部延迟建模可能需要进程模型的多个状态都了解该操作的完成事件;(2) 与内部延迟建模相比,外部延迟建模每个完成的操作少产生一个事件,这可能带来仿真性能的提升;(3) 外部延迟建模可能导致事件表中同时表示大量操作,在极端情况下可能造成仿真性能损失;(4) 内部延迟建模总是可行的,因此比外部延迟建模更具可扩展性,因为延迟计算方式的改变不太可能导致实现上的重大改变。
关键概念——建模与动作相关的延迟使用两种通用技术:内部延迟建模和外部延迟建模。外部延迟建模把动作的结果安排在延迟结束之后发生。内部延迟建模调度一个事件来标记延迟的结束,并在该事件期间实现动作的结果,这可能需要一个额外的事件。
事件取消
仿真内核提供了若干接口,支持进程为自己或其他进程调度未来活动。给定活动中值得关注的离散时点,由事件被调度所产生的中断来表示。可以把状态信息与中断关联,从而当它们实际发生时,可以取回这些信息以彼此区分。中断被调度用于建模许多系统特性,包括处理延迟、定时器到期、传播与传输延迟、资源可用性、资源轮询、流量生成等。本节前面的部分为这些类型的应用及其可能的实现方式提供了更多背景。
所有事件调度接口都由仿真内核以内核过程(KP)的形式提供。许多这样的过程返回一种称为事件句柄(event handle)的特殊值。事件句柄(也称为 Evhandle,因为这是它们用于声明的数据类型)实际上是一种数据结构,其目的是保留对所请求事件的访问。下面列出把事件句柄作为返回值提供的 KP。
表 41:调度事件并返回事件句柄的内核过程
- op_intrpt_schedule_call()
- op_intrpt_schedule_mcast_global()
- op_intrpt_schedule_process()
- op_intrpt_schedule_remote()
- op_intrpt_schedule_self()
- op_pk_deliver()
- op_pk_deliver_delayed()
- op_pk_send()
- op_pk_send_delayed()
仿真内核提供了整个一个称为 Ev 的 KP 包,它们作用于事件句柄。其中许多 KP 关注于确定事件的属性,或利用一个事件在事件表中查找其他事件。然而,事件句柄的主要用途是取消已调度的事件,使用内核过程 op_ev_cancel()。
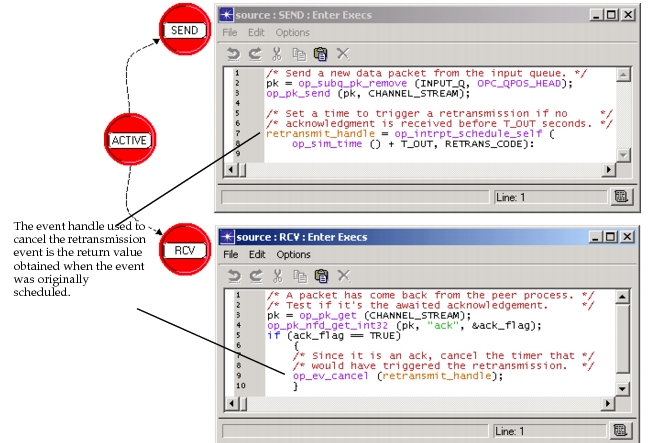
已调度的事件可以在其执行之前的任何时刻被取消。甚至在事件发生时刻与所关注事件所调度时刻相同的先前事件执行期间,取消也是可行的。事件被取消的原因因应用而异。取消事件的普遍原因是某个预期动作不再需要,或者会效率低下。op_ev_cancel() 最常见的用途是撤销那些标记定时器到期的事件;这些事件通常通过内核过程 op_intrpt_schedule_self() 调度。下面的 Proto‑C 模型展示了该技术在一个典型场景中的应用,其中定时器用于在对等进程的确认缺失时触发数据包的重传。
图 86:取消表示重传定时器的事件
注意: 当“stream”类型的事件被取消时,相关的数据包由仿真内核自动销毁。
关键概念——当事件被调度时,可以获得一个事件句柄。如果保留该事件句柄,随后可以用内核过程 op_ev_cancel() 取消该事件。某些 Ev 包的 KP 也提供了获取事件句柄的其他方式。事件可以在其执行之前的任何时刻被取消。
中断方法
关于中断投递到进程的时序,仿真内核提供了若干选项。这些选项或者通过用于调度相关事件的 KP 来控制,或者通过用于促成该中断的对象的属性来控制。事件的两大类别称为 scheduled(调度)和 forced(强制)。
scheduled 事件是最常用的形式,也是本节大多数示例的基础。顾名思义,scheduled 事件依赖一种事件调度机制:它们被插入事件表,并按其指定的仿真时间顺序被取出。如前所述,正在执行的事件可以为完全相同的仿真时间(即当前时间)调度事件。然而,这些事件在当前事件完成之前不会被考虑执行;它们只是被插入事件表,而当当前事件完成其全部动作后,同一时刻已调度的事件中优先级最高者得到服务。
forced 事件通过立即中断目标模块,提供了对事件调度所固有的执行推迟的一种替代。当产生中断的一方必须在继续其执行之前从中断目标处获得某种结果或服务时,这种行为十分有用。这种交互的一个常见示例用于支持从所谓被动队列(passive queue)模型中提取数据包。被动队列等待被外部产生的中断访问之后才转发数据包;它接受上游邻居发送给它的数据包并入队,但从不自主地向下游邻居转发数据包。外部产生的中断通常是下游进程调用内核过程 op_strm_access() 所产生的 access 中断。该 KP 为队列中的一个进程产生强制中断,该进程按其自身的内部规则转发一个数据包。调用 op_strm_access() 以获取数据包的下游进程,在队列的进程释放执行控制之前被阻塞执行(在 Proto‑C 模型中,这是通过进程进入一个 unforced 状态并完成该状态的 enter 执行体部分来实现的)。然而,在它恢复执行之后,下游进程可以预期队列已经响应了它的请求,并可能已经转发了一或多个数据包。取决于具体系统,它可能检查其输入中是否存在数据包,而不是简单地假定已经提供了一个。下图展示了被动队列的配置,以及由 access 中断的强制性所产生的执行序列。
图 87:使用强制 access 中断从队列中访问数据包
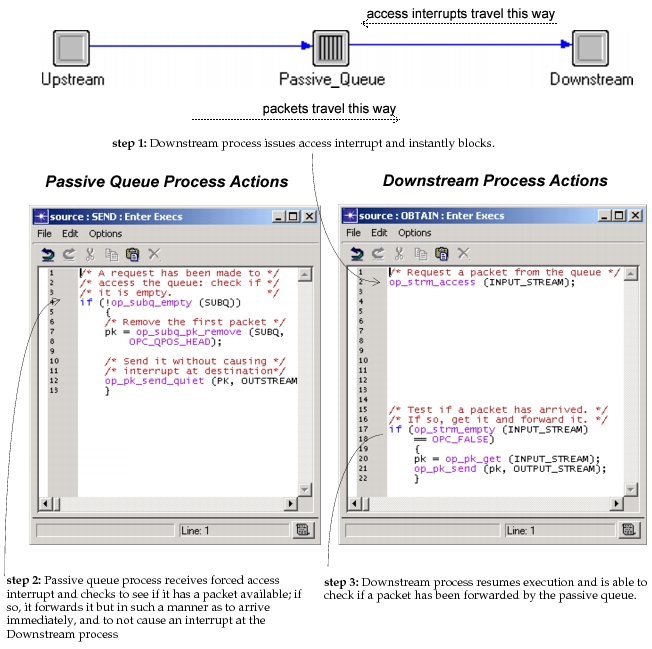
如图 87 所示,发出强制中断会使发出它的进程被暂时挂起,以便仿真内核可以开始执行接收该中断的进程。在强制进程的工作完成之后,被挂起的进程可以在发起该动作的语句之后的那条语句处恢复执行。换句话说,从产生强制中断的进程的角度看,整个事件以及它引起的所有外部动作都被包含在一次 KP 调用之中(在本例中是 op_strm_access())。
关键概念——可以提交执行的事件有两种类型。scheduled 事件可以在任何未来时刻执行,包括当前时刻。仿真内核基于时间和优先级决定何时执行它们。forced 事件立即发生,即使当前时刻还有其他事件待处理。
此外,图 87 还说明了由内核过程 op_pk_send_quiet() 实现、并由响应强制中断的进程使用的另一种事件机制。由于被动队列进程是在下游进程被挂起期间被调用的,而下游进程会期望在 op_strm_access() 调用一返回就有数据包存在,因此数据包必须以立即的方式转发。换句话说,使用事件调度机制(例如 op_pk_send())来转发数据包并无用处,因为数据包的投递会被推迟到两个事件都完成之后的某个时刻,因而不会出现在下游进程的输入流中。另外,仿真内核不支持把强制中断应用于已经因发出强制中断而被挂起的进程;这种交互可能在持续执行反馈回路以及单个进程的多线程执行方面造成问题。因此,必须在不为被挂起的下游进程产生中断的情况下转发该数据包。立即执行与不产生中断这两项特性的结合,由称为 quiet(静默)的事件类别提供。目前仿真内核只提供两个产生 quiet 事件的 KP:op_pk_send_quiet() 和 op_pk_deliver_quiet()。
在大多数情况下,中断方法是通过使用某个特定的 KP 来选择的;然而,连接节点域内模块的数据包流和统计量线支持把中断方法指定为其属性之一。对于 statistic 事件,中断方法始终由相关统计量线的“intrpt method”属性指定。对于 stream 事件,由某个特定 KP 选择的中断方法会覆盖分配给相关数据包流的任何属性;不过,当源模块不是队列或处理器时(即源模块是一个接收机),可以使用数据包流的“intrpt method”属性来控制中断方法。
请注意,并非所有事件类型都支持每种中断方法。下表列出每种事件类型所支持的方法。请注意,任何为未来时刻指定的事件(即相对于当前时间延迟超过零秒的事件)必然是 scheduled 事件。forced 和 quiet 方法只能用于打算立即执行的事件。
表 42:各事件类型对中断方法的支持
| 事件类型 | Scheduled | Forced | Quiet |
|---|---|---|---|
| self | ✓ | ||
| stream | ✓ | ✓ | ✓ |
| statistic | ✓ | ✓ | |
| regular | ✓ | ||
| failure | ✓ | ||
| recovery | ✓ | ||
| begin simulation | ✓ | ||
| end simulation | ✓ | ||
| access | ✓ | ||
| remote | ✓ | ✓ | |
| procedure call | ✓ | ||
| multicast | ✓ | ||
| process | ✓ | ||
| esys interface | ✓ |
关键概念——第三种类型的事件称为 Quiet,它与 forced 事件相似,因为它是立即执行的。然而,它在执行时不会为目标对象产生中断。forced 事件只是把数据投递给目标对象。这些数据稍后在该对象收到 scheduled 或 forced 事件时才被处理。
中断引导
处理器和队列模块是允许建模者实现自定义行为的节点域元素。每个处理器或队列都可以执行多个进程,这些进程根据其对应的进程模型响应中断。最初,每个模块只执行一个进程,称为根进程(root process),其类型由该模块的“process model”属性指定。然而,由于进程可以创建(和销毁)在同一模块内执行的其他进程,模块中实际进程的数量可能随时间变化。
当被中断时,一个进程可以选择调用任何其他进程来完成该中断所要求的部分或全部动作。因此,一种可能的策略是让所有中断都到达一个充当调度者的进程;该管理进程根据中断的属性调用正确的进程。不过,通常直接调用将执行与中断相关的主要动作的那个进程,更方便、更高效也更简单。
默认情况下,到达队列或处理器模块的所有中断都被导向根进程,self 中断和 process 中断除外,它们总是针对特定进程;self 中断总是返回到调度它们的进程,而 process 中断在其规格中包含一个目标进程。然而,仿真内核提供了两种机制,把中断引导向根进程以外的进程。这两种机制必须由模块的进程动态激活,因为它们提供的唯一接口依赖内核过程;换句话说,当仿真开始时,默认条件总是占主导,这意味着根进程是所有中断的隐式接收者。所提供的机制称为中断类型注册(interrupt type registration)和中断端口注册(interrupt port registration)。注册一词指的是进程自身告知仿真内核其模块的中断应如何被引导。两种中断引导机制都根据中断的某些属性在模块内的进程之中选择一个进程。当两者的属性发生重叠时,中断端口注册具有更高的优先级。
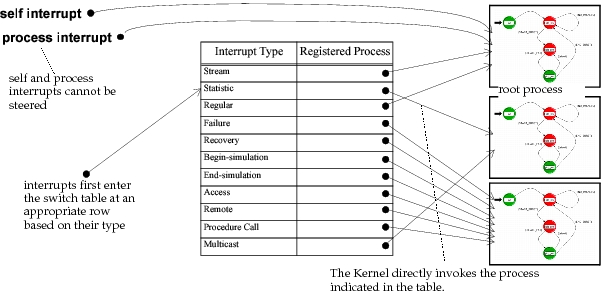
中断类型注册只考虑中断的类型来选择进程。一个进程可以把自己或另一个进程注册为到达相关模块的某种特定类型中断的接收者。用于完成此注册的内核过程是 op_intrpt_type_register(),它在“Interrupt Package”第 1 页中有完整说明。类型注册机制可以被看作一组开关,中断在首次到达模块时进入这组开关;开关分析中断的类型,并在模块内选择一个进程来接收第一次调用。最初,所有开关都指向该模块的根进程,但通过正确的 sub-object 调用可以重新配置这些开关。中断类型注册机制的这一视图见下图。
图 88:中断类型注册机制
中断端口注册只能影响 stream 中断和 statistic 中断。对这两种类型而言,引导不仅基于类型,还基于到达端口。对于 stream 中断,中断的端口就是数据包到达所在的输入流;对于 statistic 中断,端口就是连接到活动统计量线的输入统计量。两种情况下,端口都是一个正整数索引。中断端口注册通过调用内核过程 sub-object 完成。有关该过程的更多信息,参见第 11 章“Interrupt Package”第 1 页。
中断端口注册的应用,是基于对若干不同物理到达之意义的先验知识,把它们分开处理。例如,如果已知来自较高层应用的数据包到达在输入流编号 0,而来自物理信道的数据包到达在输入流编号 1,那么可以为每一类创建一个单独的进程来处理,而不是创建一个能够异步处理两种中断来源的进程。这一技术可以大幅简化进程模型的设计。
关键概念——由于一个模块内可以存在多个进程,仿真内核必须决定该模块的每个事件应投递给哪个进程。默认情况下根进程接收所有事件。然而,特定进程可以基于事件类型、并在某些情况下基于事件端口(即输入流或统计量)请求直接接收特定事件。
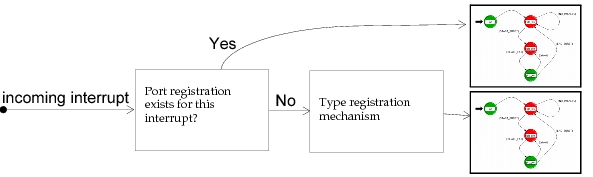
由于端口注册适用于 stream 和 statistic 中断,而类型注册也可以适用于这些中断,仿真内核必须在两种机制之间确定优先级。端口注册机制更具体,因为同一类型的不同中断可能受到不同的影响;因此,通过允许端口注册覆盖类型注册,内核可以支持两种机制的组合使用。换句话说,stream 和 statistic 中断总体上可能由于类型注册机制而被引导向某个特定进程,而这两类中的特定中断可能被以不同方式引导。下图展示了同时使用类型注册和端口注册时内核的选择机制。
图 89:基于端口注册的引导具有优先权
中断类型注册的效果很容易通过重新注册模块的根进程来撤销,因为最初根进程已为所有中断类型注册。然而,在 op_intrpt_type_register() 已被使用之后,需要一个专门的 KP,即 op_intrpt_port_deregister(),才能恢复先前的状态,因为仅仅为某个特定的中断类型和端口安装根进程,可能会覆盖同时存在的类型注册。有关这些 KP 的说明,请参见第 11 章“Interrupt Package”第 1 页,以了解如何撤销中断引导机制的效果。
中断引导是一项强大的技术,可用于实现处理大量不同类型、到达不同端口的中断的复杂进程。有效使用本节所描述的两种机制,可以使建模者把一个进程的功能分解为一组更小的进程,每个进程都更容易表示。有关中断引导应用的更多信息,参见第 5 章“Process Domain”第 165 页。
用于同时执行事件的优先级排序
如本节前面所述,仿真内核的事件管理策略支持在相同仿真时间执行多个事件。同时事件调度可能由若干现象导致:
- 模型可能包含同步运行的组件 – 同一节点内或不同节点中的不同组件,可以由于贯穿整个系统的规则时序而并发地执行活动。这在数字硬件系统中很常见,其中许多组件由同一时钟驱动。许多通信系统以类似方式运行,使用预先指定的时隙时间来发送和接收消息。
- 不相关的事件可能以不规则的方式重合 – 发生在不同节点、甚至同一模块处的事件,可以被调度在同一时刻,即使这些事件由彼此独立的不同来源发出。当仿真中只使用少量时间增量时(即固定的发送时间、传播延迟、到达间隔时间、定时器间隔等),这种情况很常见,因为这些增量的不同组合很可能累加出相同的新事件仿真时间。
- 事件期间采取的动作可以在同一仿真时间产生新事件 – 这经常发生,因为通信或调用机制被理想化为不需要时间即可完成。例如,通过延迟等于零的数据包流发送的数据包,将在接收模块处产生一个新事件,其时刻与发送该数据包时所在的事件完全相同。请注意,由于这种类型的同时事件,在某个给定时刻的事件数量在该时刻最后一个事件完成执行之前是无法知道的(即可能引入同一时刻的新事件)。
离散事件仿真通常设计为在串行计算机上执行,因此一次只能实现一个事件。因此,必须通过把仿真时间保持为恒定值直到某个时刻的所有事件都已执行,来模拟同时事件的并发性。在某些情况下,模型的行为可能受到同时事件执行顺序的显著影响。
例如,再次考虑一个发送数据包并期望收到确认作为回应的进程;使用 self 中断设置一个定时器,以表示在某个时段之后需要进行重传。现在考虑确认与定时器在同一仿真时间到期的情形。如果表示定时器到期的 self 中断先被该进程收到,则可能发出一次重传;另一方面,如果与确认数据包相关的 stream 中断先被收到,那么确认将被判定为在所需时限内到达,重传将不会发出。虽然这种类型的行为歧义对某些仿真而言是可以容忍的,但对另一些模型而言,只有一种可能的行为是正确的。此外,模型运行的不可预测性可能妨碍在模型验证或调试期间的仿真跟踪工作。
为了对事件执行顺序提供确定性的控制,仿真内核提供了两种排序机制:对象优先级排序和中断优先级排序。此外,“event_order_method” 偏好允许在严格排序与部分排序之间进行选择。
注意: 对象优先级排序仅用于顺序仿真。并行仿真内核不使用 priority 和 super priority 属性。
对象优先级排序
对象优先级排序对于为发生在相同时间、但发生在不同模块的事件提供确定性的排序十分有用。仿真内核基于分配给每个模块的优先级评级来决定先后。模块的优先级评级取决于两个因素:
- 该模块的“priority”属性(仅队列和处理器)。
- 包含该模块的节点以及直接上层子网对象的优先级(超出直接包含某模块的那一层之外的更高层子网的优先级不予考虑)。
优先级按层次方式评估,较高层对象的属性被赋予更大的重要性。因此,一个模块的“priority”属性值可能高于另一个模块,但如果第二个模块被包含在“priority”属性高于第一个模块所在子网的子网中,那么它的聚合优先级评级反而可能更低。
对这个层次化优先级方案只有一项例外:队列和处理器模块上提供了一个称为“super priority”的布尔属性。“super priority”值为“enabled”的模块,其总体优先级评级总是高于值为“disabled”的模块。比较事件优先级的一般规则列于下表中。记号约定如下:Subnet (X) 是 X 的最直接上层子网(即 X 所在节点的直接父对象);Node (X) 是包含 A 的节点;X.“priority” 是 X 的“priority”属性值。
表 43:模块 A 的优先级评级高于模块 B 的判定条件
- A.super priority = enabled 且 B.super priority = disabled
- Subnet (A).priority > Subnet (B).priority
- Subnet (A).priority = Subnet (B).priority 且
Node (A).priority > Node (B).priority - Subnet (A).priority = Subnet (B).priority 且
Node (A).priority = Node (B).priority 且
A.priority > B.priority
如果事件表中同时存在两个事件,它们被调度在完全相同的仿真时间,并且这两个事件被调度在两个不同的模块,那么为优先级评级更高的模块调度的事件先执行。请注意,两个事件必须同时存在于事件表中,这是一个重要的条件,因为通常无法预见到上面第 3 类同时事件的到来。例如,一个低优先级模块可能先执行,然后为一个更高优先级的模块调度一个无延迟的事件。执行序列会先中断那个低优先级模块,这在跟踪仿真事件的用户看来可能显得矛盾;然而这是正常行为,因为在低优先级事件已经开始执行之后,仿真内核才知道高优先级模块的那个事件。
中断优先级排序
中断优先级用于为发生在相同时间、并且发生在同一进程(而不是同一模块)的事件确立顺序。中断的分类基于分配给中断类型与中断码组合的一个整数优先级值。每个进程都可以通过调用内核过程 op_intrpt_priority_set() 和 op_intrpt_priority_set_next() 来调整自己的优先级(但不能调整其他进程的优先级)。这两个 KP 都允许指定一个中断类型、一个中断码以及一个整数优先级值。数值更大的优先级值对应于所指定中断类型和中断码更高的执行优先权;允许使用负值和正值。所有中断类型与中断码组合的默认优先级值为零。
自然顺序
对于对象优先级和中断优先级两种机制,如果两个事件具有相同的仿真时间和相同的优先级评级,则优先执行最先插入事件表的那个事件。这种事件执行顺序称为自然顺序(natural order)。自然顺序也是默认的顺序策略,在两种优先级机制都未使用时应用。
关键概念——当两个事件被调度在完全相同的仿真时间时,仿真内核必须决定先执行哪一个。在需要时可以使用若干优先级机制来确立先后。对象优先级区分发生在不同对象处的事件。中断优先级区分发生在同一对象处的事件。当优先级相等或未使用时,遵循调度的自然顺序。