理解 Job 属性
Job Properties 对话框(从主菜单选择 Jobs > Properties)显示影响模型行为的各属性的设置和值。
你可以按每个 job 分别选择属性;Server Characterization Editor 会根据设置和分配给该 job 的数据自动计算建议值。你可以覆盖任何属性的建议值。
图 29:Job Properties 对话框
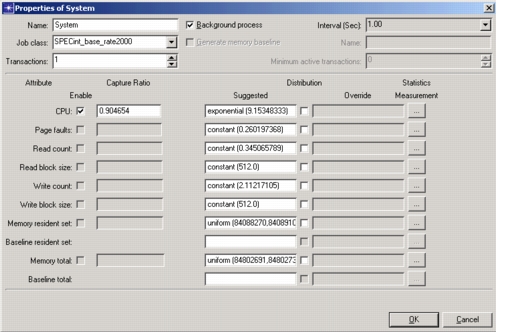
Job 属性
下表列出了 Job Properties 对话框中的属性。
表 8:属性定义
| 属性 | 说明 |
|---|---|
| CPU | 描述该 job 的 CPU 需求的分布 |
| Page Faults | 描述该 job 的页面错误次数的分布 |
| Read Count | 描述该 job 执行的磁盘读操作次数的分布 |
| Read Block Size | 描述该 job 执行的磁盘读操作大小的分布 |
| Write Count | 描述该 job 执行的磁盘写操作次数的分布 |
| Write Count Size | 描述该 job 执行的磁盘写操作大小的分布 |
| Memory Resident Set | job 消耗的物理内存量。这不包括存放在 swap 中的内存。 |
| Baseline Resident Set | (将在未来版本中提供) |
| Memory Total | job 使用的所有内存,包括常驻内存(Resident Set Size)和 swap 内存。 |
| Baseline Total | (将在未来版本中提供) |
有三个可设置的参数会影响 Server Characterization Editor 为这些属性得出建议值的方式。它们是
Background Process
你可以为每个 job 选择两种运行模式之一:
- Normal Process(默认)
- Background Process
如果你不选中 Background Process 复选框,Server Characterization Editor 按每个事务计算工作负载;如果你想评估一个多次执行的 job 的影响,请使用该模式。
如果你选中 Background Process 复选框,Server Characterization Editor 按单位时间计算工作负载。如果你希望工作负载在整个模型执行期间保持一致,请使用该模式。
图 30:Background Process 设置详情
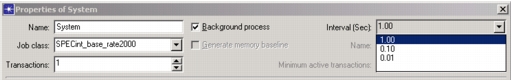
在 Background Process 模式下,Interval (Sec) 输入项变为可用;你可以使用下拉菜单把每个时间间隔从默认的一秒(1.00)改为十分之一秒(0.10)或百分之一秒(0.01)。
图 31:CPU Background Option 对话框
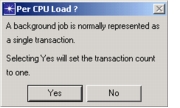
当你选择 Background Process 模式时,会出现 Per CPU Load? 对话框。如果你单击 Yes,Server Characterization Editor 会自动设置 Transaction 数量,使后台处理在你模型中的各 CPU 上平均分配。
Transactions
Transactions 文本框让你可以把服务器上每个 job 的工作负载缩放到正确的每用户值。当你定义一个 job 时,Transactions 的默认数量为 1。
图 32:Transactions 文本框
这意味着全部资源利用率由指定的 job 消耗。然而,如果总利用率基于多个用户的活动,那么每个用户只负责总量的一部分。通过在 Transactions 文本框中输入用户数量,你可以把利用率缩放到每用户值。这会让你的模型得到更准确的结果。
你可以在 Job Properties 对话框中,或在 Server Characterization Editor 的主窗口中为 job 指定 Transactions 数量。Transactions 文本框在这两处都会出现。你可以在文本框中输入数字,或单击文本框旁边的上下箭头来显示你想要的数字。
Capture Ratio
Server Characterization Editor 通过比较全局测量的统计量与每进程/线程的统计量来计算 Capture Ratio。当有全局测量值可用时,用每进程/线程值之和除以全局值。结果通常接近 1.0,但不会大于 1.0。
例如,如果各进程之和为 87%,而 CPU 繁忙程度为 90%,则 capture ratio 为 0.967(0.87 除以 0.90)。当你启用 Capture Ratio 复选框时,Server Characterization Editor 会把 Capture Ratio 的值应用于每个 job,使各统计量之和等于全局测量的值。
由于多种原因,全局统计量与每进程统计量之间可能存在差异;如果数据采集器比较的是不同类的值,往往会产生差异。例如,如果全局测量基于磁盘的物理读取,而每进程测量基于从缓存中提取的读取(因此不需要访问物理磁盘),就可能出现差异。如果数据采集器看不到某些数据,也可能出现差异——例如,某个进程在不到一个采样间隔内创建并结束。
覆盖建议值
你可以通过选中 Override 文本框旁边的 Distribution 复选框来覆盖某个属性的建议值。当 Override Distribution For CPU Utilization 对话框出现时,从下拉菜单中选择新的 Distribution Name。Server Characterization Editor 在对该 job 建模时使用你选择的值。
Note: Server Characterization Editor 为每个属性只导出一个值。如果你覆盖建议值,导出文件中只包含覆盖值。
图 33:Attribute Override 对话框
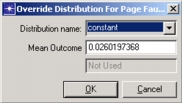
下面的细节显示了该属性输入项的外观。
图 34:示例:Attribute Override
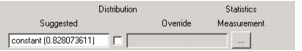
Job Classes
这是服务器支持的标准基准测试列表。预定义的服务器配置包含在 http://www.spec.org 发布的 CPU2000 基准测试。对于多处理器系统,rate 值已除以处理器数量,以提供“每处理器”评级。
Note: 你也可以在这里添加自己的基准测试,但不能保证你的服务器会支持该基准测试。
图 35:Job Classes 下拉菜单
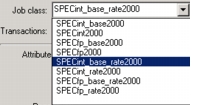
下表列出了你可以应用于 job 的 job class。
表 9:Job Class 定义
| Job Class | 说明 |
|---|---|
| SPECint_base2000 | 运行单个实例的整数基准测试所需的时间。使用标准的编译器优化设置。 |
| SPECint2000 | 运行单个实例的整数基准测试所需的时间。为最大化性能进行了激进的优化。 |
| SPECint_base_rate2000 | 每小时可执行的整数基准测试数量。这可能涉及在多 CPU 计算机上并发运行多个实例。使用标准的编译器优化设置。 |
| SPECint_rate2000 | 每小时可执行的整数基准测试数量。这可能涉及在多 CPU 计算机上并发运行多个实例。为最大化性能进行了激进的优化。 |
| SPECfp_base2000 | 运行单个实例的浮点基准测试所需的时间。使用标准的编译器优化设置。 |
| SPECfp2000 | 运行单个实例的浮点基准测试所需的时间。为最大化性能进行了激进的优化。 |
通常,对于非数值程序,SPECint_base_rate2000 是较好的基准测试选择;对于数值程序,则选择 SPECfp_base_rate2000。