Server 属性
除了 Server Configuration 属性之外,各个服务器节点上还提供了多个属性。这些属性只影响指定它们的那台服务器,但在很多情况下它们依赖于 Server Configuration 对象中提供的信息。
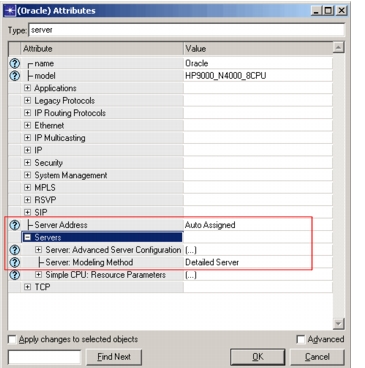
图 502:服务器节点上的 Server Modeling 属性
-
Server: Modeling Method(服务器:建模方法)。目前详细服务器模型既可用于独立服务器建模,也可配合 Custom Application 或 Transaction Analyzer 用于端到端应用性能建模。其他现有的 Riverbed 应用模型仍然使用简单 CPU 模型。而当不需要详细建模时,你可以为场景中的某台服务器选择合适的建模方法。
- Simple CPU(简单 CPU)。该方法使用简单的竞争模型来模拟服务器活动。Simple CPU 模型用于模拟 IP 数据包转发延迟和应用处理延迟。与简单 CPU 模型相关的配置位于 ‘CPU Resource Parameters’ 和 ‘CPU Background Utilization’ 复合属性中(本使用指南不描述这两个属性)。
- Detailed Server(详细服务器)。详细服务器建模方法使用本文档描述的 advanced 建模能力。以 Detailed Server 模式运行需要专门的许可证。注: 在该模式下,Simple CPU 模型和详细服务器模型都处于活动状态。Simple CPU 模型仍然负责模拟 IP 数据包转发延迟和应用处理延迟(包括 Custom Application 和 Transaction Analyzer,除非明确把 Custom Application 和 Transaction Analyzer 的配置与详细服务器模型关联起来)。
所有与详细服务器模型相关的属性都包含在 Server: Advanced Server Configuration 属性中。这些属性用于描述服务器的 CPU 与 IO 子系统、配置服务器上定义的存储分区,并列出要在服务器上运行的工作负载(作业)。
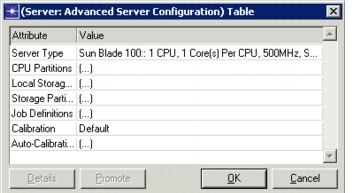
图 503:Advanced Server Configuration 表
-
Server Type(服务器类型)。Server Definitions 对话框中所描述的服务器类型名称。它描述这台“目标”服务器的特征。所指定的服务器名称用于在 Server Definitions 表中获取与该服务器类型相关的信息。
-
CPU Partitions(CPU 分区)。允许把服务器的 CPU 分组成处理器集合,称为 CPU Partition。
- 每个 CPU Partition 都像一台独立的服务器,每个 CPU 分区可以运行不同的操作系统,并拥有自己的分页系统。
- 每个 CPU Partition 维护自己的作业队列。
- 工作负载(作业)与 CPU Partition 绑定,也就是说作业只在属于该 CPU Partition 的 CPU 上运行。
- 一个 CPU 可以属于多个 CPU Partition,这些 CPU Partition 使用这个 CPU 的权重相等。
- 在所有共享该 CPU 的 CPU Partition 的就绪作业队列中,CPU 被分配给优先级最高的作业。
- 应始终配置一个名为 ‘Default’ 的默认 CPU Partition。所有未分配的 CPU 都被划入该 CPU Partition。默认情况下,所有作业都被分配到该分区。配置 CPU Partition 需要指定一个唯一名称、属于该 CPU Partition 的 CPU 列表、在其上运行的操作系统以及它的分页系统定义。下面逐一详细介绍这些属性。
图 504:CPU Partitions 表
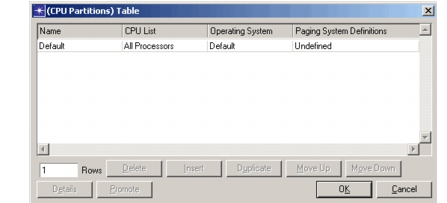
- Name(名称)。用于唯一标识该 CPU Partition 的值,以便把作业绑定到它以及用于统计量报告。
- CPU List(CPU 列表)。属于该 CPU Partition 的 CPU 列表,CPU 用从 0 开始的索引标识。
图 505:CPU List 表
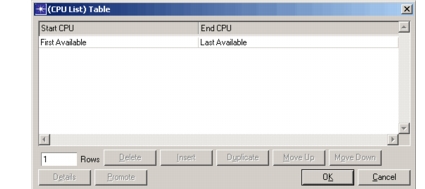
CPU List 表中的每一行指定一个索引范围。CPU 列表由所有索引范围求并集得到。
- Operating System(操作系统)。Server Configuration 对象中给出的操作系统描述。它描述用于该 CPU Partition 中各 CPU 的时间片和调度算法。注:当一个 CPU 被多个 CPU Partition 共享时,这些 CPU 分区上配置的操作系统应具有相同的时间片。
- Paging System Definitions(分页系统定义)。每个 CPU 分区都与自己的分页系统相关联,其定义包括以下内容:
图 506:Paging System Definitions 属性
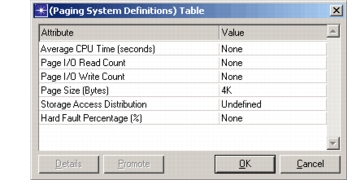
a) Average CPU Time (seconds)(平均 CPU 时间(秒))。单次分页操作使用的 CPU 时间量,无论是硬页面错误(需要 I/O)还是软页面错误(不需要 I/O)。 b) Page I/O Read/Write Count(页面 I/O 读/写次数)。发生硬页面错误时,分页操作需要 I/O 操作。这些分布决定所需的读和写次数。 c) Page Size (Bytes)(页面大小(字节))。与标准 I/O 操作不同,分页操作由操作系统定义,而不是由作业定义。 d) Storage Access Distribution(存储访问分布)。分页系统需要知道分页操作将如何在可用的存储分区之间分布。
 *Storage Partition Name*(存储分区名称)。接收该 I/O 操作的存储分区名称。

 *Access Weight.*(访问权重。)每个存储分区被赋予一个访问权重,决定哪个存储分区接收某个 I/O 操作。在仿真平均意义上,权重相等的两个存储分区接收到相同数量的操作。
e) Hard Fault Percentage (%)(硬页面错误百分比(%))。作业定义决定一个应用产生多少页面错误。该参数决定其中有多少在内存中找到,有多少需要一次 I/O 操作
- Local Storage Subsystem(本地存储子系统)。描述连接到系统的磁盘和磁盘接口的物理布局。它表示服务器的直连存储(DAS)配置。
图 507:Local Storage Subsystem
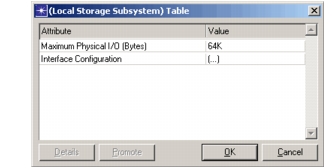
Maximum Physical I/O(最大物理 I/O)。定义该参数后,大数据传输会被拆分为若干较小的传输。对于配置了 RAID 的系统(RAID 1 除外,关于 RAID 配置稍后详述),该值与数据条带大小中较小的一个决定数据传输的最大尺寸。
Interface Configuration(接口配置)。与真实服务器一样,一个接口包含一个或多个接口通道,每个通道连接零个、一个或多个磁盘驱动器。它们的指定方式类似:
图 508:Interface Configuration 表
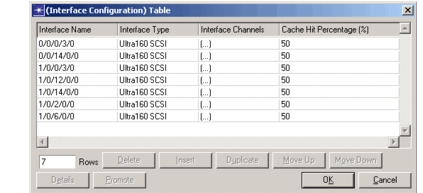
- Interface Name(接口名称)。用于唯一标识该接口的值,供统计量和报告使用。
- Interface Type(接口类型)。Server Configuration 对象中给出的接口描述。它描述接口的硬件特征。
- Cache Hit Percentage(缓存命中率)。所有磁盘读取中,直接从控制器板载缓存取得而无需访问磁盘的比例。
- Interface Channels(接口通道)。每个磁盘接口可以有一个或多个接口通道。Interface Channel 表只有一列:‘Disk Configuration’。该表的每一行表示连接到该接口通道的磁盘,通道由行号索引。
图 509:Interface Channels 表
Disk Configuration(磁盘配置)。连接到该接口的磁盘驱动器描述。
图 510:Disk Configuration 表
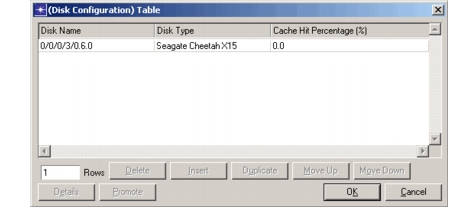
Disk Name(磁盘名称)。用户定义的值,用于配置 Local(直连)存储分区,以及供统计量和报告使用。
Disk Type(磁盘类型)。驱动器的硬件特征描述,在 Server Configuration 对象中定义。
Cache Hit Percentage(缓存命中率)。所有磁盘读取中,直接从驱动器板载缓存取得而无需访问物理驱动器的比例。与接口层的缓存命中不同,驱动器层的命中仍然需要一次数据传输操作。
-
Storage Partition(存储分区)。作业(进程)不直接从磁盘读/写,而是从存储分区读/写。举一个日常例子,你的 Windows 机器可能有一块硬盘被划分为 C: 和 D: 两个驱动器。保存文件时,你指定要保存到的驱动器(以及该驱动器上的目录)。此外,你可能还有访问远程服务器数据的映射驱动器。类似地,Unix 系统通常挂载多个分区,每个分区可以是一块不同的磁盘、同一块磁盘上的不同逻辑卷,或者是 NFS 挂载。存储分区构成一层间接引用,便于使用不同的存储方法和设备类型。
Riverbed 服务器模型支持三种类型的存储分区:
- Local(本地)——使用直连存储的存储分区
- Measured(实测)——访问时间和吞吐量已知、但缺少详细磁盘/存储设备信息的存储分区
- Remote(远程)——从远程服务器的存储分区访问数据的存储分区
图 511:Storage Partitions 表
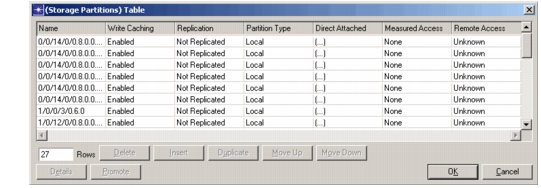
Name(名称)。用于唯一标识该存储分区的值。在作业定义和分页系统定义中使用,并用于统计量报告。
Partition Type(分区类型)。即上述三种存储分区类型。当分区类型设置为 “Local” 时,由 “Direct Attached” 属性提供相关信息;设置为 “Measured” 时使用 “Measured Access” 属性;设置为 “Remote” 时使用 “Remote Access” 属性。
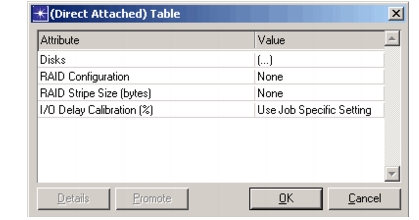
Direct Attached(直连)。指定本地存储分区所需的信息。直连存储使用在 “Local Storage Subsystem” 复合属性中配置的磁盘。一个本地存储分区可以跨越多块磁盘,一块磁盘也可以属于多个存储分区。此外,本地存储分区可以有 RAID 配置。
图 512:Direct Attached 表
-
Disks(磁盘)。允许指定属于该存储分区的磁盘列表。这些磁盘必须先在 “Local Storage Subsystem” 属性中配置好。
-
RAID Configuration(RAID 配置)。该属性指定 RAID 参数。存储分区支持若干常见 RAID 标准,包括:
RAID 0 - Data Striping(数据条带化)。 数据按固定大小的“条带”分布在多个驱动器上。这使得一个驱动器进行数据传输时,第二或第三个驱动器可以为下一次数据传输做好准备,从而显著提升磁盘访问性能。遗憾的是,RAID 组中单个驱动器的丢失会在数据中留下空洞,实际上导致所有信息丢失。数据条带化至少需要两个驱动器。
RAID 1 - Data Mirroring(数据镜像)。 主要为提高容错能力而设计,镜像会把同一数据的独立副本写入两个或更多驱动器。丢失其中一个驱动器不会造成数据丢失。由于可以访问最先可用的驱动器,读性能可能略有提升;而写性能会下降,因为一次逻辑写需要多次物理写。镜像至少需要两个驱动器,额外驱动器按成对方式增加。
RAID 0+1 - Striping and Mirroring(条带化与镜像)。 为了同时获得 RAID 0 的性能和 RAID 1 的容错能力,两者常被一起使用。条带化实际上同时在两个驱动器上进行,从而形成镜像。这通常用于低端服务器,因为它对可用磁盘空间的利用效率不高。至少需要四个驱动器,额外驱动器按成对方式增加。
RAID 5 - Parity(奇偶校验)。 为更高效地使用存储资源,RAID 5 使用分布式奇偶校验方案来维持容错能力。写操作与镜像方案类似需要两次物理写,但 RAID 5 把多个驱动器上的数据组合为一个奇偶校验块,再把它分布到各驱动器组中。结果是,组中任意一个驱动器的丢失都不会导致全部数据丢失。把奇偶校验信息均匀分布在所有驱动器上,可以避免任何一个驱动器成为瓶颈。把多个驱动器的数据组合为一个奇偶校验条带意味着,随着驱动器数量增加,奇偶信息带来的存储开销会下降。RAID 5 至少需要三个驱动器。
-
RAID Stripe Size(RAID 条带大小)。当配置 RAID 0(条带化)、RAID 0+1(条带化与镜像)和 RAID 5(分布式奇偶校验)时,决定一个“条带”的尺寸。大于条带大小的数据传输会被拆分为多个该尺寸或更小尺寸的传输。
-
RAID Implementation(RAID 实现方式)。RAID 实现可以是硬件实现或软件实现。目前只对硬件实现建模。
-
RAID Access Job(RAID 访问作业)。将在支持软件实现建模时使用。目前该属性值不会被读取。
Measured Access(实测访问)。有时无法从数据采集代理获得的服务器性能数据中识别作业访问的具体存储分区,但可以获得关于访问时间以及数据传输所用接口吞吐量的信息。在这种情况下可以使用 Measured 存储分区。
图 513:Measured Access 表
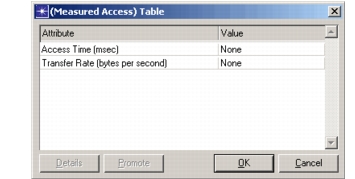
- Access Time(访问时间)。描述访问数据所花费时间的分布。该信息可以从数据采集器报告的响应时间获得。
- Transfer Rate(传输速率)。一个整数,指定访问数据所用接口的吞吐量。
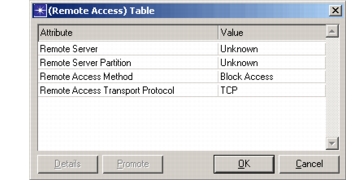
Remote Access(远程访问)。操作系统和网络协议实现使得访问远程服务器上的数据可以无缝进行。类型为 “Remote” 的存储分区允许作业访问远程数据。这使我们能够建模远程存储访问对作业完成时间的影响,以及承载这些流量的网络上的流量负载影响。
图 514:Remote Access 表
-
Remote Server(远程服务器)。其存储分区将被访问的那台服务器的名称。活动的属性处理程序会列出所有 “Server Address” 属性值不为 “Auto Assigned” 的服务器的 “Server Address” 属性值。
-
Remote Server Partition(远程服务器分区)。上述远程服务器上的存储分区。活动的属性处理程序会列出该远程服务器上定义的所有存储分区。每当 “Remote Server” 的值被修改时,该属性的值会被重置为 “None”。
-
Remote Access Method(远程访问方法)。访问远程分区所使用的访问方法。访问方法定义了访问远程分区所允许的传输协议列表。
-
Remote Access Transport Protocol(远程访问传输协议)。用于访问远程分区的传输协议。发起远程分区访问的服务器称为 “Remote Storage Client”(远程存储客户端),处理该访问请求的服务器称为 “Remote Storage Server”(远程存储服务器)。
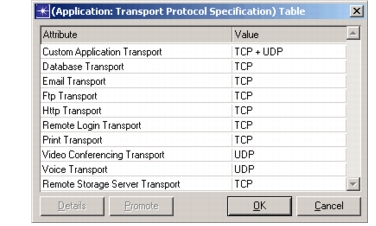
为了让 “Remote Storage Client” 与 “Remote Storage Server” 能够通信,该属性值应与 “Remote Storage Server” 的 “Application: Transport Protocol Specification” 属性中指定的 “Remote Storage Server Transport” 值一致。
图 515:Remote Storage Server Transport
Write Caching(写缓存)。允许用户启用或禁用写缓存。启用写缓存后,作业提交的写操作被启动,并且作业会立即被告知操作已完成,从而可以继续下一步处理。写操作在后台执行。注:这种情况下,“Storage Partition Response Time” 统计量被加上零值,而 “Storage Partition Completion Time” 统计量被加上实际的写完成时间。
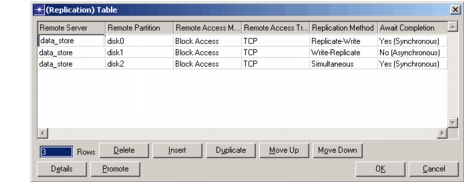
Replication(复制)。服务器模型的复制功能允许把写操作复制到一个远程服务器的存储分区。主存储分区可以是任意类型:Local、Measured 或 Remote。支持三种复制方法:
- Write-Replicate(先写后复制)——先向主分区写数据,写操作完成后再开始复制操作
- Replicate-Write(先复制后写)——先复制(即先写远程服务器),复制操作完成后再开始向主分区写数据。
- Simultaneous(同时进行)——同时开始向主分区写数据和复制操作。
在每种方法中,复制又可以是
- Synchronous(同步)——等待远程服务器确认复制操作已完成。
- Asynchronous(异步)——不等待远程服务器的确认,发出复制操作后继续执行。
主存储分区可以请求把写操作复制到多台远程服务器,每次复制都可以有自己的复制方法。
图 516:Replication 表
-
Remote Server(远程服务器)。与上文 “Remote Access” 复合属性中的说明相同。
-
Remote Partition(远程分区)。与上文 “Remote Access” 复合属性中的说明相同。
-
Remote Access Method(远程访问方法)。与上文 “Remote Access” 复合属性中的说明相同。
-
Remote Access Transport Protocol(远程访问传输协议)。与上文 “Remote Access” 复合属性中的说明相同。
-
Replication Method(复制方法)。可以是 Write-Replicate、Replicate-Write 和 Simultaneous 中的一种。参见上文说明。
-
Await Completion(等待完成)。允许用户控制复制操作何时被视为完成。“Yes (Synchronous)” 等待完成,“No (Asynchronous)” 不等待完成。
-
Job Definitions(作业定义)。该属性在 Server Configuration 对象提供的作业定义基础上进一步展开,列出适用于这台特定服务器的作业以及它们的使用方式。
图 517:Job Definitions 属性
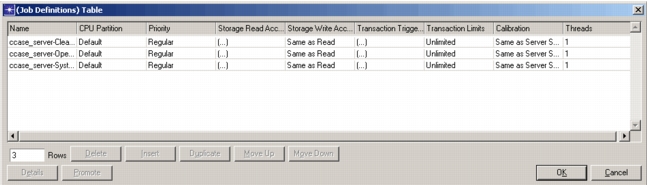
- Name(名称)。这是在 Server Configuration 对象中定义的作业名称。必须先在该对象中定义作业,才能把它分配给某台服务器。
- CPU Partition(CPU 分区)。该作业要绑定到的 CPU Partition。必须先在 ‘CPU Partitions’ 属性中定义该 CPU 分区。
- Priority(优先级)。服务器支持 10 级优先级——0(最低)到 9(最高)。为方便起见,预定义了三个优先级级别:low、regular 和 high。在每个时间片结束时,可用的最高优先级作业被分配给 CPU。如果采用可抢占调度算法,且在某个时间片进行中出现了更高优先级的作业,则占用 CPU 的最低优先级作业会被抢占。
- Storage Read/Write Access Distribution(存储读/写访问分布)。虽然 I/O 的总体特征(例如发生频率和进程的平均大小)由其实测属性决定(因此在 Server Configuration 对象中定义),但这些 I/O 操作在可用存储分区之间的分布则取决于服务器的存储分区配置。
图 518:Storage Read Access Distribution
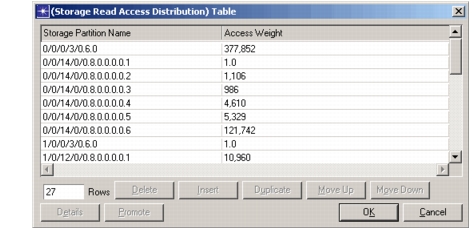
Storage Partition Name(存储分区名称)。接收该 I/O 操作的驱动器名称。
Access Weight(访问权重)。每个存储分区被赋予一个访问权重,决定哪个存储分区接收某个 I/O 操作。在仿真平均意义上,权重相等的两个存储分区接收到相同数量的操作。
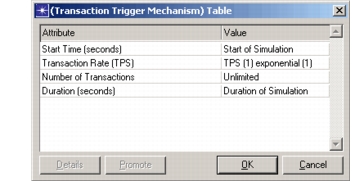
- Transaction Trigger Mechanism(事务触发机制)。用于确定作业实例如何创建。
图 519:Transaction Trigger Mechanism
- Transaction Limits(事务限制)。许多作业对同时活动的实例数量有限制。例如,你的公司可能购买了固定授权数量(比如 6 个)的软件,因此在任一时刻最多只能有 6 个实例处于活动状态。该属性正是用来配置这一点。
图 520:Transaction Limits
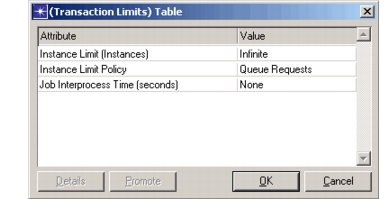
Instance Limit (Instances)(实例上限(实例数))。任一时刻可以处于活动状态的最大实例数量。
Instance Limit Policy.(实例上限策略。)决定达到实例上限时如何处理作业。设置为 “Reject” 时,作业被丢弃且永不执行。设置为 “Queue Requests” 时,作业进入队列,直到某个实例完成且进程间时间到期。
Job Interprocess Time(作业进程间时间)。在某些情况下,可能需要指定一个作业实例结束与下一个实例开始之间的最小时间。这只影响设置了实例上限并采用 “Queue Requests” 实例上限策略的作业。
- Calibration.(校准。)用于作业特定的校准值。
- Threads.(线程。)一个作业可以作为单线程或多线程运行。多线程作业中的每个线程都可以独立于其他线程运行。在多 CPU 服务器上,如果多线程作业的各线程在不同 CPU 上并行运行,作业有可能更快完成。作业执行时,所有线程同时加载到服务器中。如果服务器是多 CPU 的,那么部分或全部线程会被并行执行(取决于服务器拥有的 CPU 数量以及执行时它们的可用情况)。
注: 在 Riverbed 模型的语境中,线程的定义并不局限于 “POSIX” 线程。它可以指给定作业中能够并行运行的任意进程(或进程集合)。