Server Configuration 对象属性
Server Configuration 对象具有多个描述底层服务器硬件的属性。Server Configuration 对象中描述的硬件属性列举如下:
图 482:Server Configuration 对象属性
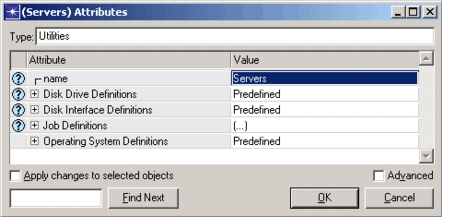
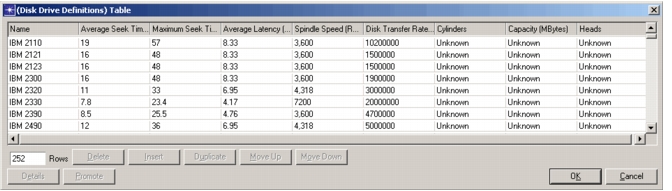
- Disk Drive Definitions(磁盘驱动器定义)。该属性描述常见磁盘驱动器的硬件特征。默认值取自厂商数据手册。
图 483:Disk Drive Definitions 属性
-
Name(名称)。该属性描述物理驱动器,通常包含厂商名称和型号。
-
Average Seek Time(平均寻道时间)。该属性指定驱动器的读/写磁头移动到正确磁道上方所需的平均时间。
-
Maximum Seek Time(最大寻道时间)。该属性指定读/写磁头从第一条磁道移动到最后一磁道(或反向)所需的时间。它与 Average Seek Time 类似,但受驱动器物理几何结构限制。
-
Average Latency(平均延迟)。该属性指定驱动器旋转到可进行读/写操作的正确位置所需的时间。
-
Spindle Speed(主轴转速)。该属性指定最大延迟,由驱动器的旋转速度决定。磁盘旋转一圈所需的时间即驱动器所能产生的最大延迟。
-
Disk Transfer Rate(磁盘传输速率)。该属性指定数据在驱动器接口总线上可传输的最大速率(不过驱动器内部的传输速率可能更快)。
-
Cylinders(柱面数)。磁盘驱动器上的物理柱面数量。服务器磁盘模型不使用该属性值。
-
Capacity(容量)。磁盘驱动器的存储容量,单位为兆字节(Megabytes)。服务器磁盘模型不使用该属性值。
-
Heads(磁头数)。磁盘驱动器中的物理磁头数量。服务器磁盘模型不使用该属性值。
-
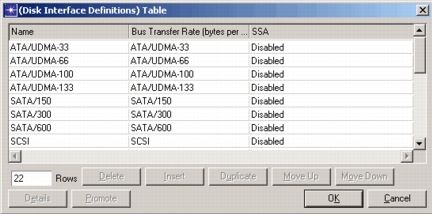
Disk Interface Definitions(磁盘接口定义)。接口是一种共享总线设备,可控制数量不定的磁盘驱动器。提供了许多标准配置,其属性如下:
图 484:Disk Interface Definitions 属性
-
Name(名称)。该属性指定一个用户定义的值,用于描述物理接口。通常包括接口标准以及该设备使用的任何 RAID(廉价磁盘冗余阵列)配置。
-
Bus Transfer Rate(总线传输速率)。该属性指定驱动器与接口之间的最大数据传输速率。如果驱动器较慢,实际传输速率可能更低。一次只能有一个驱动器传输数据。
-
SSA - Serial Server Architecture(串行服务器架构)。这是 IBM 制定的一项标准,通过提供两条读总线和两条写总线来提高接口吞吐量。只要传输目标是不同的物理驱动器,最多可以有四个数据传输操作同时进行。
-
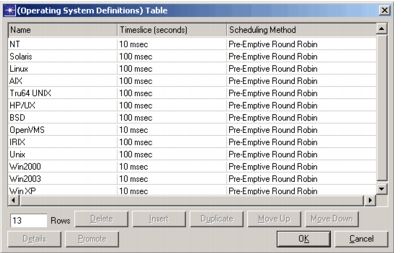
Operating System Definitions(操作系统定义)。该属性指定操作系统描述,其中包括默认操作系统以及该操作系统所使用的调度方法的信息。
图 485:Operating System Definitions
-
Name(名称)。唯一描述该操作系统定义的用户定义值。
-
Timeslice(时间片)。这是作业使用处理器、随后把 CPU 让给另一个进程之前的最长时间。一般而言,时间片越小产生的事件越多,仿真时间也越长。
-
Scheduling Method(调度方法)。用于把作业派发到处理器的算法。目前定义了两种调度方法:
-
Round-Robin(轮转)。 该算法在一个时间片开始时,或处理器空闲时,调度可用的最高优先级作业。该算法不允许在有更高优先级作业可用时抢占正在运行的作业。
-
Pre-Emptive Round-Robin(可抢占轮转)。 该算法在一个时间片开始时,或处理器空闲时,调度可用的最高优先级作业。如果所有处理器都忙时有一个新作业可用,则优先级低于该新作业的最低优先级作业会被抢占,以便新作业可以执行。
-
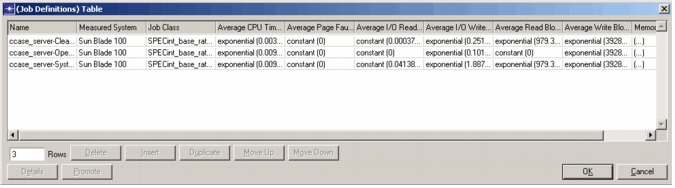
Job Definitions(作业定义)。该属性指定工作负载描述,其中包括服务器作业实测性能的信息。这些作业定义与运行它们的服务器无关。当存在同一作业的多个副本时,相关信息会被提炼为一个有代表性的“实例”,之后可以按比例缩放。这里描述的属性都适用于该代表性实例:
图 486:Job Definitions 表
-
Name(名称)。唯一描述该工作负载的用户定义值。注:作业名 remote_access 是保留名称,不能在作业定义表中指定。参见 Server Attributes 一节中关于 Job Definitions 属性的讨论。
-
Measured System(实测系统)。当为获取实测值所用系统之外的系统仿真作业时,模型需要知道如何缩放这些值。该属性与作业类别一起使缩放得以进行。必须先存在该系统的服务器描述,才能获得此值。
-
Job Class(作业类别)。由于不同作业的性能特征不同,每个作业可以被赋予自己的“类别”。该值取自“Measured System”所描述服务器提供的作业类别列表。由于该值用于缩放作业,它必须同时存在于上述实测系统以及单个服务器上描述的目标系统中。
-
Average CPU Time(平均 CPU 时间)。描述作业消耗处理器时间的分布。
-
Average Page Faults(平均页面错误数)。描述单个作业实例产生的页面错误数量的分布。其中包括硬页面错误(需要通过 I/O 操作与磁盘上的数据交换)和软页面错误(数据在内存中找到)。
-
Average I/O Reads/Writes(平均 I/O 读/写次数)。描述作业典型 I/O 行为的分布。这些 I/O 会在作业的整个生命周期内均匀分布。
-
Average I/O Read/Write Blocksize(平均 I/O 读/写块大小)。描述单次 I/O 操作传输数据量的分布。它会影响 I/O 处理时间。
-
Memory Requirements(内存需求)。内存使用量也按单个实例进行跟踪。由于许多应用无论活动实例数量多少都会使用一定量的最低内存,因此可能需要定义一个只消耗内存而不消耗其他资源的作业,用来表示这一基线需求。
图 487:Memory Requirements 表
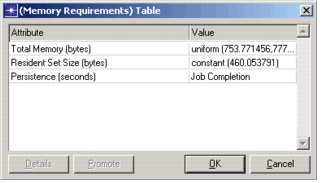
- Total Memory(总内存)。作业使用的全部内存,包括驻留在内存中的部分(Resident Set Size)以及包含在交换区中的部分。
- Resident Set Size(常驻集大小)。作业消耗的物理内存量,不包括位于交换区中的任何内存。
- Persistence(持久性)。描述内存需要保持多久的分布。通常设置为 Job Completion(作业完成),即作业结束时释放内存。如果内存在整个仿真期间持续使用,应设置为 ‘End of Simulation’(仿真结束)。
Server Definitions Editor(服务器定义编辑器)
Server Library 提供了访问存储在外部文件中的服务器定义的接口。Server Characterization Editor(SCE)和工程编辑器显示的是同一个对话框。
Server Definition 对话框允许你查看和编辑现有服务器定义,并创建新的服务器定义。在 Project Editor 中,可以通过菜单 Protocols > Servers > Open Server Library 访问服务器定义(在 SCE 主窗口中则通过 Hardware > Server Definitions... 菜单项)。以下各图说明该编辑器的工作方式。
图 488:Server Library 对话框
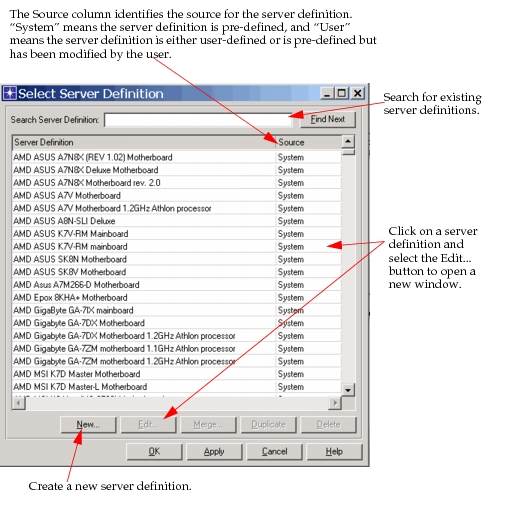
图 489:复制服务器定义
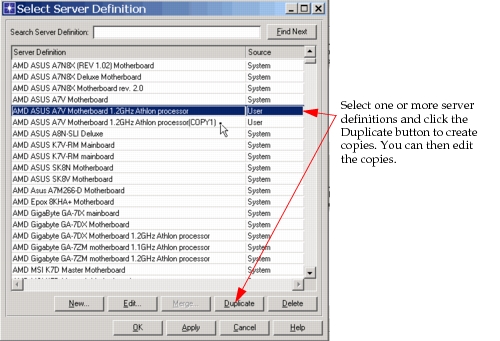
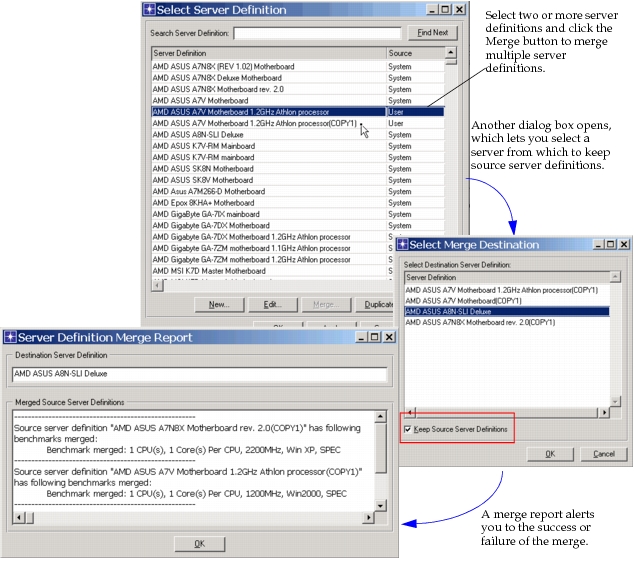
图 490:合并服务器定义
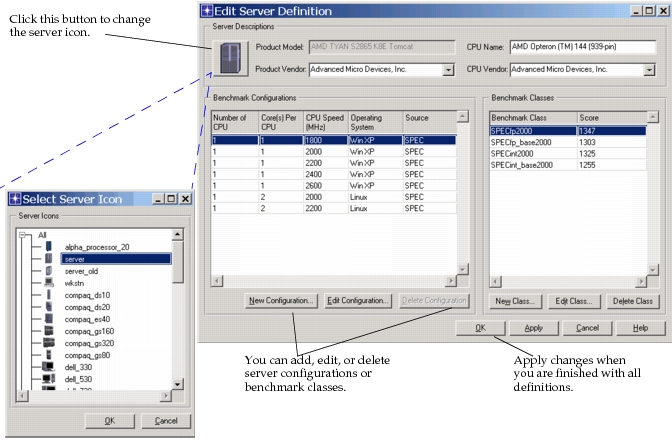
当你选择编辑某个服务器定义时,会出现下图所示的对话框。可编辑字段在下一节中说明。
图 491:Edit Server Definition 对话框
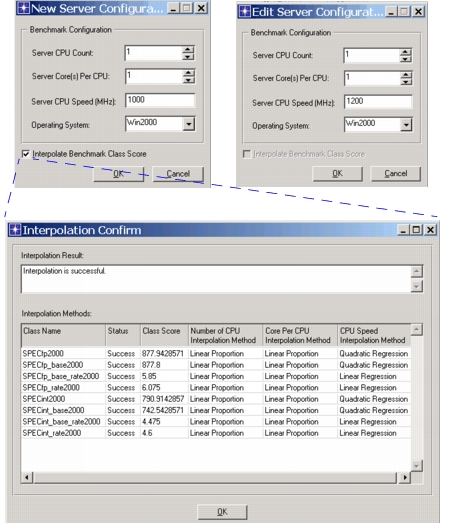
如果你选择 New Configuration... 或 Edit Configuration... 按钮,会出现一个新的对话框,如下图所示。你可以编辑 CPU 数量、每个 CPU 的核心数、CPU 速度和操作系统。创建新的服务器配置时,你还可以选择根据已知数据点对基准测试类别分数进行插值。
图 492:New/Edit Configuration 对话框
- Product Model(产品型号)。描述服务器的预定义值,通常包含厂商名称和型号。该值与具体的服务器配置信息组合生成一个唯一键。作业定义再引用该键来识别测量该作业所在的系统。
- Product Vendor(产品厂商)。该属性指定服务器的制造商。服务器模型不使用该属性,它供 SCE 用于服务器匹配。
- CPU Model(CPU 型号)。描述服务器的用户定义值,通常包含厂商名称和型号。
- CPU Vendor(CPU 厂商)。该属性指定服务器所用处理器的制造商。服务器模型不使用该属性,它供 SCE 用于服务器匹配。
- Number of CPUs(CPU 数量)。该属性指定系统包含的实际微处理器数量。每个微处理器可以包含一个或多个“核心”。Server Characterization Editor(SCE)在为新基准测试类别分数插值时使用该属性。
- Core(s) Per CPU.(每个 CPU 的核心数。)该属性指定 CPU 中包含的微处理器核心数量。每个核心都是一个体系结构上的计算处理单元。SCE 在为新基准测试类别分数插值时使用该属性。
- CPU Speed (MHz)(CPU 速度,单位 MHz)。该属性指定服务器所用处理器的速度(以 MHz 计)。SCE 在为新基准测试类别分数插值时使用该值。
- Operating System(操作系统)。该属性指定运行基准测试程序的操作系统。操作系统值指向 Server Config 对象的 Operating System Definitions 属性中的一个条目:该条目指明要使用的时间片和调度算法。
- Source.(来源。)该属性标识服务器配置的来源。“SPEC”表示该服务器配置及其对应的基准测试类别信息直接来自 SPEC 网站。“User”表示该服务器配置由用户定义,或者是预定义但已被用户修改。
- Benchmark Classes(基准测试类别)。这是服务器支持的标准基准测试类别及其分数的列表。预定义的服务器配置包含在 http://www.spec.org 发布的 CPU2000 和 CPU95 基准测试。对于多处理器系统,rate 值已除以处理器数量,以提供“每处理器”评级。
插值方法
服务器模型支持基准测试类别分数插值,也就是说,新创建的服务器配置可以根据同一服务器定义中其他服务器配置的现有基准测试类别数据,自动生成自己的基准测试类别数据。基本插值方法是多变量二次回归(Multi-Variable Quadratic Regression)。回归中使用三个变量——Number of CPU、Core(s) Per CPU 和 CPU Speed。插值计算回归参数,并用下面的公式得到最终的插值分数:
图 493:插值公式
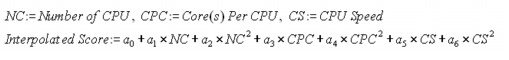
某些服务器定义中可用的数据可能不足以进行完整的 Multi-Variable Quadratic Regression。这通常发生在服务器定义只包含 2~3 个服务器配置时。在这种情况下,插值方法会降级,如下图所示。
图 494:次级插值方法
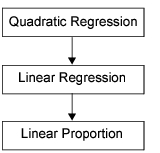
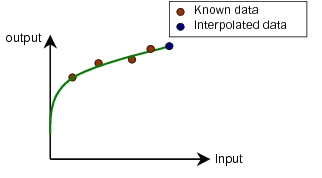
各插值方法之间的主要差别在于数据回归方法。Quadratic Regression(二次回归)尝试用二次函数找到最佳拟合线。下图给出输入为单个变量的二次回归示例。
图 495:二次回归
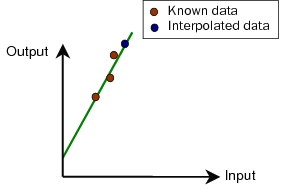
Linear Regression(线性回归)方法尝试用线性函数找到最佳拟合线。下图是输入为单个变量时的线性回归示例。
图 496:线性回归
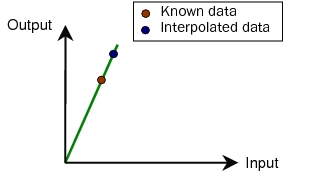
Linear Proportion(线性比例)是最简单的方法。它以线性方式缩放输入数据。只允许一个输入数据点,不涉及回归。
图 497:线性比例
当没有足够数据进行完整的二次回归时,会应用线性回归。当线性回归也不适用时,会应用线性比例。由于线性比例只需要一个数据点,因此它适用于所有场景。
Server Scaler(服务器缩放器)
Server Scaler 对话框通过 Protocols > Servers > Upgrade/Downgrade Servers 菜单访问。该对话框让你把服务器定义快速部署到网络模型中的一个或多个服务器。你可以选择多个要部署的服务器定义并使用 << 按钮进行批量更改,也可以把单个服务器定义拖放到单个网络对象上。
图 498:Server Scaler 对话框
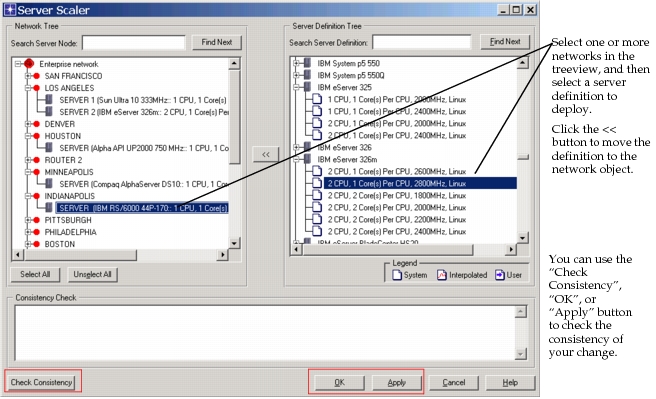
Check Consistency 按钮执行一次检查,看以下两个条件是否满足:
- 已部署的服务器配置位于外部服务器定义文件中
- 对于服务器节点上定义的所有服务器作业,对应的已部署服务器配置支持当前指定的作业类别
服务器仿真操作
Server Simulation Operations 菜单操作(Protocols > Servers > Show/Hide Server Planning Toolbar)会显示一组与离散事件仿真相关的选项。通过该菜单,你可以运行仿真、查看仿真结果、打开 Workload Scaler,或自动校准服务器。
图 499:服务器仿真操作
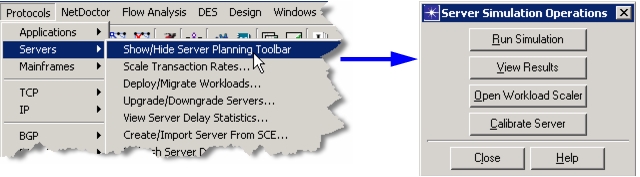
当你选择 Calibrate Server 按钮时,可以自动校准服务器的 I/O 子系统。首先你必须把数据导入 SCE,把进程分类为作业,并定义服务器工作负载。校准之后,该工作负载的 DES 结果会根据 Calibration Threshold 的设置,与从服务器实际采集的性能数据紧密吻合。更多细节参见过程 107。
运行校准之前需要记住的一些重要事项如下:
- 自动校准只对详细服务器有效,对简单服务器无效。
注: 要检查服务器类型,在工程编辑器中右键单击该节点并选择 Edit Attributes。展开 Servers 复合属性,查看 Server Modeling Method 的值。
- 在要校准的服务器上,把属性 Servers > Advanced Server Configuration > Storage Partitions > Partition Type 设置为 “Local”。同时确保该表中的 Measured Access 属性包含合适的值。Measured Access 属性就是校准引擎试图匹配的数值。这些值可能已根据当前信息填写,但你可以根据需要调整。
- 确保 Servers > Advanced Server Configuration > Local Storage Subsystem > Interface Configuration > Interface Channels > Disk Configuration > Disk Type 中的值与你的实际磁盘尽可能接近。
过程 107:自动校准服务器
-
在 Server Simulation Operations 对话框中选择 Calibrate Server。
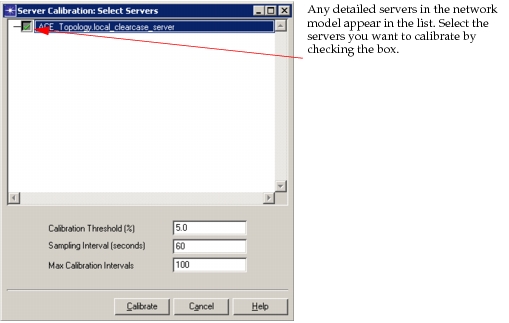
结果: 出现 Server Calibration: Select Servers 对话框。
图 500:Select Servers
-
选择你要校准的服务器。
-
(可选)你可以设置校准的可选参数,也可以选择接受默认值。
3.1 设置响应时间中可接受的 Calibration Threshold(校准阈值)水平。该值是实测 I/O 响应与 DES 确定的 I/O 响应之间可容忍的误差百分比。例如,数据采集器报告存储分区 C 的平均响应时间为 5ms,校准阈值为 5%。校准开始时,一旦 DES 值落在 5ms 的 +/- 5% 范围内,校准即告完成。这可以减少一次校准运行所花的时间。
注: 为获得最佳效果,不要把 Calibration Threshold 设置为低于 2% 的值。
3.2 把 Sampling Interval (Seconds)(采样间隔,单位秒)设置为两次采样之间的秒数。该字段指定校准算法使用的轮询间隔。对于 I/O 密集的服务器,10 秒的轮询间隔已经足够;但如果服务器相对空闲,则需要更长的轮询间隔。设置该间隔是为了让存储分区的平均值收敛到稳定平均值。
3.3 把 Max Calibration Intervals(最大校准次数)设置为要运行的校准总次数。该字段指定在判定校准失败之前尝试的最大迭代次数。该值乘以 Sampling interval 等于 DES 中花费的最大仿真时间。
-
单击 Calibrate 按钮。
结果: 运行一次校准 DES,结束时服务器即完成校准
过程 107 结束
Refresh Server Data(刷新服务器数据)
通过菜单选项 Protocols > Servers > Refresh Server Data...,你可以在不使用 SCE 的情况下把系统性能数据部署到 Project Editor 中现有的服务器。要使用该快捷方式,你必须提供性能数据以及一个用于把进程筛选为服务器作业的 SCE 作业模板。
图 501:Refresh Server Data
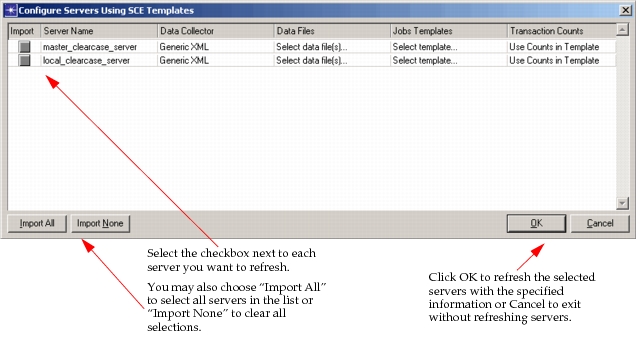
当你选择 Refresh Server Data... 时,会出现图 501所示的对话框。根据你的工程填写各字段。字段说明如下:
- Data Collector——指定所使用的采集器类型。可选值为 BMC Patrol、HP OVPA - from file、HP OVPA - Connect to OVPM、NetIQ AppManager、Windows Perfmon 或 Generic XML。
- Data Files——指定包含性能数据的数据文件。单击该字段会打开文件选择窗口。
- Jobs Template——指定用于把进程级数据聚合为服务器作业的模板。可选值为 Apache_Server、IIS_Server、Informix_Server、MySQL_Server、Oracle_Server、Sybase_Server 或 System。
- Transaction Counts——根据模板中的计数指定性能数据中的事务数量。你也可以选择对数据做时间归一化。