使用 EMA
前面的主题介绍了 EMA 库函数以及 Riverbed 分析软件的模型、对象、属性与常量。本节给出使用 EMA 进行模型构建的详细内容。
模型构建
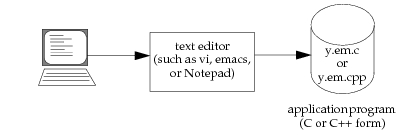
下图展示了用 EMA 创建模型所涉及操作的典型顺序。文件后缀标识 EMA 应用的不同形式。典型顺序为:
-
用 C 或 C++ 编写应用程序,调用正确的 EMA 函数来创建并写出一个 Riverbed 模型。无论该应用读取或写入何种模型类型,应用的文件后缀都必须是
.em.c或.em.cpp,这样 EMA 编译工具op_mkema才会将该文件识别为基于 EMA 的应用。在本示例中,应用程序名为y。图 11:创建 EMA 应用
-
使用
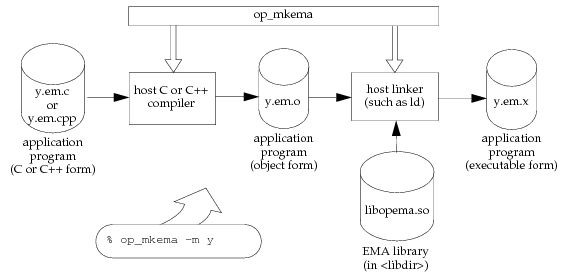
op_mkema工具编译该应用程序并将其与 EMA 库绑定。该工具调用由 comp_prog 或 comp_prog_cpp 环境属性定义的编译器(分别对应 C 或 C++),从而生成应用的 object 代码形式(后缀为.em.o)。comp_flags 或 comp_flags_cpp 的内容被提供给编译器。随后,op_mkema调用由 bind_static_prog 环境属性定义的链接器,将应用的目标代码与 EMA 库组合为最终的可执行形式(后缀为.em.x)。op_mkema选项的完整列表见“op_mkema”(第 178 页)。注: 要在 Linux 平台上使用
op_mkema创建的程序,必须手动设置 LD_LIBRARY_PATH 环境变量。有关设置 LD_LIBRARY_PATH 环境变量的信息,见“Linux 安装故障排除”(第 3 页)。图 12:编译 EMA 应用
-
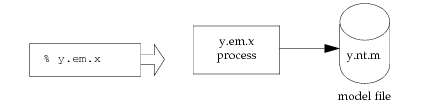
运行应用程序的可执行形式,以创建并写出一个或多个模型,随后可使用 Riverbed 分析软件查看这些模型。在本示例中,创建的是一个网络模型。
图 13:执行 EMA 应用
下图中的 shell 命令序列重演了前述场景,即准备 y 程序及其产生的模型的过程。y 程序生成了其在本场景中所产生模型的指示信息;不过,这并非由 EMA 库自动生成。
图 14:EMA 应用“y”的编译过程
% vi y.em.c
% op_mkema -m y
--- op_mkema issued the following command: ---
	/bin/sh -c cc -c \
	/usr/riverbed/op_models/y.em.c \
		-I/usr/riverbed/sys/include \
		-o /usr/riverbed/op_models/y.em.o \
	> /usr/riverbed/op_admin/tmp/cc_err 2>&1
--- op_mkema issued the following command: ---
	     /bin/sh -c cc \
	       -o /usr/riverbed/op_models/y.em.x \
	          /usr/riverbed/op_models/y.em.o \
	          -L/usr/riverbed/sys/pc_intel_linux/lib \
	          -lema -lsup -lvos -lmdutl -lmdtab -lmdhndl -lobj -lorb -lprg
	          -lsocket -lm -lc /usr/ucblib/libucb.a \
	        > /usr/riverbed/op_admin/tmp/bind_err 2>&1
-----------------------------------------------
Ema executable program (y.em.x) produced.
-----------------------------------------------
% y.em.x